
Appearance
第3章 · 大模型核心数学桥接与符号解码速查
前置要求:建议先阅读 第2章 · 面向大模型的现代 Python 与张量工程底座。本章专为初级工程师梳理大模型所需的 15 个核心数学符号与几何直觉,数学难度严格控制在高中范围内。
本章核心定位与即用即学(Just-In-Time)声明
TIP
初级前端工程师数学解惑声明(代码即数学)
很多开发者对深度学习望而却步,不是因为逻辑复杂,而是被密密麻麻的古希腊数学符号吓退。
数学符号本质上是数学家发明的“极简代码宏”,所有高深公式在计算机里都是数组循环、对象变换与切片投影:
就是前端天天写的 arr.reduce((s, x) => s + x, 0);- 向量点积就是两个数组对应位置相乘再累加,衡量的是语义上的“默契度”;
- 偏导数就是调音台上按住其他旋钮不动、单动一个旋钮对刺耳噪音(Loss)的影响;
- Softmax 就是消除负数后的百分比归一化。
本章唯一使命:一次性建立贯穿全书的核心数学与物理直觉,提供随查随用的符号字典与概念图谱。学完本章,你将自信步入第 4 章手搓自动微分引擎!
本章目标
学完本章核心内容后你能做到:
- 熟练查阅并解释大模型 15 大核心数学符号的读音、高中原型、JS 等价实现与大模型物理意义。
- 用中心差商公式解释数值近似导数与
gradcheck对拍契约,直观解释多变量偏导数与链式法则路径累加机制。 - 手算 2×2 矩阵乘法,解释向量点积与余弦相似度的等价性及其在注意力机制中的物理作用。
- 解释 Softmax 的平移不变性与数值溢出防御原理,口头讲透交叉熵损失与负对数似然(NLL)的数学联系。
- 熟练复述全书最核心的“5 行神经网络训练循环骨架”。
阶段一:深度学习全量数学符号解码字典(15 大核心符号)
IMPORTANT
专为高中数学背景定制的符号放大镜
遇到论文或教材中的公式时,随时翻阅下表对照。只要将数学符号映射为 JavaScript 代码,一切神秘感将荡然无存:
| 数学符号 | 标准读音与名称 | 高中数学原型 / 几何直觉 | JavaScript 代码等价表达 | 大模型中的实际物理意义 |
|---|---|---|---|---|
| Sigma / 求和号 | 数列求和 | arr.reduce((s, x) => s + x, 0) | 矩阵乘法行列加权求和、Softmax 分母累加 | |
| Pi / 连乘号 | 独立事件概率连乘 | arr.reduce((p, x) => p * x, 1) | 自回归模型生成一整句话的联合概率 | |
| Nabla / 梯度算子 | 导数 | { w1: dL_dw1, w2: dL_dw2 } | 汇总全网络所有旋钮该朝哪个方向调节才能降 Loss | |
| Partial / 偏导数 | 导数 | 只改动单个入参时的瞬时变化率 | 调音台上固定其他旋钮,单动当前旋钮对刺耳声的直接影响 | |
| Transpose / 转置 | 沿对角线翻转矩阵 | A[0].map((_, c) => A.map(r => r[c])) | 旋转矩阵行列,使 Key 能与 Query 进行行对列的点积 | |
| Hadamard / 逐元素积 | 两个相同长度数组对应位置相乘 | a.map((v, i) => v * b[i]) | 门控机制(如 SwiGLU 激活、Dropout 掩码过滤) | |
| Matmul / 矩阵乘法 | 批量空间投影与坐标变换 | 嵌套循环对每行每列求点积 | 线性变换全连接层(特征升维、降维与跨通道融合) | |
| Proportional / 正比于 | 存在常数 | y = k * x | 未归一化概率打分(只比大小,省去计算昂贵的分母归一化常数) | |
| Argmax / 极值自变量 | 找出使函数最大的自变量 | arr.reduce((maxI, v, i, a) => v > a[maxI] ? i : maxI, 0) | 贪婪生成采样:从成千上万个 Token 中选概率最大的那个 ID | |
| Expectation / 数学期望 | 按概率加权的平均数 | samples.reduce((acc, s) => acc + s.p * s.val, 0) | 强化学习期望回报 | |
| Logarithm / 对数 | 高中对数函数,把乘法连乘化为连加 | Math.log(x) / Math.log2(x) | 信息熵计算、交叉熵损失、防止连乘浮点下溢 | |
| Frobenius Norm / 矩阵范数 | 高中二维向量模长 | Math.hypot(...matrix.flat()) | 量化网络权重的整体体量,梯度裁剪(Gradient Clipping)防发散 | |
| Softmax / 归一化指数 | 指数拉伸后除以总和 | exp(z_i) / sum(exp(z)) | 将任意正负 Logits 转换为概率和为 1 的概率分布 | |
| Epsilon / 极小正数 | 极限微小量(如 | 1e-5 | 杜绝除以零崩溃(LayerNorm、AdamW 内部的安全保护底限) | |
| Theta / 参数集 | 高中角标变量,在深度学习指全网参数 | { weights, biases } | 整个大模型所有可学习矩阵的统称总代号 |
阶段二:微积分与敏感度分析(第 4 章自动微分地基)
IMPORTANT
第 4 章手写 Value 的直接前置基础
第 4 章实现标量计算图与反向传播,唯一消费的微积分工具就是本阶段的四项内容:
- 中心差商:用于
gradcheck与你手写的反向传播对拍; - 偏导数:多权重下的单个参数责任分摊;
- 梯度向量:所有偏导数打包的建议方向;
- 标量链式法则:复合运算沿路径相乘、分叉路径梯度累加
+=。
1. 导数与中心差商
导数度量的是函数在某点的瞬时变化率。在计算机中,我们使用有限差分中心差商进行数值近似:
例:对于 gradcheck 就是用这个公式作为终极客观真理,来对拍你手写的反向传播梯度——如果两边对不上,说明反向传播闭包公式写错了。
为什么
在线实验 02
中心差商数值导数与对拍演练
中心差商 [f(x + h) - f(x - h)] / (2h) 通过在目标点两侧对称采样,让泰勒展开中的二阶误差项相互抵消,达到 O(h²) 极高逼近精度。滑动下方的步长 h,观察割线如何完美收敛于真实切线。
选择测试函数:
解析切线斜率 (真实导数): 12.000000
中心差商割线斜率 (近似导数): 12.000000
解析真实导数 f'(x)12.00000000通过微积分法则直接推导
中心差商数值导数12.00000000 绝对误差: 2.118e-10
前向差商 (单侧采样)12.00006000 绝对误差: 6.000e-5 (比中心差商大 283235 倍)
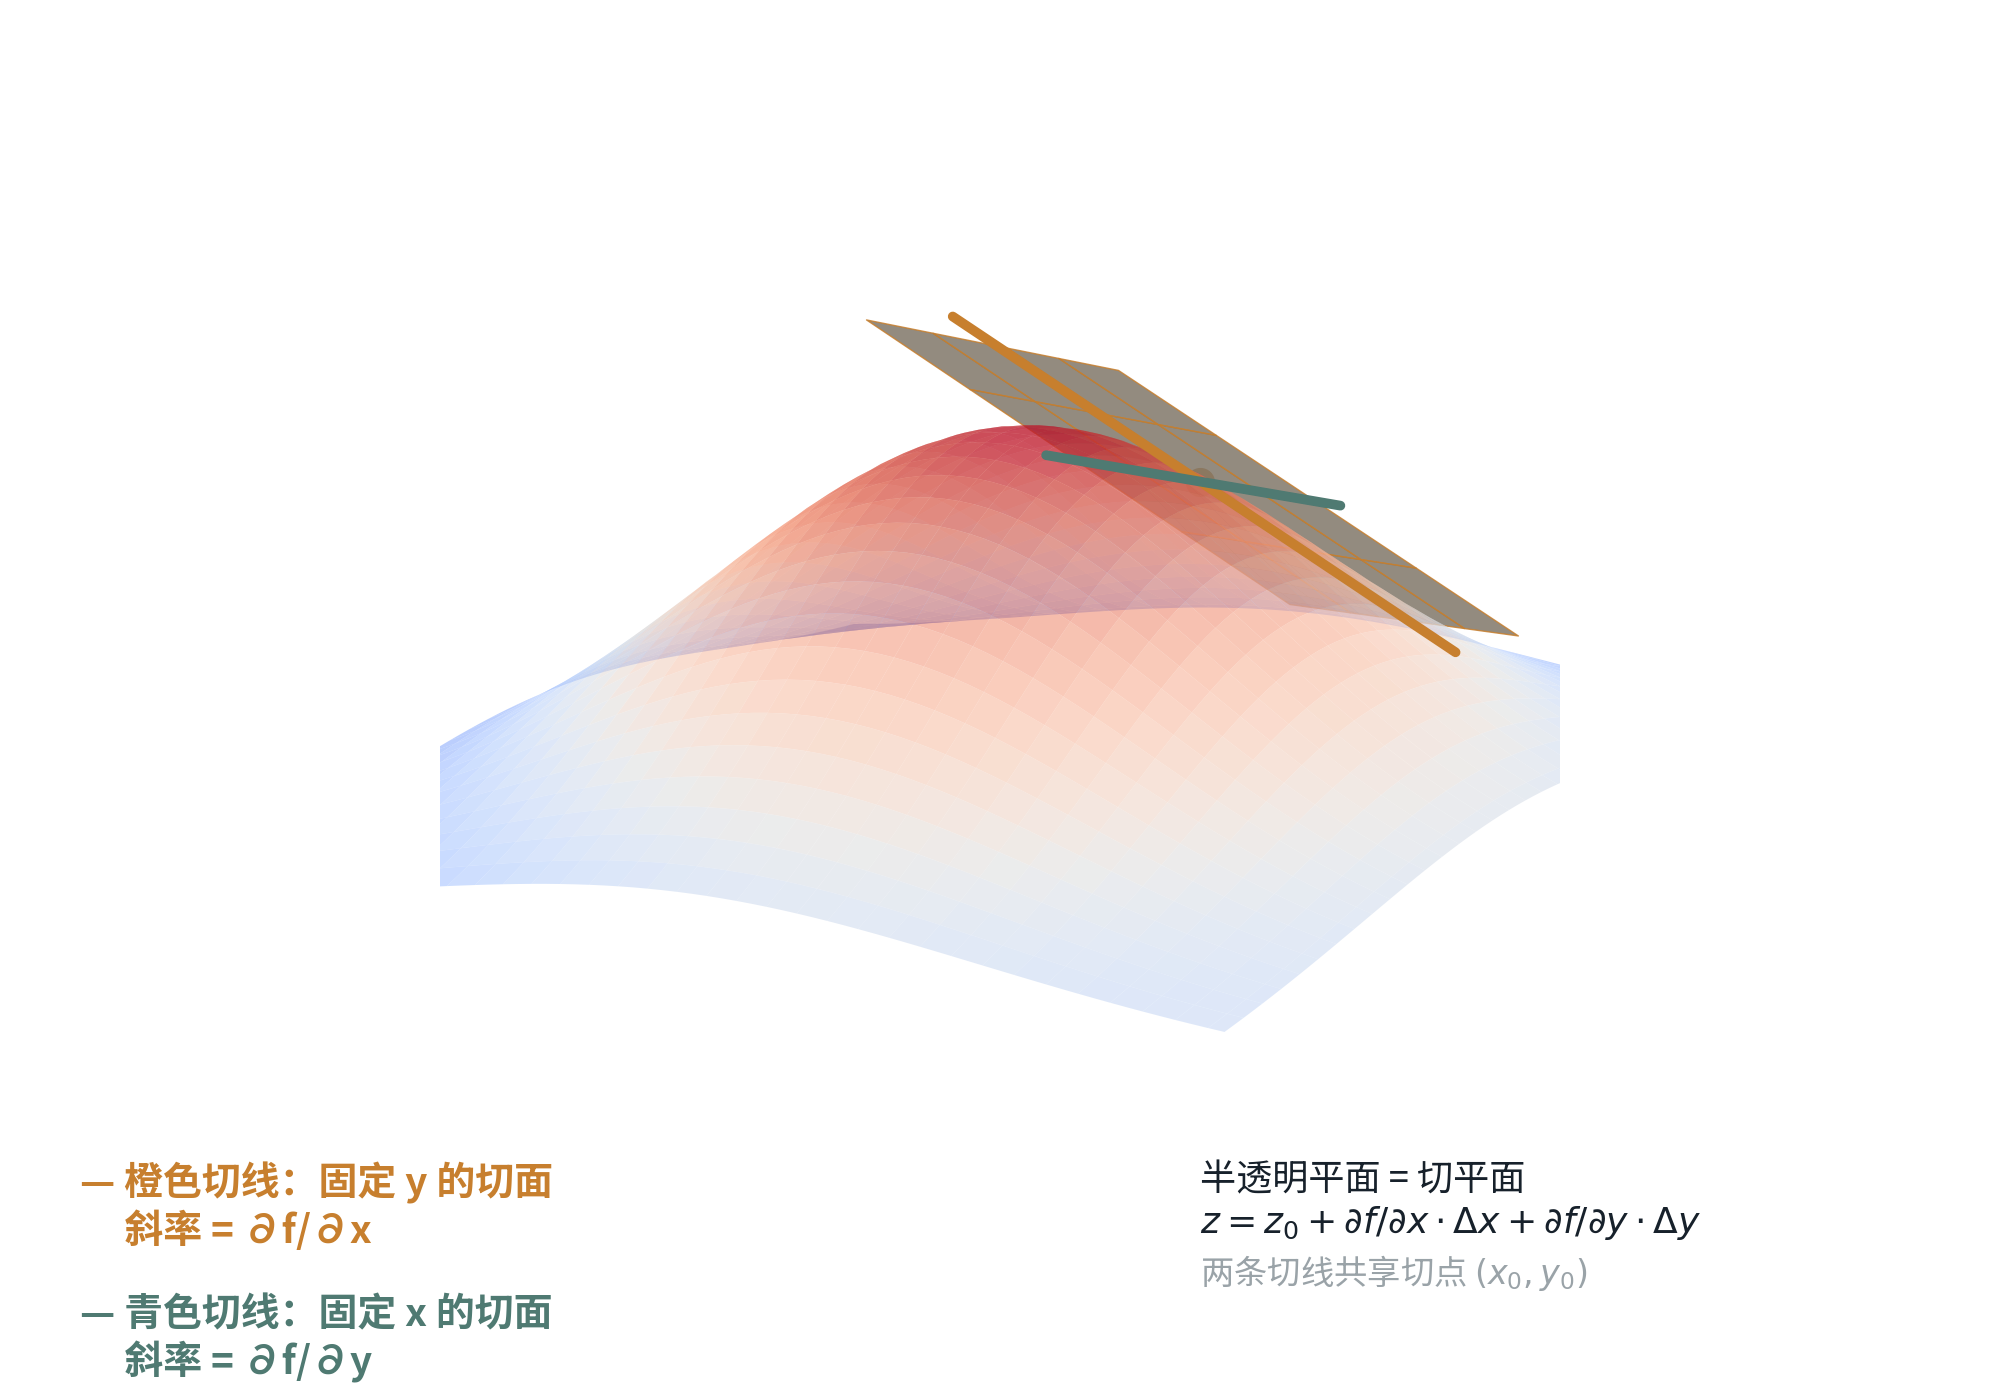
2. 偏导数:固定其他变量,只看当前变量
神经网络的损失函数由成百上千亿个参数共同决定。偏导数就是固定其他所有参数不动,只微调当前参数时,损失函数的瞬时响应:
例:
- 对
求偏导(视 为常数): - 对
求偏导(视 为常数):
几何直觉:曲面切点处的两条切线斜率拼在一起,构成了该点的切平面:
3. 梯度向量
把各个变量的偏导数打包成一个向量,就是梯度:
物理第一性原理:梯度向量的方向永远是函数增长最快(最陡峭)的方向;它的反方向
4. 多变量链式法则与逆拓扑序
对复合函数
IMPORTANT
计算图两大铁律:
- 分叉路径梯度累加
+=:同时经过 和 两条路径影响输出 ,反向传播时来自两条路径的梯度贡献必须相加,绝对不能覆盖! - 反向传播必须严格按照逆拓扑序执行:必须等下游所有消费了当前节点的算子全部传回梯度后,当前节点才能安全地把梯度继续向上传递。
阶段三:线性代数与空间映射(注意力与表征基石)
1. 向量点积与余弦相似度(语义对齐本质)
向量的点积定义为对应分量乘积之和:
变形可得两向量的夹角余弦:
当向量进行
+1.0:方向完全重合,语义 100% 相同;0.0:正交垂直,语义毫不相关;-1.0:方向完全相反,语义彻底对立。
这正是第 8 章 Transformer 注意力
2. 矩阵乘法:批量坐标空间映射
手算 2×2 矩阵乘法,牢记“左行乘右列”:
逐项求值:
Shape 消解铁律:
3. 条件数、病态矩阵与损失地形峡谷
- Frobenius 矩阵范数:
,衡量权重矩阵的总体体量大小。 - 条件数
: - 良态矩阵(
):输入扰动,输出等比例响应; - 病态矩阵(
):几何呈极端细长椭圆。在优化过程中,对应极度险峻的狭长峡谷地形(两侧悬崖极陡,谷底极平缓)。普通梯度下降会在悬崖间剧烈震荡,无法前进——这正是必须引入**动量(Momentum)**与自适应步长(AdamW)的数学原动力!
- 良态矩阵(
4. SVD 奇异值分解与低秩近似(LoRA 与 MLA 的数学根基)
任何实数矩阵
其中:
与 均为正交矩阵( ),分别代表输出空间与输入空间的正交基底旋转; 为对角矩阵,对角线上的奇异值按降序排列: ,代表沿各个主轴方向的几何拉伸尺度。
几何直觉:SVD 表明任何线性变换在几何上都等价于三部曲:空间正交旋转(
IMPORTANT
Eckart-Young-Mirsky 定理(最优低秩逼近定理)
若我们仅保留前
大模型第一性原理映射:
- 为什么 LoRA 能够生效? 自然语言任务中,数千维的大模型权重矩阵虽然在形式上是满秩的,但其有效奇异值谱系呈现出极陡峭的指数级衰减(即“内在维度 Intrinsic Dimension”极低)。因此,第11章 · LoRA 微调 用两个低秩小矩阵
(如 或 )逼近全量微调增量 ,能够以低于 1% 的参数量达成 99% 的全参数微调性能! - 为什么 DeepSeek MLA 能够极限压缩 KV Cache? 第12章 · DeepSeek 架构 的多头潜在注意力(MLA),本质上就是利用低秩投影矩阵将庞大的 Key/Value 状态压缩为一个低维隐向量
,在服务时仅需缓存这一紧凑隐变量,其代数可行性完全建立在低秩流形近似之上。
5. 矩阵微积分:分母布局契约与梯度张量同构
在阅读算法论文与编写 PyTorch 代码时,初学者常因维度转置而困惑。其根源在于数学文献中的两套布局约定:
| 约定体系 | 标量关于矩阵导数 | 典型应用领域 |
|---|---|---|
| 分子布局(Numerator Layout) | 若 | 纯数学分析、控制论 |
| 分母布局(Denominator Layout) | 严格等于 | 机器学习、PyTorch、深度学习系统 |
TIP
深度学习系统的梯度同构铁律
在大模型工程与本书后续所有实现中,一律严格遵循分母布局契约:
为什么必须同构? 考虑梯度下降更新公式:
阶段四:概率统计与信息论速查
1. 条件概率与贝叶斯定理
为先验信念, 为似然证据, 为观测数据后的后验概率。
2. Softmax 函数与玻尔兹曼物理分布
将实数分数 Logits 转换为和为 1 的概率分布:
- 调节参数
就是物理世界的热力学温度: :绝对零度“淬火”,概率坍缩到最大值(贪婪采样); :高温剧烈热运动,所有词概率均等化(随机发散)。
CAUTION
工业级稳定 Softmax:平移不变性与防上溢证明
在 float32 中,inf。 利用平移不变性:分子分母同时除以
取
python
def stable_softmax(z, temperature=1.0):
    scaled = z / temperature
    shifted = scaled - np.max(scaled, axis=-1, keepdims=True)
    exp_z = np.exp(shifted)
    return exp_z / np.sum(exp_z, axis=-1, keepdims=True)
3. 全期望公式(塔式性质 / Tower Property)
类比高中计算全校平均分:先分别算出高一、高二各年级的局部平均分,再按人数比例加权平均。 在大模型强化学习(PPO / GRPO)中,总期望目标可严格拆分为外层抽样 Prompt 与内层抽样模型回答两级独立期望。
4. 信息论核心指标
- 自信息:
(越罕见的事件信息量越大); - 香农熵:
(量化随机变量的不确定性); - KL 散度:
(量化两个分布之间的差异); - 交叉熵损失:
。当标签为 one-hot 时, ,最小化交叉熵等价于最小化预测与真值之间的 KL 散度! - 困惑度(Perplexity):
,直观含义是模型预测下一个词时平均在多少个候选词中纠结。
5. 无偏估计:GRPO 偏置论证的语言地基
用样本数据算出、用来逼近真参数
直觉:单次估计必然受抽样运气影响而偏移,无偏性只承诺"反复采样重算、再取平均,平均意义上恰好落在真值"。全书高频的一批论证全部踩在这个定义上:第11章的"组均值基线不改变期望——无偏"、蒙特卡洛回报"无偏但高方差"、Dr. GRPO 把 GRPO 目标修正为按
6. 方差、协方差与常见分布速查(初始化与 RL 推导的工作马)
| 恒等式 | 内容 | 用在哪 |
|---|---|---|
| 方差计算式 | 第7章 Xavier/He 初始化的方差守恒推导 | |
| 线性变换 | 缩放系数为什么取 | |
| 独立期望分解 | baseline 无偏性论证所依赖的期望线性性 | |
| 协方差 | 独立 |
常见分布三行表(LLM 视角):
| 分布 | PMF / PDF | 期望 / 方差 | 在大模型里它是谁 |
|---|---|---|---|
| Bernoulli( | 单次 eval case 通过与否;mle_bernoulli 的估计对象 | ||
| Categorical( | Softmax 输出层:下一 token 的完整分布 | ||
| Normal( | 量化噪声、扩散过程扰动的标准模型 |
- Jensen 不等式:
为凸函数时 。它是 RL 方差缩减的理论支点——第11章 Rao–Blackwell 论证"条件期望不增方差"用的正是它(策略梯度定理小节)。 - 中心极限定理(CLT)一句话:独立同分布样本均值
随 增大趋向正态 ——"小批量梯度(逐样本梯度的批均值)近似高斯"这一假设的出处,也是第7章把梯度分布当体检对象(训练诊断)的统计前提。
(本小节恒等式与分布表源自 Stanford CS229 VIP cheatsheet 的概率统计 refresher, Amidi & Amidi, 2018;因果推断框架参考 Shalizi Advanced Data Analysis from an Elementary Point of View, 2021;本课按 LLM 场景重新选取与锚定。)
7. 因果推断初步:关联
传统语言模型本质上是关联机器:它从海量文本中学习联合分布与条件分布
然而,当我们要深入大模型内部进行可解释性分析或精准知识修改时,仅观察条件概率就会陷入“相关性不等于因果性”的困境:某个神经元在输出正确答案时高度激活,它究竟是产生答案的因果中介(Causal Mediator),还是仅仅被其他共享特征捎带激活的混杂副产物(Confounder)?
为严谨回答这一问题,现代大模型机理研究引入了 Judea Pearl 的因果图与
- 观测条件概率
:在系统被动运行时,仅仅筛选出输入恰好为 的子样本,观察输出 的分布; - 物理干预概率
:人为切断输入节点 与其所有上游因果父节点的联系,强行将 设为定值 ,观察这种主动干预对下游输出 产生的净影响。
IMPORTANT
第 11 章 ROME 知识编辑的因果推断地基
在 第11章 · 知识编辑 中,Meng 等人提出的 ROME 算法正是利用因果干预
阶段五:优化算法与神经网络原型
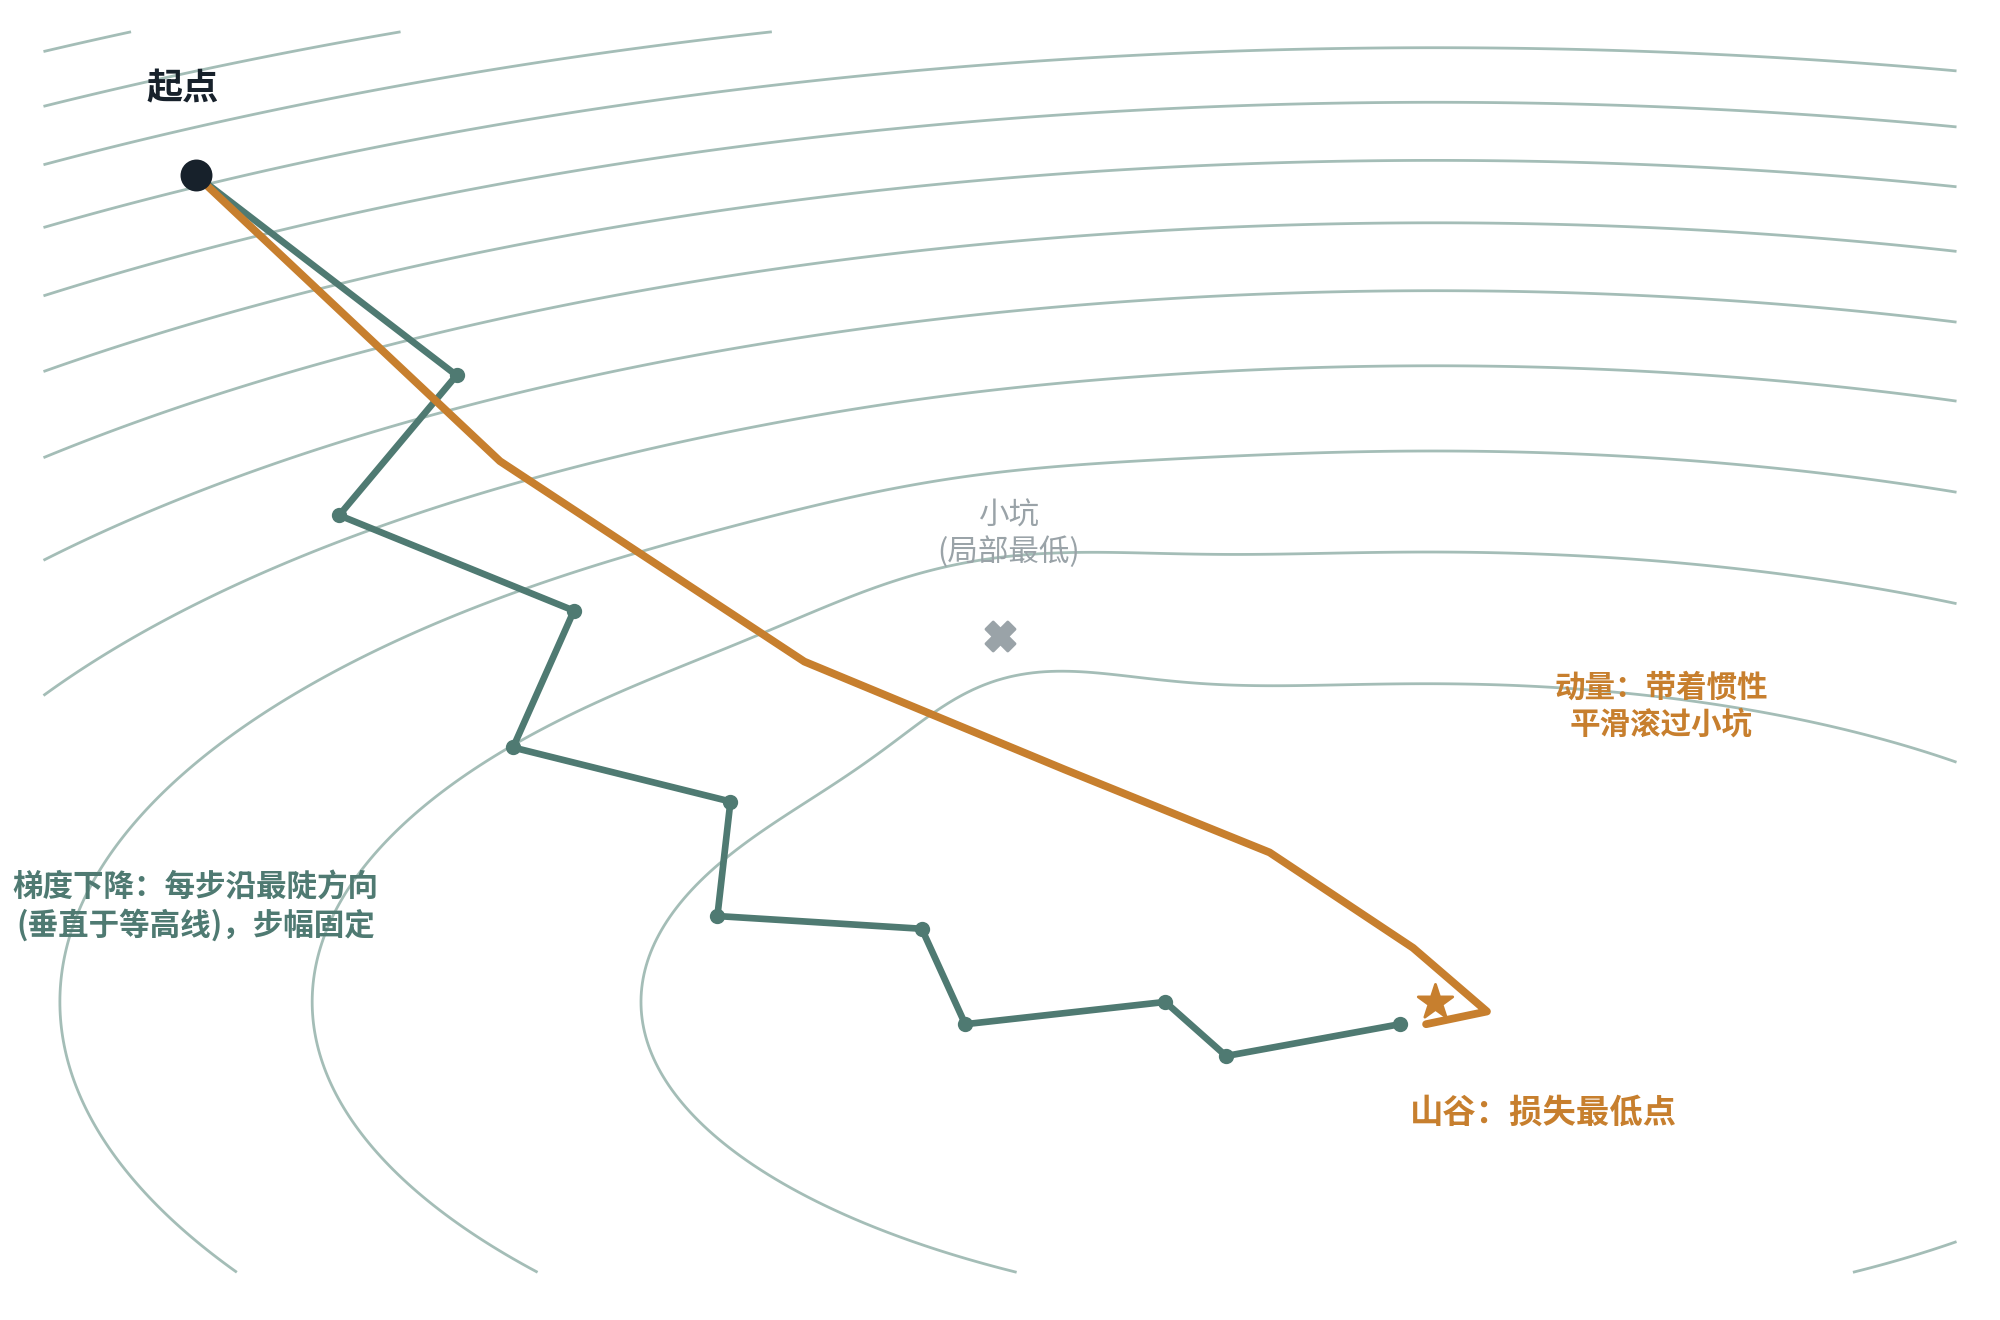
1. 损失曲面地形与梯度下降
沿着梯度的反方向迈步下山。引入**动量(Momentum)**给更新增加物理惯性:
2. 全书最核心的代码骨架:5 行神经网络训练循环
全书所有模型训练最终都浓缩在这 5 行核心循环中:
python
for epoch in epochs:
    logits = model(x)           # ① 前向传播:计算模型预测
    loss = criterion(logits, y) # ② 计算损失:衡量预测与标签的差距(交叉熵)
    loss.backward()             # ③ 反向传播:链式法则自动计算各参数梯度
    optimizer.step()            # ④ 参数更新:沿梯度反方向更新权重
    optimizer.zero_grad()       # ⑤ 梯度清零:防止下一批次梯度错误累加
阶段六:故障排查 / 典型数学报错
在大模型数学计算与算法实现中,以下是最容易踩中的高频数学陷阱:
| 故障注入场景 | 预期报错或异常信号 | 正确修复与防护方案 |
|---|---|---|
| 中心差商步长 | 计算误差大幅发散(>1.0),全是浮点舍入噪声 | 取机器精度平方根级别步长 |
| 偏导数求导时未冻结其他自变量 | 对 | 求 |
| 矩阵乘法行列索引顺序颠倒 | 输出矩阵尺寸颠倒或变成转置矩阵 | 牢记矩阵乘契约:out[i][j] = row_i · col_j |
| 贝叶斯后验概率颠倒先验与似然 | 计算所得概率值 | 严格遵循贝叶斯定理: |
| Softmax 计算未减去最大值 | 输入较大 logits 时产生 RuntimeWarning: overflow 或 nan | 利用平移不变性,计算前先减去张量最大值:z - max(z) |
| 交叉熵或 KL 散度直接计算 | 抛出 ValueError: math domain error 或生成 -inf | 严密添加极小防零偏移:np.log(p + 1e-12) 或过滤零项 |
梯度下降参数更新符号误写为 += | 损失函数 Loss 不降反升,数值指数发散炸裂 | 梯度指向最陡上升方向,下降更新必须为减号: |
| 动量速度向量 | 首轮更新结果不可复现或产生奇异步长 | 将动量张量 SGD(momentum) 对齐 |
阶段七:动手实验与自查验收
实验与测试

推荐规格:Google Pro A100 / L4 GPU (或 CPU)
零算力门槛,本地 CPU 或 Google Colab 免费运行时秒级跑通
💡 运行提示:若本仓库为 GitHub 私有仓库,首次在 Colab 打开时请在弹出的对话框中点击「Authorize with GitHub」授权读取;或直接点击「⬇️ 下载 .ipynb」并在 Colab 中选择「上传笔记本」运行。
bash
cd <仓库根目录>
source .venv/bin/activate
export PYTHONPATH="$PWD/python"

# 运行本章数学核心算法与差商对拍测试
python -m pytest python/tests/test_w0p_python_math.py -k "derivative or chain_rule or bayes or entropy or cross_entropy or softmax" -q
上面的公式在练习文件 python/labs/w0p_exercises.py 里有同名函数:dot_product、chain_rule_2layer、gradient_vector、categorical_sample、mle_bernoulli、entropy、cross_entropy、kl_divergence、gradient_descent_step、momentum_update。后文写「第3章的 mle_bernoulli」这类名字时,指的就是这份练习和本节公式。Softmax 的代码样本在本节,函数名是 stable_softmax;练习文件里没有名为 softmax 的函数。
核心能力自查清单
完成本章后,请对照下表确认心智模型是否建立完毕:
论文与延伸
本章侧重为全书打通数学直觉与符号契约,所涉基础微积分与概率论延伸参考:
- Python 官方教程:数学计算与控制流基础查阅。
- Karpathy 的 micrograd:第4章自动微分引擎的原型参考,本章建立的差商与偏导数直觉将直接服务于
Value的反向传播。 - 全书核心论文与前沿成果速查:后续各章 Transformer、LoRA、MoE 与强化学习的经典原著汇总。
资源 / 成本 / 隐私
本地 Python/NumPy、CPU 即可完成全部数学计算;gross cost 为 0。只用合成数值,不涉及外部数据、账号或隐私信息。
Evidence
仓库当前机器证据(只读快照)
本章机器证据:evidence/02-runtime-v1.json。证明数学基础与差商对拍全绿。本文件已登记进 evidence/module-manifest-v1.json。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。
yaml
schema: learn-llm.evidence.v1
module: 03-math-bridge
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 0
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_w0p_python_math.py -q
metrics:
  - name: exercises_tests_passed
    expected: 36
    actual: <recorded-value>
  - name: exercises_tests_skipped
    expected: 0
    actual: <recorded-value>
  - name: difference_quotient_abs_error_cubic_at_2
    expected: <1e-4
    actual: <recorded-value>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
下一步
进入 第4章 · 自动微分与计算图: 你将把本章学到的类运算符重载、闭包与多元链式法则融会贯通,亲手从零写出微型自动微分引擎 Value,实现全自动反向传播!