
Appearance
第4章 · 从导数到自动微分
前置要求:建议掌握 第2章 的 Python 运算符重载与闭包机制,以及 第3章 的中心差商数值导数直觉。具备这些工程与数学直觉后,本章将带领你从零纯手写实现完整的标量自动微分引擎。
这一章是全书的枢纽:你要手写一个不到 100 行的自动微分引擎。之后所有章节里的"训练",本质上都是它在算梯度。写完之后你会发现,PyTorch 的 loss.backward() 没有任何魔法——它只是把你这章写的东西做成了张量版。
本章目标
学完后你能做到:
- 从空白接口写出
Value类、基础算子、激活函数和拓扑反向传播。 - 解释局部导数、链式法则、叶子节点、梯度累加和反向顺序。
- 用有限差分和一个小型 MLP 证明:梯度正确、参数确实更新、loss 在受控数据上下降。
阶段一:计算图——把公式画成流水线
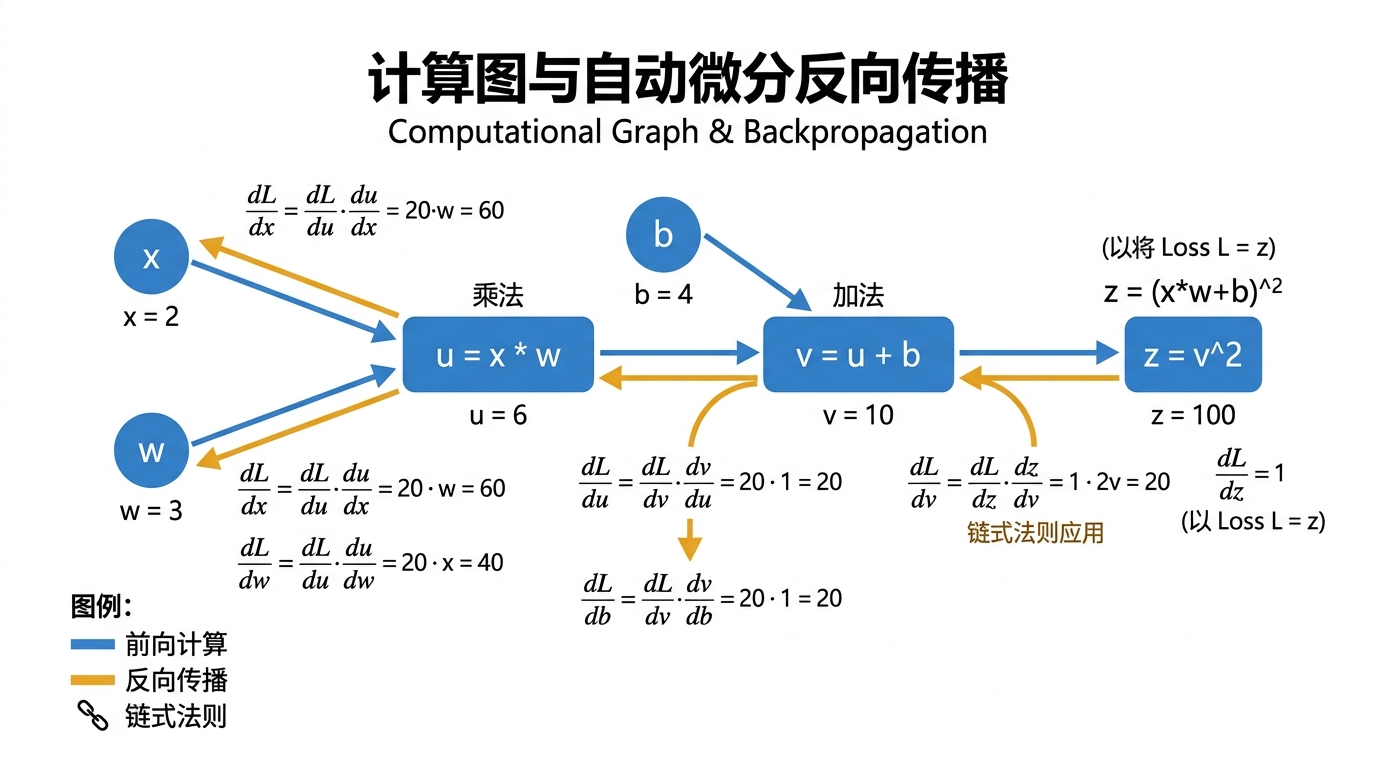
任何公式都能拆成一串首尾相接的基本运算。以
这张图叫计算图:每个节点是一个数值,每条边是一次基本运算。前向传播就是沿着箭头把数算出来:
前端类比:这就是 Vue/React 的响应式依赖图——z 是一个 computed,它依赖 v,v 依赖 u 和 b。数据沿依赖边向下流动,就是前向传播。
阶段二:反向传播——沿流水线倒查责任
训练要回答的问题是:"最终结果是 49,每个输入该负多少责任?"反向传播就是答案:从终点出发,沿边往回走,每走一条边就乘上这条边的局部导数(链式法则):
映射到本章要写的 Value:每个节点对象只存 data 与 grad 两个字段——data 是前向算出的 grad 是反向传来的
鱼书计算图:四大基础算子的局部梯度流动法则
斋藤康毅在《深度学习入门》(鱼书)第 5 章中将复杂微分化繁为简,总结为四大基本计算节点的局部梯度法则:
| 算子节点 | 前向运算 | 局部导数 | 反向传播更新行为 |
|---|---|---|---|
加法节点 + | 原样直通:上游梯度 | ||
乘法节点 * | 交叉对调相乘: | ||
幂运算 **n | 多项式缩放:上游梯度乘上 | ||
| ReLU 激活 | 条件门控:前向大于 0 则无损放行,前向小于等于 0 则梯度截断为 0 |
在上面那张图上实操一遍(从右往左读):
| 节点 | 这条边的局部导数 | 到达该节点的梯度 |
|---|---|---|
| 起点: | ||
可以直接验证:chain_rule_2layer 的图论推广。
深度学习最优雅的求导:Softmax-with-Loss
在第 5 章语言模型与第 9 章 TinyGPT 中,模型的最后一层是 Softmax 激活 + 交叉熵损失(Cross-Entropy Loss)。看似复杂的两层函数,其反向传播却有着惊人纯粹的物理美感:
假设模型对某个词输出的未归一化分数为 Logit
直觉震撼:反向传播回来的误差梯度,恰好等于“模型预测的概率”减去“真实世界的答案”!
- 如果正确答案是第 0 个词(
),模型预测 ; - 传回第 0 个 Logit 的梯度为
(梯度为负,参数更新减去负梯度即增加该 Logit,促使其概率上升); - 传回第 1 个 Logit 的梯度为
(梯度为正,参数更新将压低该 Logit,促使其概率下降)。 预测越离谱,梯度越大;预测越精准,梯度自动趋近于 0。
高中微积分级别的严密代数推导(分步破译)
为什么复杂的商法则与对数求导最后会变成如此纯粹的相减?只需高中导数除法法则即可证明:
第一步:计算 Softmax 自身的局部偏导
已知 ,记分母分和为 : - 当
时(对自身变量求导): - 当
时(对其他分量求导):分子 视为常数,只对分母求导:
合并为克罗内克符号形式:
,其中当 时 ,否则为 。 - 当
第二步:交叉熵损失函数的反向链式传播 损失函数定义为
。根据多变量链式法则,Logit 影响所有的概率 : 其中
。将第一步的雅可比偏导代入: 关键化简时刻——注意中括号里的
与分母上的 恰好完全约掉! 因为
只有在 时才为 1,其余全为 0,所以第一项为 ; 而在第二项中,真实标签的概率和 (One-Hot 向量所有元素和为 1),因此提取公因式得 。 最终结论:
所有复杂的指数与对数在上一步中奇迹般地完全对消,留下了最简洁的预测误差!这就是整个现代大模型训练梯度更新的基石!
为什么要逆序走? 因为每个节点必须先收齐下游传来的梯度,才能继续往上游传——就像质检报告要先到总检,才能分发到各工位。实现上就是先 DFS 收集从输出可达的节点,再按拓扑逆序执行。
关键规则:梯度要累加,不能覆盖。 看 y = a + a:a 是一个共享节点——它通过两条边影响 a.grad = 1),共享节点的梯度就错了。一般形式是:一个节点的梯度等于所有路径贡献之和:
Value 标量值的 shape 契约:
| 对象 | shape | 约束 |
|---|---|---|
标量值 Value.data | () | 一个节点携带一个数值和一个梯度 |
| MLP 输入 | (D,) 或 (B, D) | batch 维不能混入参数维 |
| MLP 输出 | (C,) 或 (B, C) | loss 必须有明确 reduction |
| 有限差分 | 与输入相同 | f(x+h)-f(x-h) 使用同一参数快照;截断误差随 h = 1e-6(python/llm_core/gradcheck.py:10、python/llm_core/autograd.py:176) |
读法示例:标量值 Value.data 表示什么?就是前向传播在这个节点算出的那个浮点数——shape 是 () 的标量,和一个梯度配对存放。
这正是上面那条规则:共享节点被多条路径影响时,梯度必须相加,不能覆盖。
怎么确认你写的反向传播是对的? 用第3章的差商做裁判:固定参数,对每个参数 _backward 闭包写错了——这个对拍流程叫 gradcheck。
交互观察
交互:最小自动微分
y = tanh(x * w + b)
y = 0.000000 ∂y/∂x = 2.000000 ∂y/∂w = 0.500000 ∂y/∂b = 1.000000
拖动滑块时,浏览器里即时重算前向与反向。对应 Python: python/llm_core/autograd.py
拖动 x、w、b,先用链式法则预测输出和三个梯度的变化方向,再看演示验证。浏览器演示只用于建立直觉;真正的证据来自下面的 Python 数值对拍。
阶段三:从零实现 Value
数据模型先行:Value 类的五个核心字段
在编写任何控制流之前,先看清计算图节点的数据图式(Data Schema):
python
class Value:
    """标量自动微分核心节点:前向存数,反向累积梯度"""
    def __init__(self, data: float, _children: tuple = (), _op: str = ""):
        self.data: float = float(data)          # 1. 前向计算出的标量数值
        self.grad: float = 0.0                  # 2. 反向传播累积的局部梯度 dL/d(self)
        self._backward: Callable = lambda: None   # 3. 局部链式求导闭包
        self._prev: set[Value] = set(_children)   # 4. 前驱父节点集合(用于构建 DAG)
        self._op: str = _op                     # 5. 产生本节点的算子标记(调试与可视化用)
具象数据追踪(Trace Frame): 以
text
x: Value(data=2.0, grad=0.0, _prev={}, _op='')
w: Value(data=3.0, grad=0.0, _prev={}, _op='')
u: Value(data=6.0, grad=0.0, _prev={x, w}, _op='*')
当反向传播到达 u 时(假设上游传来 u.grad = 14.0),u._backward() 闭包被触发,执行: x.grad += w.data * u.grad(即 3.0 * 14.0 = 42.0) w.grad += x.data * u.grad(即 2.0 * 14.0 = 28.0)
数据长相清楚了,剩下的就是实现算子与拓扑遍历:
先明确接口边界:Value.__init__ 接收一个浮点数;backward() 驱动梯度沿拓扑逆序传播;每个训练步开始前必须先 zero_grad() 清零旧梯度,否则梯度会跨步累加。grad 初始值为 0,因此第一次调用 backward() 前不需要 zero_grad();但从第二次开始,每次调用前都必须清零,否则梯度会在多步之间累加。接口再简单,也要守住这几条语义。
只依据接口和上面的公式实现
Value.__add__、乘法、幂、tanh/relu、父节点集合和局部梯度闭包。反向时先收集从输出可达的节点,再按拓扑逆序执行;重复调用
backward前明确梯度是否清零。在
python/llm_core/autograd.py的参考实现旁边,写一个独立的 clean-room 小模型,不直接复制参考实现。运行基础回归:
bashPYTHONPATH=python python -m pytest python/tests/test_autograd.py -q用
python/llm_core/gradcheck.py(若当前 checkout 已存在该接口)做多点有限差分对拍;不存在就保持 gate,不拿手算样例冒充对拍。
Clean-room 提交合同
clean_room/autograd.py 是空白接口起点,合同冻结了 Value.__init__(self, data: float) 与 Value.backward(self) 的签名。学习者在私有提交中填写 submission.json 的 modules[]、test_evidence[]、failure_records[]、oral_records[] 和 human_review;实现和测试不得导入 clean_room、llm_core、llm_train 及其包路径。
bash
pnpm clean-room:contract
node scripts/validate_clean_room.mjs --submission /path/to/private-submission
校验只检查提交结构和已保存的测试证据,不执行你的代码,也不判断 clean-room 过程、故障定位或口述质量——合同校验通过的含义是 human-review-required,不是"已掌握"。
阶段四:动手实验
目标:把"计算图、链式法则、梯度累加"从口头说法变成可复现的数值证据。
形状约定先讲清:MLP 实验的输入 X 形状是 (B, D)——B 是 batch 里的样本数,D 是每个样本的特征数;参数矩阵 W 形状是 (D, H),被全部样本共享。batch 维只是"同时算 B 个样本"的并行维,绝不能混入参数维:如果把 (B, D) 错当成参数去求梯度,等于让每个样本各学一套权重,参数共享和泛化就都不存在了。
环境准备
bash
cd <仓库根>
export PYTHONPATH="$PWD/python"
命令与预期输出
bash
# 1) 故障注入回归:4 个故意注入的错误,各自产生预期信号
python -m pytest python/tests/test_clean_room_faults.py -q

# 2) 一键总览:打印 autograd 数值与梯度
python -m labs.run_all
text
clean_room_faults: 4 cases injected, 4 expected signals reproduced
autograd 0.693147 0.9999998

# 判定条件:
# - 共享节点样例的梯度与有限差分误差 < 1e-5
# - MLP 在受控数据上 final loss < initial loss
概念图:本章知识流
故障注入与预期信号
| 故障 | 表现 | 修复 |
|---|---|---|
| 反向时用赋值覆盖梯度而非累加 | 共享节点数值梯度偏小,多路径样例与有限差分不一致 | 把 self.grad = ... 改为 self.grad += ...,多路径误差回到阈值内 |
调用 backward 之前忘记 zero_grad | 第二次反向结果随调用次数漂移,loss 看起来在降其实是累加 | 训练循环开头先清零,并用重复调用测试覆盖 |
| 反向按节点创建顺序执行而非拓扑逆序 | 依赖较深的叶子节点梯度为 0 或符号反掉 | 先 DFS 收集从输出可达的节点,再逆序执行 |
有限差分步长 h 取太小(如 1e-12) | 与解析梯度比较时全是数值噪声(舍入误差主导) | 取 h ≈ 1e-5 至 1e-6;截断误差 h = 1e-6 |
本章验收
- 自查清单全部能答"是":
- 不看资料,完成这四道闭卷解释题:
- 从
z = (xw+b)²画出计算图,闭卷解释x、w、b的梯度如何沿拓扑逆序累加;解释共享节点为什么不能覆盖梯度。 - 手算
对 的链式展开 ,说明它和 autograd 的反向路径完全一致。 - 解释第3章
gradient_vector(f, x, y)和本章Value.backward()的关系——前者一次只算一个点,后者要算出整张图所有叶子的梯度。 - 选一个"有限差分不一致"或"loss 不下降"的故障,说明你先看哪个局部导数、再用数值对拍怎么确认修复。
- 通过条件复核:梯度误差低于冻结阈值、共享节点累加正确、MLP 参数改变且受控 loss 下降。缺少 clean-room 测试、故障前失败/修复后通过记录或实际指标时,本章保持
gate。
论文与延伸
- Learning representations by back-propagating errors(Rumelhart、Hinton、Williams,1986)
- 选读:Karpathy 的 micrograd;只作接口和思想参考,clean-room 作业独立完成。
实验与参考
前端/Agent 迁移
反向传播的思想——"从最终观测沿依赖边回传影响"——在 Agent 工程里对应链路追踪:先记录 event → state transition → derived output 的完整链条,再决定重试或恢复;不能只留最后一条日志,否则定位不了责任节点。
资源 / 成本 / 隐私
本地 Python/NumPy、CPU 即可;预计 gross cost 为 0。只用合成数值和公开论文链接,不涉及账号或隐私信息。
Evidence
仓库当前机器证据(只读快照)
evidence/module-manifest-v1.json 中 03.evidence 指向当前文件:evidence/03-runtime-v1.json。这是当前 checkout 的脱敏机器运行记录,只覆盖该 JSON 记录的命令、指标、产物和已知失败;它不是学习者提交,也不能推出学习者已完成本章。
clean-room 合同的脱敏索引见 evidence/clean-room-submission-index-v1.json。当前索引只证明 7 个 blank interface、提交字段和自动化边界存在,status: gate 且 learner_submission.status: not-provided;它不是学习者实现、测试结果或毕业判定。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。
yaml
schema: learn-llm.evidence.v1
module: 03-autograd
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 1
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_autograd.py -q
  - PYTHONPATH=python python -m pytest <learner-clean-room-gradcheck> -q
metrics:
  - name: finite_difference_relative_error
    expected: <versioned-threshold>
    actual: <recorded-value>
  - name: controlled_mlp_loss_delta
    expected: <versioned-threshold>
    actual: <recorded-value>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
- <sanitized-failure-or-none>标量引擎到张量引擎的桥梁:第5章的 MLP 用纯 NumPy 手写反向传播(micrograd 级别),并不是第4章 Value 的张量版本;第7章才会把标量自动微分升级为张量自动微分。
下一步
进入 第5章 · 字符语言模型与概率目标:把本章的标量梯度接到下一 token 的交叉熵上。