
Appearance
第6章 · UTF-8、byte BPE 与数据管线
前置要求:掌握 第5章 · 概率语言模型与自回归生成 的 Token、条件概率分布与文本切分概念。
第5章的模型以"字符"为单位,但真实世界的文本有中文、emoji、各种符号——字符集大到没法直接查表。本章解决这个前置问题:任何文本先变成一串字节,再把字节合并成数量可控的 token。这就是 BPE(Byte Pair Encoding),GPT 系列的分词器都建立在它上面。
本章目标
学完后你能做到:
- 区分 Unicode 字符、UTF-8 字节、token id 这三层表示,说清为什么要在字节层做分词。
- 手写 BPE 的 pair 统计、merge、训练、编码、解码和词表序列化。
- 对中英混合、emoji、未知字节和特殊 token 做可逆性与边界测试。
- 用分词方法、初始化参数和训练语料说明词表成员,并能对照 StarCoder、DeepSeek-Coder、Code Llama,说清谁在重训 merge、谁只追加哨兵,以及下一代改的是压缩率和原子单位。
阶段一:字符、字节、token——文本的三层表示
同一段文本有三种"数法",必须分清:
| 层 | 例子:"中" | 例子:"hello" | 说明 |
|---|---|---|---|
| Unicode 字符 | 1 个字符(U+4E2D) | 5 个字符 | 人看到的单位 |
| UTF-8 字节 | 3 个字节:E4 B8 AD | 5 个字节 | 计算机存储的单位,每字节取值 0–255 |
| token id | 取决于词表,通常 1–2 个 | [104, 101, 108, 108, 111] | 模型看到的单位 |
为什么在字节层做? 字节只有 256 种,任何语言、任何 emoji、任何乱码都能表示——词表永远不会遇到"不认识的字"。这正是实验输出 bpe [104, 101, 108, 108, 111] hello 的含义:h 的 ASCII 码是 104,e 是 101……在没做任何合并之前,token id 就是字节值本身。
阶段二:BPE 训练——反复合并最高频的相邻对
BPE 的训练规则只有一条:每轮统计所有相邻 pair 的出现频次,把最高频的那对合并成一个新 id:
手算一遍。初始序列是 "aabaab" 的字节 [97, 97, 98, 97, 97, 98]:
第 1 轮:统计相邻 pair——(97,97) 出现 2 次、(97,98) 出现 2 次、(98,97) 出现 1 次。前两名并列,按约定选字典序最小的 (97,97)(Python 元组按元素逐一比较),合并成新 id 256。序列变成 [256, 98, 256, 98]。
第 2 轮:(256,98) 出现 2 次,最高频,合并成 257。序列变成 [257, 257]。
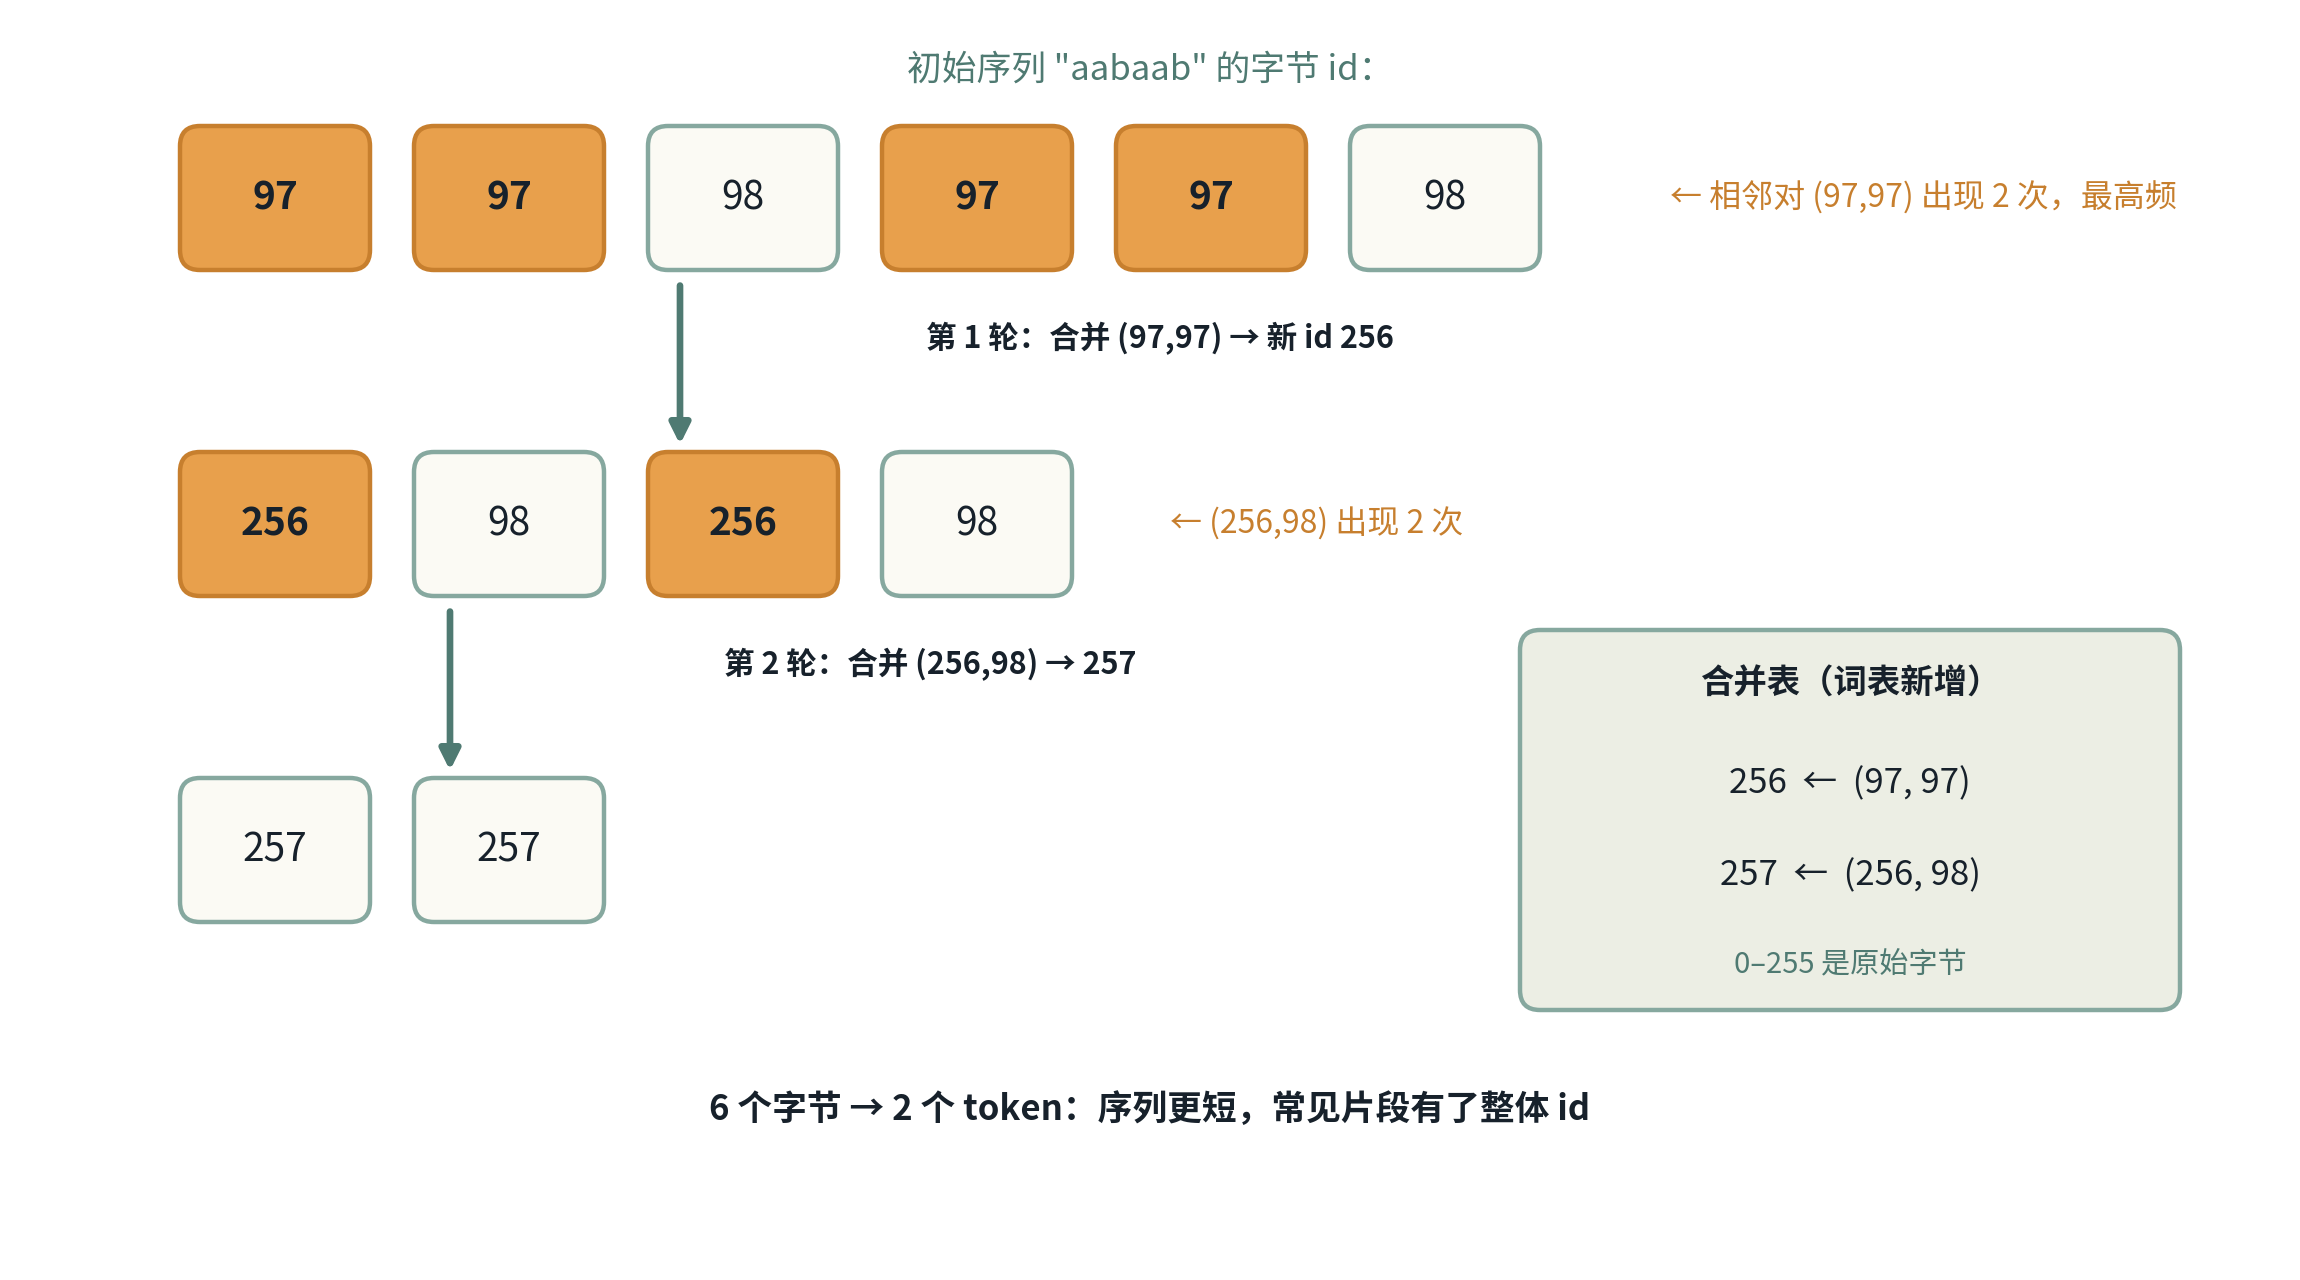
两条铁律就在这个例子里:
- tie-break 必须确定:频次并列时固定选字典序最小者,否则同一语料两次训练会得到不同词表,实验无法复现。
- 词表 = 256 个基础字节 + 特殊 token + 合并出来的新 id,所以
vocab_size必须不小于 256 + 特殊 token 的数量。
为什么这样做有效? 这是第3章熵的视角:高频出现的组合携带的"意外程度"低,值得用一个短码(单个 id)表示;罕见组合保留长码(多个 id)。这和 Huffman 编码"高频短码、低频长码"是同一个思想——BPE 不保证最优压缩,但简单、确定、可逆。
前端类比:BPE merge 就像字体的连字(ligature)——把常见组合 "th" 合成一个字形减少开销;但合并过度会让罕见组合无法表达,所以词表大小是个权衡:词表越大,平均 token 越短,但单个 token 的信息量越分散。这说的是压缩后的平均长度。代码生成指标不随词表大小自动上升,见下文 StarCoder2 与 Dagan 等的结果。
Karpathy minBPE:核心不过 20 行代码
Andrej Karpathy 在其开源的 minbpe 教程中展示了 BPE 算法震撼人心的简洁性——去除工业级边界包裹后,整个训练循环的核心只有两个纯函数:
python
def get_stats(ids: list[int]) -> dict[tuple[int, int], int]:
    """统计相邻连续 pair 的频次,相当于 JS 的 reduce 累加对象计数。"""
    counts = {}
    for pair in zip(ids, ids[1:]):
        counts[pair] = counts.get(pair, 0) + 1
    return counts

def merge(ids: list[int], pair: tuple[int, int], idx: int) -> list[int]:
    """将序列中所有匹配 pair 的相邻两项替换为新 token id。"""
    newids = []
    i = 0
    while i < len(ids):
        if i < len(ids) - 1 and ids[i] == pair[0] and ids[i + 1] == pair[1]:
            newids.append(idx)
            i += 2
        else:
            newids.append(ids[i])
            i += 1
    return newids
整个 BPE 训练循环,就是用 get_stats 找最高频的 pair,给它分配一个新的整数 ID(从 256 开始递增),再调用 merge 刷一遍整个数据集,循环迭代直至达到目标词表大小 vocab_size。本章阶段四的实验就是让你亲手点亮这两个函数!
使用 ChatGPT 或 Claude 时会遇到这些反例:
- 某个已训练词表可能把
strawberry切成str、aw、berry。字母落在 token 内部,模型看不到三个独立的r。 - 把单词倒过来拼写时,字符边界不在 token 边界上,结果会漏字或错位。
- 多位数乘法(如
3849 * 2891)里,数字也可能被打包,进位发生在 token 之间。
模型收到的是 token id,不是逐字符的循环。 没有数字切分器时,12345 可以被 merge 成 [12, 345],甚至整串一个 id。换语料、词表大小或预分词,strawberry 和这串数字的切分都会变。这些反例的共同机制是:模型看到的单位由当时的词表决定。
| 对象 | shape | 说明 |
|---|---|---|
| UTF-8 bytes | (N,) | 每个元素为 0..255 |
| token ids | (T,) | T 取决于 merge 词表 |
| pair counts | Map[(id,id), count] | 每轮重新统计 |
| vocab | Map[id, bytes] | 序列化时固定版本和 special-token 策略 |
阶段三:编码、解码与边界
编码:文本 → UTF-8 字节 → 按 merge 表反复应用合并 → token ids。解码:token ids → 查词表还原字节 → UTF-8 解码成文本。合法性的硬标准:
注意:
decode使用errors="replace"处理无效 UTF-8 字节序列,因此 round-trip 严格成立的前提是输入为有效 UTF-8;非法字节会被替换为 U+FFFD,不满足decode(encode(x)) == x。
特殊 token(如 <|endoftext|>)是硬边界:切分阶段先把它们从文本中隔离出来,merge 只在普通片段上跑——否则特殊 token 会被拆成普通字节 id,边界判断失效。例如,如果 <|endoftext|> 的字节序列能被普通 merge 合成,攻击者可以在文本中嵌入该字节序列,使模型将其误认为控制 token 而非普通文本。
词表成员:方法、参数、语料
每个 id 要么是训练前按参数保留的,要么是算法按语料选出来的。分词方法、初始化参数、训练语料改的是三个不同的集合:方法改选择规则,参数改保留哪些 id、以及哪些相邻关系允许被统计,语料改频次表。
方法决定选谁。 阶段二的 BPE 每轮留下频次最高的相邻对(Sennrich、Haddow、Birch,2016)。另外两条常见规则,在同一份语料、同一个目标大小下,会留下不同的符号:
- WordPiece(Wu 等,2016)同样从初始字母表向上生长,选择标准是提高训练数据的语言模型似然,而不是原始共现次数。Google 没有开源这个训练器。Hugging Face NLP Course 给出的文献重建把一对符号的分数写成「对的频次 /(左符号频次 × 右符号频次)」,并写明这是重建,不是对照过源码的官方实现。编码有两套并不相同的做法:Schuster、Nakajima(2012)沿合并树向下切分,并声称不会产生未登录词;BERT 使用的公开重建只保留最终词表,从词首做最长匹配,一旦无法继续匹配,整个词变成
[UNK],不保留已经匹配的前缀。 - Unigram(Kudo,2018)方向相反。它先准备一份远大于目标大小的种子词表,拟合一元语言模型,再反复删掉「删掉以后似然下降最少」的符号,直到词表缩到目标大小。SentencePiece 的 unigram 模式实现这条裁剪;该库同时能训练 BPE,库名不等于算法。
「算法不同,切出来的粒度不同」说的是结果。原因是目标函数不同:BPE 留下共现最多的对,WordPiece 留下更抬高似然的对,Unigram 按似然损失从大词表里裁剪。
参数决定哪些 id 不进入频次统计,以及哪些相邻关系允许被统计。 三类参数在训练开始前就写死:
vocab_size决定合并或裁剪停在哪里。本章的 byte BPE 还要求它不小于 256 加特殊 token 数,否则字节基表不完整。- 特殊 token(
<bos>、<eos>、<pad>,以及补全哨兵)按声明占用 id。哨兵是事先写定的边界符号,用来标出待补片段的起点或终点,不由 merge 频次产生。上文已经要求把它们从普通片段里隔离,否则它们的字节会被 merge 吃掉。声明了、训练中却不出现的预留 id 同样占词表行,来源仍是参数。 - 预分词(pre-tokenization)在统计相邻对之前先把文本切开,而且不从频次里学。GPT-2 的正则同时切开缩写、字母串、数字串、标点和其他空白;数字串仍可以留在同一个片段里,片段内部再按频次合并,所以
12345可以变成一个 id,也可以变成[12, 345]。只有另外装上数字切分器时,数字才按位断开,不能再靠语料收成更长的 token。本章手写的 byte BPE 默认没有这个切分器。归一化(例如 NFKC,把全角与半角收成同一个码位)若发生在预分词之前,频次表统计的是归一化之后的字符串。无空白文字还要看字母表覆盖率:SentencePiece 的character_coverage按字符频率累加到设定值(库默认 0.9995),覆盖率之外的字符不进字母表,落到<unk>或 byte fallback。本章 byte BPE 以全部 256 个字节为基表,不使用这个门槛。
语料决定频次表长什么样。 同一套 BPE、同一个 vocab_size,代码语料会把缩进、关键字和高频标识符送进词表,散文语料会把词片段送进词表。merge 列表是训练分布的压缩记录。
训练结束后再追加领域 token,是下一小节的词表扩展:它冻结已有 merge,只在末尾加行,不代替上面三项。
代码模型的三种选法
| 模型 | 方法 | 参数 | 语料 | 词表因此包含什么 |
|---|---|---|---|---|
| StarCoder 与 StarCoder2 | byte-level BPE(Hugging Face Tokenizers) | 49,152,含哨兵 token;预分词是数字切分器加上 GPT-2 的正则 | StarCoder 沿用 SantaCoder 的设计在代码数据上训练;StarCoder2 写明分词器训练语料是 The Stack v1 的一个小子集 | 代码分布下的 merge,以及补全用的哨兵(Li 等,2023,§5.3)。StarCoder2 试过把词表加到 100K,指标没有提高,于是保持 49,152(Lozhkov 等,2024,§6.2) |
| DeepSeek-Coder | BPE;官方仓库写明实现为 byte-level,并带专门的预分词器 | BPE 词表长度 32,000。发布的 deepseek-coder-1.3b-base 配置里 vocab_size 为 32256,这是 embedding 表的行数。三个 FIM 哨兵的 id 是 32015、32016、32017,落在这 32,000 之外 | 在其训练语料的一个子集上训练。该语料为 87% 源代码、10% 与代码相关的英文自然语言、3% 与代码无关的中文自然语言 | 由这份以代码为主的分布选出的 merge(§3.2),外加三个 FIM 哨兵(Guo 等,2024,§2;哨兵见 §3.1.2) |
| Code Llama | 不重新训练,沿用 Llama 2 的分词器 | 在 Llama 2 词表上追加四个特殊 token,分别标记 prefix、middle、suffix 的起点,以及 infill 片段的结束 | 学出来的 merge 来自原版 Llama 的分词器;Llama 2 与 Code Llama 都沿用它,不在代码语料上重训 | 词表主体仍是通用文本的子词,代码任务只多了四个控制 token(Rozière 等,2023;Dagan 等,2024) |
Dagan 等(2024)量过这些选择的后果:在源代码上,InCoder 的代码分词器平均比 Llama 分词器少用约 25% 的 token。他们在 1.5B、词表固定 32k 的预分词消融里,预分词同时改变压缩率和代码生成指标;同一 GPT-4 正则、同样是 1.5B 的扫描里,词表从 32k 到 256k,代码指标几乎不动。三份词表各不相同:StarCoder 在代码数据上重训 49,152 的 byte-level BPE,预分词是数字切分器加上 GPT-2 正则;DeepSeek-Coder 重训一份 32,000 的 BPE 词表,再把三个 FIM 哨兵加在这份词表之外;Code Llama 沿用 Llama 2 的词表,只在末尾追加四个 infill token。他们还写到:继续训练已有模型、训练量大约超过 50B token 时,适合更换分词器,并用 Fast Vocabulary Transfer 初始化新的 embedding。这是他们报告的适用条件。
下一代调整这些选择时,直接改变的是压缩率,以及哪些跨度能成为一个原子 id。 Llama 3 使用 128K 词表:其中 100K 来自 tiktoken,另外 28K 用于非英语。相对 Llama 2,英文样本上的压缩率从每 token 3.17 个字符提高到 3.94 个字符,同一训练计算量因此读进更多文本;这 28K 提高了压缩率和下游表现,并且不改变英语的切分(Llama Team,2024)。3.17 到 3.94 说明的是英文样本上每个 token 覆盖更多字符。数字切分决定一串数字能不能合成一个 id。FIM 哨兵只标出补全边界,空洞里的代码仍按原词表切开。词表变大并不自动带来代码指标的上升:StarCoder2 的 100K 试验,以及上面 Dagan 等的 1.5B 词表扫描,都停在这个边界上。
下一代改这些选择,要回答的是压缩率和原子单位:更高的压缩率让同样的上下文和同样的训练 token 预算覆盖更多文本;预分词、归一化和特殊 token 决定哪些跨度是一个 id,哪些 id 不来自频次。
向已训练词表添加新 token
词表训练完成后,工程上还常做词表扩展(vocab extension):领域高频词——代码标识符、产品术语、罕见语言——如果总被拆成 4–6 个 token,会同时拉长序列、稀释每个 token 携带的语义。在已有词表末尾追加少量领域 token 时,按下面三步扩展:
- 冻结已训练的 merge 表,不改变现有 pair → id 映射;
- 把新 token 的 id 追加到现有词表末尾;
- 在 embedding 矩阵末尾新增对应行并随机初始化,后续 checkpoint 必须能容忍额外的行。
Code Llama 追加四个 infill token,走的是冻结 merge、在词表末尾加行。StarCoder 与 DeepSeek-Coder 在代码语料上重训 merge,得到的是另一份词表。Sebastian Raschka 在《Build a Large Language Model (From Scratch)》的配套材料里演示了给现成分词器追加 token 的完整流程。代价同样要看清:词表一变,所有下游 checkpoint 的输入协议随之改变——这正是本课坚持把 tokenizer 版本和 vocab hash 纳入接口契约的原因。
预训练数据管线:从原始互联网语料到 BPE(Stanford CS336 规范)
在将文本交给 BPE 训练与分词之前,真实的工业级大模型预训练(如 FineWeb、RedPajama、Llama 3)必须经历极其严苛的数据提纯管线(Data Curation Pipeline)。斯坦福 CS336 课程(Language Modeling from Scratch)将此总结为四大标准环节:
启发式质量过滤(Gopher 规则):
- 文档长度:过滤掉词数低于 50 或高于 100,000 的异常文档;
- 平均词长:单词平均长度需在 3 到 10 个字符之间,剔除大量无意义字母乱码或未切分的超长字符串;
- 特殊符号占比:符号与单词的比例须低于 0.1,避免大段无序日志与代码 dump 污染纯文本分布;
- 行级重复率:如果某文档中排名前 3 的 2-gram 或 3-gram 占据了全文 20% 以上的频次,说明存在大量机器灌水或模板刷屏,整篇丢弃。
语言模型困惑度过滤(KenLM Perplexity Filtering):
- 在维基百科、精选教科书等高置信语料上预先训练一个轻量级
-gram 语言模型(如 KenLM 5-gram); - 用该模型计算候选文档的困惑度(Perplexity, PPL,定义见第3章):
- PPL 极高:说明词与词之间缺乏正常的语法联系(如 SEO 垃圾词堆砌、乱码);
- PPL 极低:说明文本极度单调重复(如格式化法律协议模版、机械循环的欢迎词);
- 只保留困惑度处于居中高斯分布区间的自然优质文本。
- 在维基百科、精选教科书等高置信语料上预先训练一个轻量级
模糊去重(Fuzzy Deduplication via MinHash LSH): 网页之间存在海量相互转载、镜像站或仅改动一个句子的微修改副本。若重复语料进入预训练,模型会对常见短语产生严重的记忆过拟合(Memorization)。
- 精确哈希的局限:SHA-256 只能判断 100% 逐字相同。只要改动 1 个标点,哈希值就完全改变;
- Jaccard 相似度:将两篇文档切分为
-shingle(如连续 5-gram 集合 与 ),相似度定义为交集比并集: ; - MinHash 定理:对集合元素使用随机哈希函数
,两个集合各自最小哈希值相等的概率,严格等于它们的 Jaccard 相似度: - LSH 桶划分(Locality-Sensitive Hashing): 计算
个独立的 MinHash 签名,将签名切分为 个波段(bands),每个波段包含 行( )。只要两个文档在任意一个波段内哈希完全一致,即落入同一个桶作为候选重复对。 该机制将 篇文档两两比对的 爆炸级开销,骤降为近乎线性的 ,是大规模语料去重的关键算法。
隐私脱敏: 网页、评论和代码注释里会带有邮箱、电话、证件号、精确住址这类能指向具体人的字符串。它们留在语料里,补全时就可能被原样生成出来。脱敏在分词之前把匹配到的片段换成占位符,或把整篇丢弃。这一步不改变 BPE 怎么合并,改变的是这些字符串还在不在语料中。占位符若被声明成特殊 token,它占用的 id 来自参数声明,不来自合并频次。
前端类比: 这与现代前端工程的资源处理管线如出一辙——你绝不会直接把用户在富文本编辑器里粘贴的原始 HTML 塞进生产数据库;而是必须经过 DOMPurify 清洗非法标签,执行规范化去除多余空格与空白换行,跑去重检查,最后才交给 gzip/Brotli 进行最小字节编码。
交互观察
交互:BPE 合并与编解码
raw bytes: 6 token ids: [258, 256, 257] (3 toks) decode: lowest round-trip: OK
合并步骤
merge 1: ("w" + "e") → id 256 ×8
merge 2: ("s" + "t") → id 257 ×8
merge 3: ("l" + "o") → id 258 ×7
merge 4: ("st" + " ") → id 259 ×7
merge 5: (" " + "lo") → id 260 ×6
merge 6: ("st " + "n") → id 261 ×6
merge 7: ("st n" + "e") → id 262 ×6
merge 8: ("st ne" + "we") → id 263 ×6
merge 9: ("w" + " lo") → id 264 ×5
merge 10: ("st newe" + "st newe") → id 265 ×5
改变语料和 merge 次数,检查 token 数、merge 顺序,以及 decode 是否仍与输入完全一致。浏览器里的 round-trip 演示只用于建立直觉,不能替代随机 UTF-8 的属性测试。
阶段四:动手实验
目标:把 tokenizer 从"黑盒调用"变成"看得见的统计过程"。
环境准备
bash
cd <仓库根>
export PYTHONPATH="$PWD/python"
步骤
实现
get_stats、merge,用上面的手算 fixture 验证 pair 计数和 tie-break。用字节序列训练小词表,确保边界 token、未知字节和特殊 token 不被普通 merge 吞并。
实现 encode/decode round-trip,分别测试 ASCII、中英文、emoji 和随机合法 UTF-8。
跑判分与总览:
bashpython -m pytest python/tests/test_bpe.py -q python -m labs.run_alltextbpe [104, 101, 108, 108, 111] hello # 判定条件: # - decode(encode(x)) == x 对纯 ASCII、中文、emoji 都成立 # - 同一语料两次训练,encode('hello') 输出的 id 序列一致 # - vocab_size >= 256 + 特殊 token 数,确保 byte 基表和特殊 token 都有位置
概念图:BPE 训练与编解码流程
故障注入与预期信号
| 注入 | 预期失败信号 | 修复后证据 |
|---|---|---|
| vocab 与 merge 顺序未绑定 | 同一文本在不同运行中 token ids 改变 | 词表/配置 hash 和重放一致 |
按 str 而非 bytes 切分输入 | 中文或 emoji 的 decode(encode(x)) != x | 最底层统一按 UTF-8 字节处理,str 仅在最外层包装 |
| 合并 pair 时频次并列未稳定排序 | 同一语料两次训练得到不同词表,结果不可复现 | 按(频次降序、pair 字典序)稳定排序,两次训练词表一致 |
| 特殊 token 参与普通 byte merge | 特殊 token 被拆成多个 byte id,is_special 判断失效 | 切分阶段先隔离特殊 token,merge 只在非特殊片段上跑 |
vocab_size 小于 256 | byte 基表被合并跳过或 id 缺失,round-trip 失败 | 保证 vocab_size >= 256 + 特殊 token 数,并在训练入口断言 |
本章验收
- 自查清单全部能答"是":
- 不看资料,完成这五道闭卷解释题:
- 用一个中英混合字符串说明 Unicode 字符、UTF-8 字节和 token id 的区别,并闭卷解释一轮 BPE pair 统计、tie-break 与 merge 后序列如何变化。
- 解释特殊 token 为什么不能只靠普通文本替换;给出一种注入失败路径,以及 encode/decode 如何保持边界可审计。
- 用第3章熵的思路解释:同一语料用不同 merge 次数的词表,平均每个 token 携带的信息量为什么不同?
- 说明 BPE 和 Huffman 编码的共同目标,以及 BPE 为什么不能保证最优压缩。
- 用方法、参数、语料说明词表成员。对照 StarCoder(49,152 的 byte-level BPE,预分词是数字切分器加上 GPT-2 正则,设计沿用 SantaCoder,在代码数据上训练)、DeepSeek-Coder(BPE 词表长度 32,000,三个 FIM 哨兵的 id 在 32015–32017,发布配置的
vocab_size是 32256;语料含 3% 与代码无关的中文自然语言)和 Code Llama(沿用 Llama 2 词表,只追加四个 infill 特殊 token)。再说明 Llama 3 在英文样本上把压缩从每 token 3.17 个字符提高到 3.94 个字符改变了什么,以及 StarCoder2 为何在 The Stack v1 子集上试过 100K 后仍保持 49,152。
- 通过条件复核:混合 UTF-8 round-trip、special-token 边界、词表 hash 和来源记录齐全。任一缺失时本章保持
gate。
论文与延伸
- Neural Machine Translation of Rare Words with Subword Units(Sennrich、Haddow、Birch,2016)
- 选读:minbpe;只参考算法边界,独立重写接口。
- 选读:WordPiece 的似然目标见 Google's Neural Machine Translation System(Wu 等,2016,§4.1);公开重建与
[UNK]最长匹配见 Hugging Face NLP Course · WordPiece(2026-10-04 查阅)。Unigram 裁剪见 Subword Regularization(Kudo,2018)。 - 选读:代码词表的三份报告——StarCoder §5.3、StarCoder 2 §6.2、DeepSeek-Coder §2、§3.1.2 与 §3.2,以及官方仓库对 byte-level 预分词的说明:DeepSeek-Coder README(2026-10-04 查阅)。沿用通用词表的对照是 Code Llama。压缩率与词表大小的消融见 Getting the most out of your tokenizer(Dagan 等,2024)和 The Llama 3 Herd of Models。
实验与参考
前端/Agent 迁移
tokenizer 是输入协议而不只是"分词工具":版本、特殊 token、最大长度和 decode 规则都属于接口契约。Agent 的 tool schema、事件格式和持久化状态也一样需要版本与可逆解析,否则上游模型升级会变成隐性协议破坏。
资源 / 成本 / 隐私
本地 Python/NumPy 即可,合成中英/emoji fixture 不产生云费用。只有许可证明确的数据才能进入词表;原始履历、工作文档和私人语料禁止写入仓库。
Evidence
仓库当前机器证据(只读快照)
evidence/module-manifest-v1.json 中 05.evidence 指向当前文件:evidence/05-runtime-v1.json。这是当前 checkout 的脱敏机器运行记录,只覆盖该 JSON 记录的命令、指标、产物和已知失败;它不是学习者提交,也不能推出学习者已完成本章。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。
yaml
schema: learn-llm.evidence.v1
module: 05-tokenizer
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 3
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_bpe.py -q
  - PYTHONPATH=python python <learner-mixed-utf8-roundtrip>
metrics:
  - name: roundtrip_exact_rate
    expected: 1.0
    actual: <recorded-value>
  - name: vocab_hash
    expected: <frozen-hash>
    actual: <recorded-hash>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
下一步
进入 第7章 · Tensor 反向传播与训练稳定性:从标量 Value 走到张量 shape、LayerNorm 和优化器。