
Appearance
第12章 · DeepSeek 架构专题(MLA / MoE / GRPO / R1 / MTP / FP8)
前置要求:掌握 第10章 · RoPE、KV Cache 与量化 的注意力投影与 KV 缓存机制,以及 第11章 · 后训练与偏好对齐 的模型微调方法。
这是第二梯队的专题章:以 DeepSeek 系列(V2/V3/R1)为样本,看一线模型公司如何在真实工程约束下做架构决策。你会沿着四条线走:MLA(KV cache 还能怎么压)、MoE(参数量与算力怎么解耦)、GRPO/R1(推理能力怎么用 RL 训出来)、MTP/FP8(训练还能怎么省)。每条线都有 toy 实验让你亲手复现核心的"记账规则与更新规则"。
所有架构数字以论文与官方开源 config 为准,toy 实现只复现"记账规则与更新规则",不等于工业训练或推理系统。
本章目标
学完后你能做到:
- 沿 MHA → MQA → GQA → MLA 的演进线,手算四种注意力在相同模型 shape 下的 KV 缓存字节数。
- 讲清 MoE 的 router/top-k/负载坍缩问题,区分 Switch 式 aux loss 与 DeepSeek-V3 的 auxiliary-loss-free bias 调整。
- 把第11章的 group normalized advantage fixture 迈半步到 GRPO:命名、公式、KL 项、vs PPO-clip 的对照。
- 概念级讲透 R1-Zero → 冷启动 → 多阶段流程,以及 MTP/FP8 的动机,能把 V3 架构图完整画出并讲"为什么"。
阶段一:MLA —— 从 GQA 到低秩压缩(接第10章)
KV cache 演进线
第10章已经手写过 MQA/GQA:每个 token 每层要缓存的元素数是 KV 体积的全部来源。MLA(multi-head latent attention,DeepSeek-V2 提出)是这条线的下一步:
| 变体 | 每 token 每层缓存元素数 | 直觉 |
|---|---|---|
| MHA | 每个头各存一份 K、V | |
| MQA | 所有头共享一份 K、V | |
| GQA | 头分组共享, | |
| MLA | 存低秩 latent |
MLA 的核心恒等式只有一行:
和第3章的连接:展开后的 attention score 仍然是 dot_product,与向量来源无关。MLA 省的是缓存带宽(576 vs 32768 元素),不是点积本身的计算量。
解耦 RoPE 的取舍:RoPE 的位置旋转作用在 Q/K 上,如果 K 是从低秩
定量算账(先算公式,再上数字)
以 DeepSeek-V3 公开 config 的注意力 shape 为例(61 层、128 头、head_dim 128、kv_lora_rank 512、qk_rope_head_dim 64;bf16 = 2 字节/元素)。MHA/GQA 两列是同头数的假设基线——真实 V3 只实现 MLA:
基线口径说明:上表 MHA 列按 head_dim = 128 计算(K 和 V 都是 128 维),得到 2×128×128 = 32768 元素。DeepSeek-V3 实际的 query/key head dim 是 192(128 nope + 64 rope),value head dim 是 128;若严格按 V3 的 head shape 做同结构 MHA 基线,数字应为 128×192 + 128×128 = 40960 元素。上表采用简化的 head_dim = 128 惯例以匹配第10章 MHA/GQA 的教学口径;对比论文原文时请注意这一差异。此外,论文报告的"KV cache 减少 93.3%"是 DeepSeek-V2 对 DeepSeek 67B 的跨模型口径,不是对同 head 数 MHA 基线的百分比——下表已标注为"论文口径"。
| 变体 | 每 token 每层元素 | 每 token 全模型 | seq=4096 总缓存 | seq=128K 总缓存 |
|---|---|---|---|---|
| MHA(假设) | 2×128×128 = 32768 | 3.81 MiB | 15.25 GiB | 488.0 GiB |
| GQA-8(假设) | 2×8×128 = 2048 | 0.238 MiB | 0.95 GiB | 30.5 GiB |
| MLA(真实 V3) | 512+64 = 576 | 0.067 MiB | 274.5 MiB | 8.58 GiB |
手算验证(以 MLA 为例):kv_cache_bytes_mla 输出逐字节一致。比值:MLA/MHA ≈ 1.76%(约 56.9 倍压缩),MLA/GQA-8 ≈ 28.1%(再压 3.6 倍)。论文口径:DeepSeek-V2 摘要报告 KV cache 相比 DeepSeek 67B 减少 93.3%、最大生成吞吐提升至 5.76 倍(arXiv:2405.04434)。
复述口径(面试用):KV 缓存 = 2(K+V) × 层数 × KV 头数 × head_dim × 序列长 × 批大小 × 每元素字节;MLA 把"KV 头数 × head_dim"这一项整体换成常数 576。
推理杀手锏:矩阵吸收(Matrix Absorption)——为什么推理期可以“零展开”?
很多工程师第一次看 MLA 论文时会有疑问:“既然把 KV 压成了
DeepSeek 极为精妙地利用了矩阵乘法的结合律,让解压过程在推理时“彻底消失”:
1. 核心数学推导(高中矩阵结合律
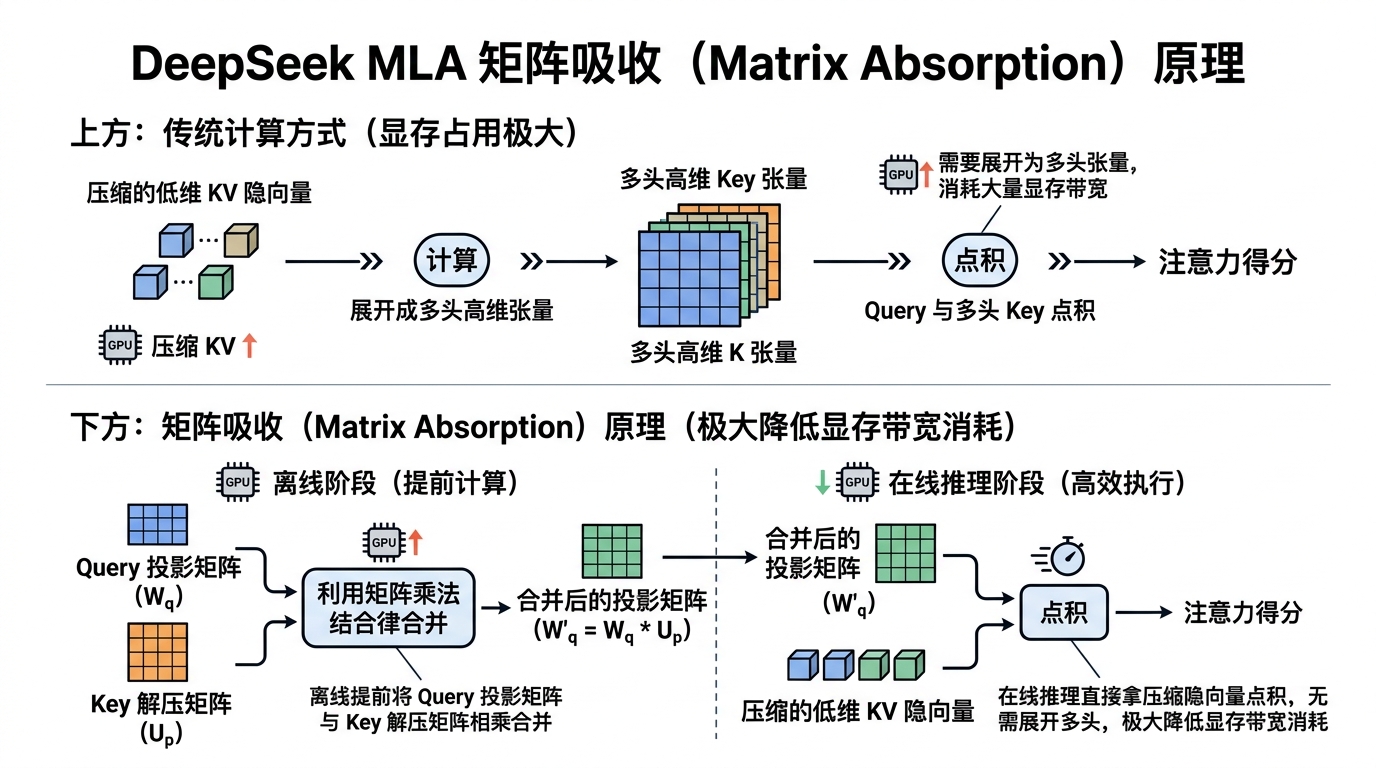
在不含 RoPE 的 nope 分量上,第
观察中间这一项:
此时注意力打分直接简化为:
震撼结论:
- 在推理计算时,历史所有的 Key 向量根本不需要从
展开成 128 头的大张量! - 我们直接拿变换后的 Query,与只有 512 维的压缩缓存
直接点积! - Value 也是同理:各个头的注意力权重先直接加权压缩的
,最后把累加结果过一次 即可。 - 这就是为什么必须“解耦 RoPE”——如果 RoPE 位置旋转矩阵夹在
和 中间,旋转矩阵随位置 变化,就无法提前将 吸收进 中!
text
  在线推理时 (逐 token 动态):
    h_t: (1, d_model)  @  W_Q: (d_model, d_qk)  @  (W_U^K)^T: (d_qk, d_c)  @  c_j^T: (d_c, 1)
                          └──────────────────┬──────────────────┘
                                             │ 矩阵乘法结合律:固定权重离线预先相乘!
                                             ▼
  等价优化后 (只需一次矩阵乘):
    h_t: (1, d_model)  @       W_tilde_Q: (d_model, d_c)           @  c_j^T: (d_c, 1)
YaRN 长上下文扩展(4K
DeepSeek 系列支持高达 128K 的长文本,底层依赖 YaRN (Yet another RoPE extensioN)。为什么不能把位置编码直接除以 32 做线性缩放(Position Interpolation)?
- 线性缩放的硬伤:直接把旋转速度除以 32,虽然上下文容量扩大了 32 倍,但高频通道(周期很短的分量)相邻 token 间的相位差缩得极小,模型直接丧失了区分紧邻单词语法结构的能力。
- YaRN 的频率分治策略:
- 高频分量(微观语法):完全不插值,保持原样外推(Extrapolation),锁死短距离语法和词序感知;
- 低频分量(宏观上下文):进行线性插值(Interpolation),让超长序列平滑映射到基座窗口内;
- 中频分量:通过平滑过渡函数(Ramp function)渐变融合。 配合注意力 Softmax 熵补偿系数,模型无需重新从零预训练,仅需微调即可无损扩展到 128K 窗口。
同一件「把窗口拉长」在不同报告里拨的旋钮并不相同。Qwen2.5 技术报告把 RoPE 基频从 10,000 提到 1,000,000(Turbo 为 10,000,000),预训练后期把长度从 4,096 延到 32,768;推理时再用 YaRN 与 Dual Chunk Attention,大约再给 4 倍长度,并且不改变 32K 以内的行为。Llama 3 的预训练上下文是 8K、基频 500,000,405B 再续训到 128K,这段大约 800B token;该报告没有把 YaRN 写成这次扩窗的方法。Code Llama 把序列从 4,096 微调到 16,384,改的是 RoPE 基频周期,并把它和位置插值那种对频率做线性下缩放区分开(Rozière 等,2023)。
代价与边界
- 低秩展开不是免费的:训练时仍需完整反向传播,工程复杂度高于 GQA。
- MLA 省的是 KV cache 显存与带宽,不是 FLOPs 的大头;attention 计算量本身仍随序列长增长。
- 本课只复现字节数记账,不实现 MLA 的前向 kernel。
交互观察
交互:KV Cache 增量解码
自回归生成时,历史 token 的 K/V 永远不变。缓存它们,把每步的 O(n) 重算降成 O(1)。
KV Cache(每步只追加一行)
| # | token | K | V | attn |
|---|---|---|---|---|
| 0 | <s> | [-0.56, -0.94, -0.14, -0.89] | [-0.10, -0.63, -0.05, -0.85] | |
| 1 | 我 | [0.78, -0.18, 0.69, 0.08] | [-0.26, -0.70, 0.67, 0.42] |
无 Cache(全量重算)Q,K,V 形状 [2, 4]累计行数 3 → O(n²)
有 Cache(增量)Q 形状 [1, 4],KV 读缓存 [2, 4]累计行数 2 → O(n)
输出(两条路径完全相同)[-0.2185, -0.6789, 0.4682, 0.0666]
$$\text{Attn}(q_n, K_{1:n}, V_{1:n}) = \text{softmax}\!\left(\frac{q_n K_{1:n}^\top}{\sqrt{d}}\right) V_{1:n}$$
教学要点:加速的代价是显存 —— cache 大小 = 2 × layers × heads × n × d_head。 这就是长上下文推理「显存爆炸」的根源,也是 MQA / GQA / PagedAttention 要解决的问题。
切换 token 步进观察 Prefill 与 Decode 阶段的显存占用累加。注意观察:在标准 MHA 模式下,KV Cache 随着上下文长度迅速膨胀成“显存巨兽”;而在 MLA 中,所有头的 KV 被整体投影压缩成单个 576 维的隐向量,使得 128K 超长上下文在单卡/小集群部署成为现实。
阶段二:MoE 与路由
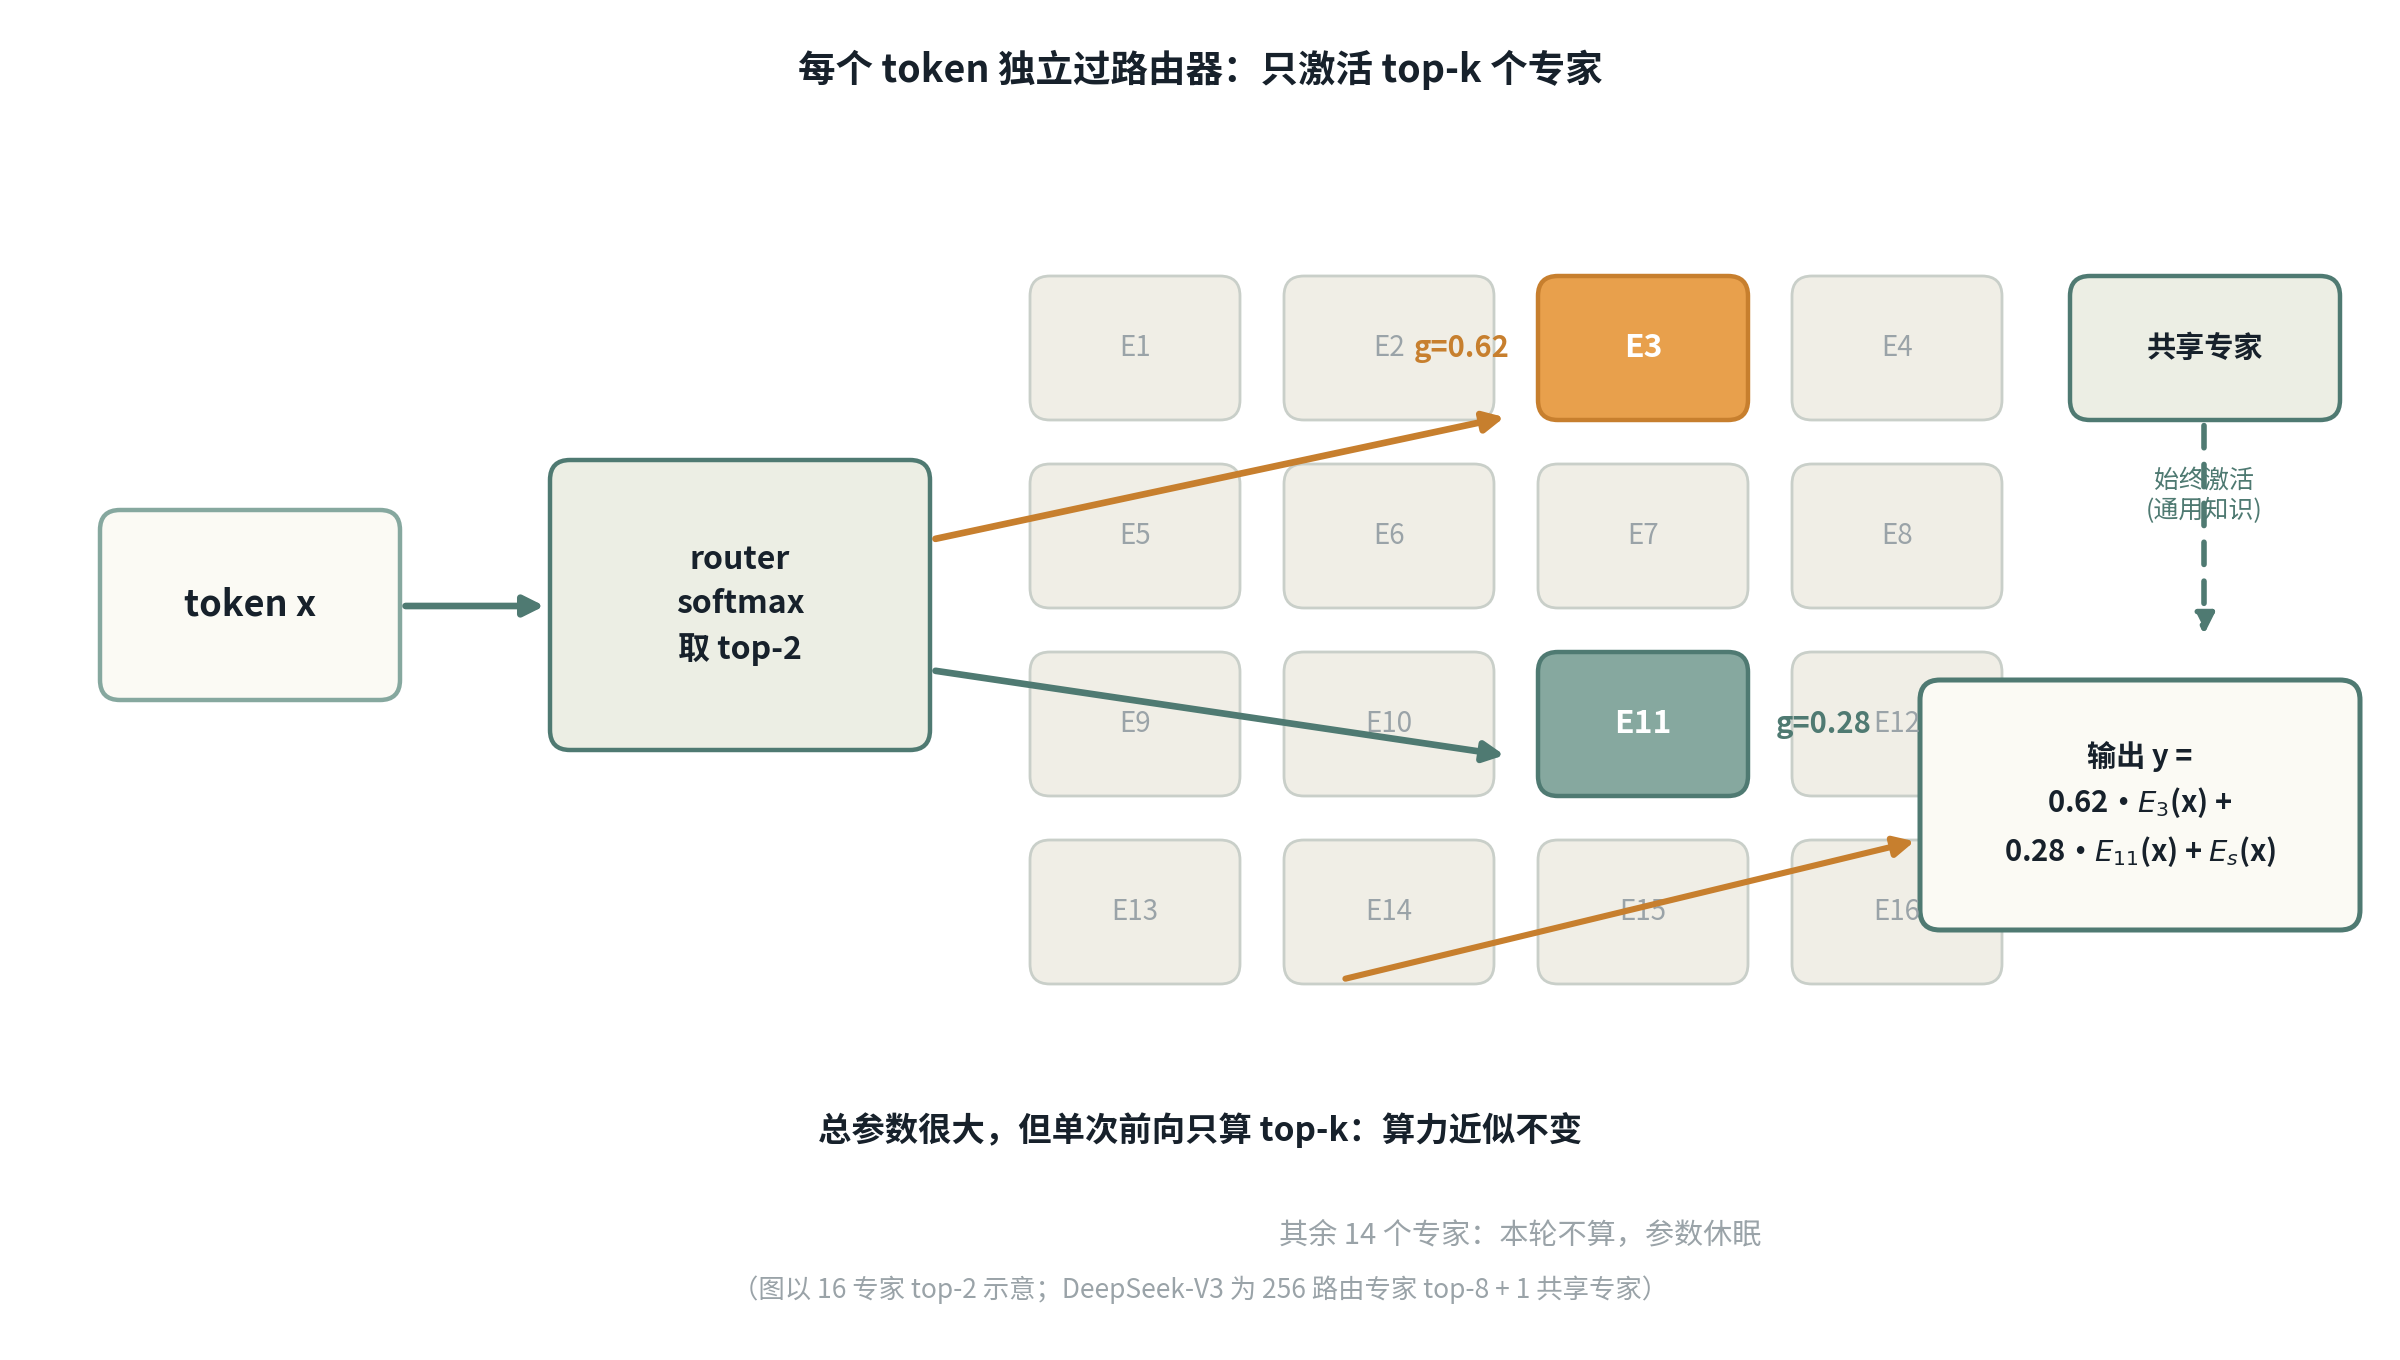
DeepSeekMoE:细粒度专家 + 共享专家
把 FFN 换成
逐符号读:stable_softmax 归一化而来);top-k 是 softmax 的确定性截断——永远选概率最高的 k 个,而不是随机抽样。
前端类比:微前端按路由懒加载——全量代码很大,单次渲染只挂载命中的子应用。边界:MoE 专家之间不共享参数、不通信、没有全局状态——输出只是 gate 加权的线性组合,不像微前端子应用可以读写同一个 global store。
DeepSeekMoE(arXiv:2401.06066)的两个设计:细粒度专家(把专家切得更碎,组合空间更大、专业化更强)和共享专家(固定激活、捕获通用知识,减少路由专家间的冗余)。规模演进:
| DeepSeek-V2 | DeepSeek-V3 | |
|---|---|---|
| 总参 / 激活 | 236B / 21B | 671B / 37B |
| routed experts | 160,top-6 | 256,top-8 |
| shared experts | 2 | 1 |
| dense 前置层 | 1 | 3 |
(来源:V2/V3 论文与官方开源 config。)
负载坍缩与两种解法
无约束的 top-k 路由会自我强化:早期略占优的专家拿到更多 token → 训练更充分 → 更易被选中,最终坍缩到少数专家(其余专家参数浪费、容量白买)。两种解法:
- Auxiliary loss(Switch 式):
, 是路由到专家 的 token 比例, 是 router 概率质量。它度量的是"负载与 gate 偏好的相关性"——负载压在 gate 本来偏爱的专家上时 > 1。代价:辅助梯度直接干扰主任务梯度,权重难调。 - Auxiliary-loss-free(V3):给每个专家加一个只参与选择、不参与加权的 bias
:选谁用 ,算权重仍用原始 score。每步按 调整——超载就降、欠载就升( 是符号函数:正数取 +1、负数取 −1)。没有任何辅助梯度碰模型权重,负载均衡与任务损失完全解耦。
MoE 推理:all-to-all 通信与 expert offloading
训练时 top-k 路由只改变前向路径;推理时同样需要路由,但有一个训练没有的硬约束:被选中的专家可能不在当前 GPU 上。一个 token 的 top-8 专家可能分布在 8 台不同机器上,这带来三个推理特有的工程问题:
- 两次 All-to-All 集合通信瓶颈:
- Token Dispatch(分发):Token 通过 Router 计算得出目标专家后,如果该专家位于其他 GPU,必须通过集合通信将隐藏状态打包发送给目标卡;
- Token Combine(收集):目标卡上的 Expert 完成 FFN 运算后,必须通过第二次 All-to-All 集合通信将结果原路送回输入所在卡,与残差流累加;
- 这种跨节点集合通信是 MoE 分布式推理延迟的主要来源,单步通信量与每个 Token 激活的 Top-K 专家数及隐藏层维度成正比。
- Expert Parallelism(专家并行,EP)与集群拓扑矩阵:
- 在大规模集群中,并行维度通常满足:
; - 在 MoE 架构中,Self-Attention 阶段通常在各卡之间运行 DP Attention(各个数据并行副本独立计算本地 Batch 的注意力);
- 当进入 MoE 阶段时,系统切换为专家并行(EP),专家被打散分布在各卡上,通常配置
; - 优劣权衡:EP 彻底解决了单卡显存装不下全部 Expert 参数的难题(如 V3 的 256 个专家);但代价值得警惕——通信跨出 NVLink 域进入跨节点 RoCE/IB 网络,极易受网络拥塞拖慢。
- 在大规模集群中,并行维度通常满足:
- 落害者(Straggler)与通信重叠工程:
- 负载倾斜拖尾:若某些热门专家分配到的 Token 远多于冷门专家,在 All-to-All 的同步屏障处,所有节点必须停下来等待最慢的那个专家计算完毕(Straggler 拖尾效应);
- 工业对策:除了训练期的 Auxiliary-loss-free bias 动态均衡外,推理引擎常设置 Capacity Factor(容量因子) 截断超额 Token;同时采用类似 DeepSeek DualPipe 的双管道流水线,将 Attention 运算、Dispatch 通信、Expert 运算、Combine 通信细粒度交织重叠(Overlap)。
- Expert Offloading(专家卸载):访问频率低的"冷专家"可以放在 CPU 内存(或 SSD),激活时通过 PCIe/NVLink 拉到 GPU。代价是一次额外传输,但显著降低显存需求——适合专家数极多(如 256)但单请求平均只用 8 个的场景。offloading 策略(LRU、频率阈值)直接影响首 token 延迟。
此外,推理时还常用 capacity factor(容量因子) 限制每个专家每步最多处理的 token 数:超出 capacity 的 token 被丢弃或重新路由(drop and re-route),防止单个专家成为局部热点。capacity 设得过高会导致负载不均,设得过低会浪费专家容量——典型取值为 1.0–1.5 倍均匀分配值。
(来源:DeepSeek-V3 arXiv:2412.19437 §2.3;vLLM MoE 文档;EPLB: arXiv:2410.00061。)
Expert-choice 路由:反过来选
标准 MoE(token-choice)是"token 挑专家";expert-choice 反过来——每个专家自己挑 top-k 个 token。这样负载均衡是构造性的:每个专家每步恰好处理 k 个 token,总负载 = 专家数 × k,完美平衡。代价是:batch 内不同 token 的专家分配数可能不同(有的 token 被 0 个专家选中,需要 fallback);可变序列长度下 prefilling 与 decoding 的 batch 组织更复杂。 Zhou et al. 2022 的原始提案用固定 k 个 token/专家,后续工作(如 LiteMoE)引入容量因子缓解被忽略 token 的问题。
(来源:Zhou et al. 2022, arXiv:2202.09368。)
蒸馏:从大模型的知识到小模型的能力
知识蒸馏(knowledge distillation)是把大模型(teacher)的行为迁移到小模型(student)的标准技术,R1 用它把推理能力教给 Qwen/Llama 小模型。两种主要形态:
- Logit 蒸馏(soft target):student 的训练目标不是硬标签,而是 teacher 对同一输入的完整输出分布,通常加热后(temperature > 1)再算交叉熵。软目标携带了"正确答案附近还有哪些近似正确答案"的信息,比单热标签信息量更大,小模型因此学到更平滑的决策边界。
- Response 蒸馏:直接用 teacher 生成的文本作为 student 的训练数据。R1 的 800k 合成推理轨迹就是这种形态——teacher 模型(R1)对问题产生带思维链的回答,student 在这些响应上做 SFT,无需经历完整 RL 即可获得部分推理能力。
两者的选择取决于场景:logit 蒸馏需要 forward pass teacher,响应蒸馏只需 teacher 的最终输出,部署成本更低但信息量也少。
(来源:Hinton et al. 2015, arXiv:1503.02531;DeepSeek-R1 arXiv:2501.12948 §5.2。)
稀疏注意力:从"少看"压缩注意力(与 MLA 对照)
MLA 压缩的是缓存什么(把 K/V 压成 576 维);稀疏注意力(sparse attention)压缩的是** attend 到哪里**——不是对所有历史位置做完整 softmax,而是用一个轻量 scoring 函数(如 lightening indexer)先筛出 top-k 相关位置,只对这些位置做 attention。计算复杂度从
这是与 MLA 正交的轴:MLA 不减少 attend 的位置数,它让每个位置的 K/V 存储更小;稀疏 attention 不压缩单个 K/V,它减少参与 attention 的位置数。两者可以叠加——DeepSeek-V3 的 DSA(Dual-stream Sparse Attention)就是 MLA + 稀疏模式的组合。
(来源:BigBird arXiv:2007.14062;DeepSeek-V3 arXiv:2412.19437 §2.4 DSA;Gu & Dao 2023。)
KV Cache 量化:缓存带宽的最后一公里
MLA 已经把 KV cache 体积压到了 576 元素/token/层,但 decode 阶段的瓶颈是带宽而不是容量:每次 decode 一步,都要把整条历史 KV cache 从显存读到计算单元。KV-cache 量化直接降低这次读取的数据量,与 weight 量化是正交的维度:
- per-tensor / per-head INT8 或 FP8:把缓存的 K/V 值从 bf16 压到 8 bit,带宽直接减半。per-head 粒度比 per-tensor 更灵活(不同 head 的数值范围不同),但需要为每头存一个 scale。
- KV cache 量化与 FP8 训练量化的区别:后者在训练时保护梯度与累加精度;KV-cache 量化只影响推理时的读取量,量化误差在 attention score 累积时会被 softmax 部分掩盖,但极端情况下仍会导致精度下降。
- 与 weight 量化的叠加:两者可同时启用,decode 带宽 = 2 ×(weight 大小 + KV cache 大小)× bytes_per_element,两个维度同时压缩。
(来源:vLLM KV cache 量化文档;SmoothQuant arXiv:2211.10400;WKV-Quant arXiv:2408.12348。)
GRPO 变体:RLOO / REINFORCE leave-one-out
GRPO 用组内均值做 baseline,去掉 critic;但组内均值只用了当前 prompt 的 G 个样本。RLOO(REINFORCE Leave-One-Out)换了一种去偏方式:对每个回答,baseline 是去掉该回答后剩余 G−1 个回答的均值。效果:每个样本的 baseline 更"个体化",方差比组均值略低,但计算量也略高。REINFORCE 原版则不用组内 baseline,直接用 raw reward 做梯度——方差最大,是 GRPO 与 RLOO 的参照下界。三者的方差排序:REINFORCE > RLOO > GRPO(理论);实际差距随组大小 G 缩小,G=4 时三者的样本效率差异已不明显。
(来源:RLOO arXiv:2308.02282;REINFORCE Williams 1992。)
动手:toy router 观察坍缩与纠偏
python/llm_core/deepseek_toys.py 的 router_balance_experiment 用 2048 个 token、16 个专家、top-2,并给分数加了几何衰减的"专家热度"先验。实测(seed=13,200 步 bias 纠偏):
| 指标 | 无约束 | bias 纠偏后 |
|---|---|---|
| 单专家最大负载占比 | 0.500 | 0.0964 |
| 被激活专家数 | 3 / 16 | 16 / 16 |
| 负载占比 std | 0.1644 | 0.0229 |
| Switch aux loss | 2.8345 | 0.8920 |
注意最后一行:纠偏后 aux loss 低于 1。这不是 bug——bias 纠偏故意把负载推向 gate 不偏好的专家,负载与 gate 质量被去相关,而 aux loss 度量的正是这个相关性。教训:均衡程度要看负载分布本身(max/std),aux loss 只是训练时的一个代理。
阶段三:GRPO —— 从第11章 advantage fixture 迈半步
命名与公式
“PPO 要养一个
第11章的 fixture 已经做过这件事:对一组样例算 baseline = mean(rewards)、centered advantage、normalized advantage(chosen/rejected = ±1.2247)。GRPO(Group Relative Policy Optimization,DeepSeekMath, arXiv:2402.03300)就是把这个记账法命名并放进 RL 目标:
逐符号读:kl_divergence,把策略拴在参考模型附近)。
深入推导:GRPO 组内基线为什么不需要 Critic 还能保持梯度严格无偏?
在强化学习理论中,基线(Baseline)引入的核心诉求是降低方差。为什么可以任意减去一个基线而不会改变策略梯度的期望方向?
根据策略梯度的基本形式:
展开减去
数学结论:只要基线
第11章的 生成过程 把同一组符号放回自回归:状态是已写前缀,动作是下一个 token,中间步的环境奖励为 0,标量分数记在序列结束。整段 REINFORCE 是
GRPO vs PPO-clip 对照表
| 维度 | PPO | GRPO |
|---|---|---|
| baseline 来源 | 学到的 value model | 同 prompt 组内 reward 均值 |
| advantage 估计 | GAE(critic 递推) | 组内归一化 |
| KL 位置 | 通常折算进 reward | 显式项 |
| 组件数 | actor + critic + reward + ref | actor + reward(可 rule-based)+ ref |
| 显存/训练成本 | 高(多一个同规模 critic) | 省一档 |
| 适用 reward | 任意(reward model 打分) | 天然适配 rule-based / 可验证 reward |
rule-based reward 是 GRPO 在推理训练里的天然搭档:数学题答案对不对、代码过不过测试、输出格式合不合规,都能用确定性规则打分,不需要 reward model——这也正是 R1 用的方案。前端类比:rule-based reward 就是确定性测试——Harness 的价值在于把真实任务做成可执行、可观测、可回放的反馈环境。
动手:toy GRPO 更新
grpo_policy_update 在一个 prompt 的 4 个回答上跑 50 步 GRPO 式更新(rewards = [1,0,1,0],模拟"答对/答错"的 rule-based 打分)。实测:
- 组内 advantage = (1, -1, 1, -1),零均值、单位标准差(第11章 fixture 的同款性质)。
- 期望 reward:0.500 → 0.6397;最优与最差回答的 logit margin:0 → 0.5741(chosen/rejected 方向与第11章 DPO 观察一致)。
- KL 对照(6 回答、单赢家、100 步):
时 KL=0.0926、margin=0.9654; 时 KL=0.0810、margin=0.9100——KL 项确实把策略拴在 ref 附近,代价是更新更慢。
边界:这是单 prompt 的 toy 更新,没有 rollout 采样器、没有多 prompt batch、没有真实语言模型——它只证明"组归一化 advantage + clip + KL"这条更新规则的方向性。
GRPO 的偏置与修正:从长度归一化到 Dr. GRPO
GRPO 是当前开源推理训练的主流配置,但它的目标里藏着两处归一化,各引入一类系统性偏置;DAPO 与 Dr. GRPO(2025)是针对它们的修正(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 3)。先把完整目标写出来、把两处归一化点名(KL 项按上文单独加在目标里,此处省略):
其中
长度偏置:短答对错分明,长答惩罚摊薄。 除以
与第11章 DPO 的长度偏置对照阅读:DPO 用未归一化的对数似然求和,每个额外 token 只要有微小正贡献,margin 就能靠拉长篇幅累积——偏置方向是"chosen 越长越好";GRPO 的长度归一化把偏置方向扳成"答错时越长越安全"。机理相反,结果殊途同归地奖励冗长——长度处理是偏好优化与推理训练里反复出现的偏置源。
难度偏置:std 小的题权重被放大。 除以
“既然长度归一化和 std 归一化各带一个偏置——那直接都去掉,代价是什么?”这个想法的形式化是——
Dr. GRPO:去掉两处归一化。 Dr. GRPO(Liu 等,2025)直接删掉这两处归一化:advantage 用
即这个去归一化的更新等于按
组内减均值恰好是 RLOO 中心化项的
命名的诚实注脚。 讲义专门纠正过术语:
顺带:KL 项的两种估计器。 目标里的 KL 项在实现中用逐 token 样本估计。对
DAPO 一句话:同样针对长度归一化的偏置修改了其机制,与 Dr. GRPO 同属"GRPO 发布后的修正族"。讲义自己的提醒值得记录:GRPO 在 LLM 之外的通用性未经验证,也不能断言它是去 critic 路线的最优解——改进它仍是活跃的研究方向。
阶段四:R1 推理训练(概念级)
R1-Zero:纯 RL 能走通
DeepSeek-R1-Zero(arXiv:2501.12948)回答了一个人人关心的问题:不做任何 SFT,直接在 base model 上跑 RL 行不行? 行——在 DeepSeek-V3-Base 上用 GRPO + 纯 rule-based reward(答案准确性 + 格式),AIME 2024 pass@1 从 15.6% 涨到 71.0%(maj@64 达 86.7%),并涌现出自我反思、验证、思考长度自发增长("aha moment")。为什么能成:base model 经大规模预训练已潜伏推理能力,可验证 reward 提供了无噪声的梯度信号,组内相对 advantage 又不需要 critic。
哲学第一性原理:Richard Sutton 的“苦涩的教训”(The Bitter Lesson)与双轴算力扩展(结合 Ernest Ryu 课程导论)
强化学习教父 Richard Sutton 在 2019 年写下了著名的短文《The Bitter Lesson》(苦涩的教训):
“70 年 AI 发展史最沉痛的教训是:人类试图把自己的专业领域知识(规则库、手工句法树、启发式特征)编码进系统的努力,长期来看无一例外都被**直接利用海量算力的通用方法(搜索与学习)**以巨大的代差彻底碾压淘汰。”
DeepSeek-R1-Zero 的突破正是 Bitter Lesson 在大模型时代的绝美复现:
- 学习(Learning):通过海量无监督语料的预训练(Pre-training),把人类世界的全量常识压进几千亿参数的权重中;
- 搜索(Search):推理不是简单的单向文本吐字,而是在巨大逻辑因果图中的路径搜索;
- 传统的 SFT 是人类教模型“你必须按第 1 步、第 2 步思考”,这依然是脆弱的人工启发式;
- R1-Zero 彻底摒弃了人工 CoT 标注,仅给一个判卷规则(答案对+1,错0),让模型在纯粹的算力搜索博弈中,自发涌现出了延长思考、回溯验算、推倒重来的“顿悟(Aha Moment)”行为!
接续:Bitter Lesson II。 Sutton 2019 的原文四年后有了直接呼应:讲义把 Flan 系列(Chung 等,2023)称为 Bitter Lesson II(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 2)——解"跟随任意自然语言指令"这个更一般的问题,反而比逐个解特定任务更能提升特定任务,即第11章 SFT 数据小节的任务多样性发现。同一哲学从单任务尺度延伸到整个 NLU:更一般的解法胜过更专门的手工设计——上文 R1-Zero 用通用判卷规则替代人工 CoT 标注,正是它在推理训练尺度上的再现。
pass@1 与 maj@64 是两种"能力账":pass@1 是单次采样答对率;maj@64 是同一题独立采样 64 次后取多数答案——这正是 self-consistency(自洽性采样)的评估形态,属于推理时扩展(test-time/inference-time scaling):用调用时的额外算力换正确率。它与本章的 RL 训练是两个正交方向:推理时扩展不改权重、按调用计费;RL(GRPO)把"多想几步再答"的能力固化进权重、按训练计费。两组数字不能混着比——86.7%(maj@64)与 71.0%(pass@1)之间的差距,就是推理时算力买来的那部分。
但 R1-Zero 有硬伤:可读性差、语言混杂(中英夹杂),所以有了 R1 的多阶段流程。
RL-first vs SFT-first 取舍
| 维度 | R1-Zero(RL-first) | R1(SFT-first → RL) |
|---|---|---|
| 起始点 | DeepSeek-V3-Base 直接上 RL | 数千条人工长 CoT 做冷启动 SFT |
| 探索自由度 | 高:模型自由发现推理策略 | 受限于 cold-start 数据的覆盖范围 |
| 可读性 | 差:语言混杂、格式不稳定 | 好:SFT 先教会"好好说话" |
| 涌现现象 | 有:自我反思、rehearsal、思考长度自发增长 | 有,但幅度通常更小 |
| 数据成本 | 低:不需要人工 CoT | 高:数千条高质量长 CoT 难以规模化 |
| 适用场景 | 探索新能力、研究 emergent 行为 | 产品化:可读性优先、需要稳定输出格式 |
工程判断口径:如果你的任务有确定性 verifier(数学/代码),且你能接受中英混杂的输出,RL-first 是最小可行路径;如果需要打磨到位的多轮对话体验,SFT-first 的 cold-start 不可省。
(来源:DeepSeek-R1 arXiv:2501.12948 §2.1、§2.2。)
R1 四阶段流程
图:DeepSeek-R1 四阶段训练 pipeline — 从 V3 Base(671B MoE 预训练)出发,先经冷启动 SFT 解决 RL 早期的输出可读性问题,再进入 GRPO 推理导向 RL,然后用拒绝采样生成 ~800k 合成数据做第二阶段 SFT,最后用 rule-based + reward model 混合信号做全场景 RL 收敛到 R1。中间的拒绝采样步骤是"数据飞轮"的关键:RL 发现的推理轨迹反过来生成更多训练数据。蒸馏分支把 R1 的 800k 数据教给小模型(Qwen/Llama),无需完整 RL 即可获得部分推理能力。
- 冷启动:数千条高质量长 CoT 微调,解决 RL 早期不稳定与输出可读性。
- 语言一致性奖励:按目标语言的词元占比给分,治 R1-Zero 的语言混杂(论文承认这会让 benchmark 分数略降,是可读性与能力的取舍)。
- 与 V3 的关系:V3 是 base(架构:MLA + MoE + MTP),R1 是在其上的后训练(RL-for-reasoning);R1 的 800k 数据又能蒸回小模型。
DeepSeek-R1 长思维链蒸馏实战与数学推理数据管线(以 DeepMath 与 Qwen-Math 为例)
DeepSeek-R1 论文的一个重磅结论是:直接使用大模型生成的优质长思维链数据对小模型(如 Qwen2.5-Math-1.5B、Llama-3-8B)进行监督微调(SFT 蒸馏),比在小模型上从头跑大规模纯 RL 更加经济高效。
TIP
直觉对比:为什么小模型直接做 RL 很难,但吃蒸馏数据却能突飞猛进?
参数量较小(如 1.5B ~ 7B)的模型由于参数容量有限,在初始随机搜索空间中极难偶然碰撞出长达数千步的复杂数学证伪与反思链路(在纯强化学习中,小模型极易因反复得出错误答案而始终得不到正向奖励,导致梯度更新陷入停滞)。而 671B 巨型模型凭借庞大的容量已经自发涌现出这种深层元认知行为。将 671B 验证正确的优质思考轨迹作为高质量语料喂给小模型,小模型无需从零在大海捞针,只需直接模仿高水准的解题反思模式,从而在单张消费级显卡上实现惊人的数学推理能力飞跃!
1. 长思维链(Long-CoT)内部元认知行为解构
有效的长推理轨迹绝非简单的无意义注水,而是在 <think> 标签内展现出 5 类可辨识的元认知行为(Meta-cognitive Behaviors):
text
<think>
1. 明确目标与符号解构:设未知量 x,分析几何约束条件...
2. 初次尝试推导:若采用代数展开,可得方程 f(x) = 0...
3. 发现矛盾与显式回溯:等等,如果 x < 0,分母将出现无定义!原方法在边界处失效。
4. 切换备选策略:重新审视对称性,尝试借助柯西不等式构造极值...
5. 最终代入与逆向验算:将求得的 x = 2 代回原方程左右两边,等式严格成立。
</think>
最终答案是 \boxed{2}- 显式回溯词元(Backtracking Tokens):如“等等,重新核验条件……”、“该路径存在漏洞,换一种解法……”;
- 自验证闭环(Verification Loop):在得出结论前主动将候选解代回题干逆向检验;
- 确定性输出槽位(Answer Slot):最终结论强制以
\boxed{...}格式输出,便于外部判定。
2. 蒸馏数据的严苛清洗流水线
在类似 DeepMath-103K 的数学蒸馏工程中,原始生成轨迹必须经历三道严苛质量门禁:
- 确定性规则验证器(Rule-based Verifier)过滤:对于数学与代码任务,使用 SymPy 符号计算库或 Python AST 执行环境校验
\boxed{}中的答案。只有最终答案 100% 吻合标准真值(Ground Truth)的轨迹才进入候选池,绝对禁止将带逻辑毒素或虚假结论的轨迹喂给小模型; - 死循环与过度思考(Overthinking Loops)消除:监控轨迹中的 N-gram 重复率与词元步数,剔除在同一步骤无限循环自问自答的退化样本;
- 上下文边界与截断管理(Cutoff Management):长思维链通常消耗 4K–8K tokens,训练序列长度必须完整容纳从“提出假设”到“最终验算”的全过程,避免因半途截断导致模型学到“只有反思没有结论”的残缺行为。
3. 行为模仿(Behavior Cloning)vs 强化探索(RL Search)的科学边界
小模型通过 SFT 蒸馏获得了长思维链的“行为外表”与常见解题策略,并在同分布数学基准上表现优异。然而必须保持清醒认知:
- 蒸馏学习本质是条件概率拟合:小模型主要复现了教师模型的高频反思模式;
- 当面对超出教师分布、解空间极其幽深的未知新问题时,小模型由于未经历自主策略空间的奖励驱动试错(RL Exploration),依然难以自发涌现跨领域的“顿悟(Aha moments)”。
- 这确定了工业分工原则:超大基座模型承担算力密集型的强化探索与高质量轨迹生成,中小模型通过高信噪比蒸馏 SFT 承接确定性场景的低成本落地。
测试时计算扩展(Test-Time Compute, TTC)与自我校正的科学边界
在 DeepSeek-R1 与 OpenAI o-series 掀起推理大模型革命后,AI 领域建立起了一个全新的理论共识:模型能力的提升不再仅仅依赖预训练阶段堆砌参数和数据(Pre-training Scaling),而是开辟了第二条全新的算力扩展轴——测试时计算扩展(Test-Time Compute Scaling)。
UC Berkeley CS294-280 (Spring 2025) 前沿讲座中,Xinyun Chen(Google DeepMind,L01)与 Jason Weston(Meta FAIR,L02)对这一范式的深层机制与物理边界给出了极为深刻的解剖。
1. System 1 直觉模式 vs System 2 慢思考规划
人类认知心理学(丹尼尔·卡尼曼《思考,快与慢》)中的双系统理论是大模型推理演进的第一性原理映射:
- System 1(快思考 / 直觉单步):
- 标准自回归 Transformer 的传统生成模式——根据输入 prompt 单向自左向右逐 token 吐字。
- 计算预算固定绑定于输出序列长度,缺乏全局推演和回头审视。对于“法国的首都是哪里”,System 1 可以瞬间检索参数记忆输出“巴黎”;但对于高难度数论题或多分支算法设计,模型如果在前两个 token 选错了推导路径,后续自回归惯性就会一错到底,发生致命的幻觉与逻辑雪崩。
- System 2(慢思考 / 推理搜索):
- 将问题求解视为在巨大逻辑因果图或解空间中的路径搜索(Search in Reasoning Space)。
- 允许模型在输出最终答案前,消耗额外的测试时计算预算(Test-Time Compute),通过长思维链展开假设、代入验算、局部证伪与回溯纠错。
2. 三种测试时计算扩展(TTC)范式与扩展律(Xinyun Chen, Google DeepMind)
根据探索机制与搜索拓扑,测试时计算扩展可系统性归纳为三大路径:
| 维度 | 1. 并行采样与投票扩展 (Best-of-N / Self-Consistency) | 2. 序列修正扩展 (Sequential Revision / Self-Debug) | 3. 树搜索扩展 (Tree Search: MCTS / PRM-guided) |
|---|---|---|---|
| 核心机制 | 同一 prompt 在高温度下独立采样 | 生成初始解答 | 将推理链拆为步骤节点,利用过程奖励模型(PRM)预测每步胜率,执行状态回溯(Backtracking)与动态剪枝 |
| 计算扩展特征 | 随采样量 | 随调试轮次 | 理论计算效率最高:在错误发生的最早步骤及时剪枝,避免在死路分支浪费数百 token |
| 纠错介入时机 | 事后筛选:中间过程完全黑盒,单个回答哪怕只在最后一步算错,整条回答全部作废 | 轮次迭代:每轮完整执行后介入,针对环境反馈精准局部修补 | 即时前瞻 (Lookahead):在步骤推演的第一时间介入评估与截断 |
| 对验证器的依赖 | 依赖最终答案比较器或 ORM 打分器 | 极度依赖外部真实执行环境(编译器、沙箱、断言) | 极度依赖高精度过程奖励模型(PRM) |
| 工程落地复杂度 | 极低:天然支持批处理(Batching)与分布式吞吐并发 | 中等:需要安全的沙箱执行隔离环境(如 Docker/Wasm) | 极高:步骤粒度状态树的并发管理、KV Cache 动态分支共享难度极大 |
| 工业代表代表 | OpenAI maj@64, DeepSeek 评估基线 | Google DeepMind Self-Debug, SWE-bench Agent 管线 | OpenAI o1/o3 内部推理引擎, AlphaGo/AlphaProof 衍生路线 |
TIP
白盒代码支撑:测试时搜索与过程奖励(PRM)
在 python/llm_core/test_time_compute.py 中,我们给出了可直接运行的 TestTimeComputeSearcher 与 ProcessRewardModel:
- 逐步 PRM 打分:
score_step()为思维链中的每一个推理步骤输出置信度; - Best-of-N 候选重排:支持按全链路平均 PRM 得分与累积对数概率重排,自动剔除逻辑漏洞;
- 步骤级 Beam Search 动态剪枝:在生成第
步时即刻计算 PRM 得分,及早剪掉失败分支,无需等待整条长轨迹跑完才判定。
budget forcing:把思考长度做成显式接口。 三种范式之外还有一个不用训练就能拧的旋钮(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 3):s1 系模型展示的 budget forcing 支持双向操控。调低:在生成中途强行插入 "Final Answer:" 前缀,逼迫模型立刻收尾作答;调高:删掉已写出的答案、在答案前插入 "Wait" 诱导模型继续推敲。两个方向都确实改变准确率——测试时算力成了一个连续可调的推理参数。后文 R1-Zero 独白里那一连串自发出现的 "Wait" 说明推理模型自己在训练中学会了同款操作;budget forcing 只是把同一机制从权重里拿出来,交给推理引擎显式控制。
算力换 ELO 的经验换算律。 测试时搜索的杠杆有多大,有一条常被引用的经验律(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 1):约 +120 ELO ≈ 训练算力翻倍,或测试时搜索量翻倍——训练轴与测试轴在同一把尺上可比。由此可以校准量级感受:裸策略网络要超过人类棋手,粗估需约 1000 倍训练算力;要超过带完整搜索的 AlphaGo Zero,粗估需约 100000 倍。这组数字是 TTC 成为独立扩展轴的定量注脚(RL 基础参考页的 AlphaGo 消融小节保留"千倍"口径的一句)。
树搜索为什么不是"提前解完整盘棋":可达性。 对树搜索的一个常见质疑是"minimax 原则上可解,何必逐局搜索"。辩护的关键在可达状态(化用自口头讲解):围棋的一局只访问状态空间的极小子集——已经走过的历史、被提掉的棋子,都使大量配置从当前局面出发不可达;树搜索不预解整个游戏,只解当前局面的可达子集,且按需解——对手实际走出哪一步,才展开哪一支。预解全空间等于把算力花在永远到不了的局面;TTC 的成本只落在真实路径上。
3. 自我校正(Self-Correction)的现实局限与成立边界(Jason Weston, Meta FAIR)
很多研究者和开发者抱有一个朴素幻想:“大模型既然有思维链,我们在 Prompt 里加一句‘请你仔细检查上面的推导并修正错误’,它不就能自动纠错了吗?”
Meta FAIR 的核心科学家 Jason Weston 等人通过大量严苛的对照实验,打破了这一盲目乐观的“内在自校正(Intrinsic Self-Correction)神话”:
A. “无外部真实信号的内在自校正”是一个危险的伪命题
- 过度自信与盲目确认(Overconfidence Bias): 大模型并不是神仙。如果同一个参数模型在第一次生成时,由于预训练知识缺陷或推理深度不足给出了错误答案,当要求它用同一个参数网络去审视自己的回答时,它依然受到同一种概率先验的支配。实验显示,模型有超过 80% 的概率坚信自己最初的答案是完全正确的,甚至会编造出一整套逻辑来论证错误答案的合理性。
- 改错退化现象(False Correction Degradation): 更糟糕的是,当强制模型进行反思重审时,模型在随机温度扰动下,常常把原本第一次答对的题目硬生生“改错”!在缺乏客观真值裁判时,单纯的多轮内省非但不能提高准确率,整体性能反而往往净下降。
B. 自校正成立的充分必要条件:必须引入外部客观锚点
自校正绝不是模型“闭门思过”自发产生的,它必须且只能在以下三种场景下成立:
- 环境执行反馈闭环(Execution Feedback): 在代码编写中,Python 解释器抛出
IndexError,或者单元测试断言失败。此时模型面对的是不可否认的物理事实,自调试(Self-Debug)闭环才能明确知道“第几行报错、错误类型是什么”,从而完成 Patch 生成; - 确定性判据规则(Deterministic Ground Truth Verifier): 在数理领域,外部符号计算系统(如 SymPy)能精确断言两个代数表达式是否等价;
- 与生成策略解耦的高保真过程奖励模型(High-Fidelity PRM): 一个经过严格对齐、不与策略共谋的独立打分网络,能在关键转折点提供置信度暴跌的告警信号。
C. DeepSeek-R1 涌现“Aha Moment”与自我回溯的底层科学本质
在看懂了 Weston 与 Chen 的理论后,我们就能彻底看透 DeepSeek-R1-Zero 顿悟时刻(Aha Moment)的本质:
- 为什么 R1-Zero 在没有任何人类示范的情况下,会在长文本里写出:
"Wait, wait, wait... let me reconsider this step. If x = -1, then the denominator becomes 0, which contradicts the initial condition. Let me backtrack and check alternative factorization..."
- 科学解释: R1-Zero 的反思绝非模型产生了人类哲学意义上的反省心理。在基于规则的可验证强化学习(RLVR)中,只要最终答案算错,整条长序列获得严苛的 0 分惩罚。 在千万次的 GRPO 采样中,模型探索过无数路径。偶然几次,基座模型在探索中触发了某种“代入特值检验”的局部模式,及时中断了错误推演并成功转向正确答案,从而拿到了满分奖励(+1.0)。 强化学习的似然比梯度(Likelihood Ratio Trick)随之剧烈放大了这一分支的转移概率。 本质结论:DeepSeek-R1 的所谓“自我反思与回溯”,正是通过数万步强化学习,把外部确定性真值环境下的树搜索剪枝策略(Tree-Search Pruning),成功内化(Internalized)并编译进了自回归的序列参数空间中!
诚实声明
本课没有 RL 环境实操:没有跑过 rollout、没有接 verifiable reward 环境、没有复现任何 R1 曲线。本节所有数字(15.6%→71.0%、600k/200k)引自论文;对应技能缺口(RL 实操)应在后续用小型开源 RL 框架补,而不是在本课伪造。
阶段五:MTP 与 FP8
MTP:多 token 预测
V3 的训练目标不只预测下一个 token,还用额外 MTP 模块预测更远的 token(开源 config:num_nextn_predict_layers: 1,即多预测一个)。损失函数就是把多个预测头的 cross entropy 叠加(第3章的同一个公式用 D 次):
两个作用:
- 训练侧:每个位置提供多个监督信号,信号密度更高,数据利用更充分。
- 推理侧:MTP 头可当投机解码(speculative decoding)的草稿模型——自己给自己打草稿,主模型一次校验多个 token,加速解码(self-speculative,无需额外小模型)。
FP8 混合精度训练
V3 是首个公开验证 FP8 混合精度训练可在此规模稳定收敛的模型之一:权重/激活用 FP8(e4m3),配合细粒度 scaling(按 tile/block 而非全张量),累加与敏感算子保持高精度。成果:全训练仅用 2.788M H800 GPU 小时,且全程无不可恢复的 loss spike(V3 摘要原文)。精度风险是真实的:FP8 只有 4 位指数/3 位尾数,溢出与下溢范围窄(e4m3 动态范围约 ±448),超出范围的数值会被 clip——必须靠细粒度 scale 与高精度累加兜底,这不是"免费的 2 倍吞吐"。
与第10章 int8 推理量化的对比
| 维度 | 第10章 int8 量化(推理侧) | V3 FP8(训练侧) |
|---|---|---|
| 目的 | 省显存、省带宽,部署更小 | 提训练吞吐、降训练成本 |
| 量化时机 | 训练后(PTQ) | 训练全程(量化感知) |
| 格式 | int8 + per-tensor/per-channel scale | FP8 e4m3 + tile/block 级 scale |
| 主要风险 | 权重误差 → 输出漂移(第10章已实测) | 梯度/累加下溢 → 训练不稳 |
| 反向传播 | 无 | 必须在低精度下保证梯度可用 |
系统吞吐杀手锏:DualPipe 并行算法与计算通信重叠 (Overlapping)
在万卡大规模训练中,最大的耗时瓶颈往往不是 GPU 算得不够快,而是多机跨网络数据通信在“堵车”。
在 MoE 架构中,一个 token 被路由给哪个专家,这个专家可能在另外一台物理服务器的 GPU 上。把 token 分发过去、再把算好的结果收回来,需要极高频的跨节点跨 GPU 集合通信 (All-to-All)。
传统流水线并行(如 1F1B)中,GPU 常常在原地“傻等”网络通信完成,产生高达 30%~50% 的空转时间(称为通信气泡 Bubble)。
DualPipe 的破局:双向流水线 + 计算与通信完美重叠
- 前端类比:像 GPU 渲染中的双缓冲(Double Buffering)——GPU 正在显示帧 N 的同时,CPU 已经在准备帧 N+1 的几何数据,VSync 间隙被精确利用。与双缓冲的边界:双缓冲处理的是两份独立的帧数据;DualPipe 的两路流水线处理的是同一 batch 的不同微块,调度更细粒度,且要求双向对称——不是任意两个并行任务都能互相掩盖通信开销。
- 对称调度:DualPipe 同时启动两个对称方向的流水线(一个正向处理 batch A,一个逆向处理 batch B)。
- 细粒度拆分:将计算细拆为注意力前向、MoE 跨节点分发通信、专家计算前向、注意力反向等细粒度微块。
- 重叠消除:把耗时的 All-to-All 通信,藏在另一批数据的密集 GEMM 矩阵计算背后!使得万卡集群的通信开销几乎被 100% 完全掩盖(Overlap)。
- 底层支撑:配合自研的 3FS (Fire-Flyer File System) 分布式文件系统(基于 RDMA 高性能网络,提供 TB/s 级并行吞吐)与 Fire-Flyer AI-HPC 软硬件协同集群,彻底消灭 IO 瓶颈。
阶段六:V3 架构总装
把前五节拼成一张图,每块都能指回去:
闭卷解释主线:输入进 embedding;前 3 层 dense 打底;其余 58 层每层是 MLA 注意力(KV cache 压到每 token 每层 576 元素)+ MoE FFN(256 选 8 + 1 共享,bias 调负载不用辅助梯度);LM head 之外挂 MTP 头(训练加信号密度、推理做投机解码);整个预训练在 FP8 混合精度下用 2.788M H800 小时跑完。每个设计回答同一个问题:同等能力下,把训练/推理成本再砍一刀。
阶段七:动手实验
必做(核心)
- KV 算账对拍:用
compare_kv_cache复算阶段一的表,并把 V3-like config 换成自己设定的 shape(如第9章的 2 层 / 4 头小模型)再算一遍,手算与程序输出逐字节一致。 - Router 实验:跑
router_balance_experiment(),复现坍缩 → 纠偏对照表;把bias_speed调大 10 倍观察震荡(负载在目标附近来回跳过),写一句为什么 V3 用小步长。 - GRPO toy:跑
grpo_policy_update,确认期望 reward 上升、margin 扩大;把 rewards 全部改成相等值,确认 advantage 全零、策略不动(零方差组无梯度——这就是 GRPO 要求组内有区分度的原因)。
必做(验证)
bash
cd <仓库根>
PYTHONPATH=python .venv/bin/python -m pytest python/tests/test_deepseek_toys.py -q
text
....................                                                     [100% ]
20 passed in 0.32s

判定信号:
  KV 字节数与手算逐字节一致(MHA/GQA/MLA 三式)
  MLA 缓存与头数无关;GQA 满 KV 头时退化为 MHA
  bias 只影响专家选择、不影响 gate 权重
  无约束路由坍缩(3/16 专家),bias 纠偏后 16/16 且 std 下降
  GRPO advantage 组内零均值、单位方差;零方差组全零
  toy 更新后期望 reward 上升、KL 随 beta 增大而减小
实测快照见 evidence/20-deepseek-v1.json:20 测试全绿;V3-like shape 下 seq=4096 的 KV 缓存 MHA 15.25 GiB / GQA-8 0.95 GiB / MLA 274.5 MiB;router 无约束最大负载 0.500(3/16 专家)→ bias 纠偏后 0.0964(16/16);GRPO toy 期望 reward 0.500 → 0.6397。这些数字只覆盖本仓库 toy fixture 与论文引用,不描述任何真实 DeepSeek 模型的训练或推理。
故障注入与预期信号
| 注入 | 预期失败信号 | 修复后证据 |
|---|---|---|
| MHA/GQA 公式漏乘 2(忘了 K 和 V 两份) | 字节数恰为手算值一半 | 手算对拍测试通过 |
| MLA 缓存乘了头数 | test_mla_cache_does_not_scale_with_head_count 失败 | 缓存只含 rank+rope 维 |
| router 权重用 biased score 计算 | bias 同时扭曲选择和加权 | test_router_bias_steers_selection_not_weights 通过 |
| bias 更新方向写反(超载加 bias) | 负载加速坍缩,max_load_fraction 上升 | 纠偏实验 std 下降断言通过 |
| GRPO advantage 忘减组均值 | 组内零均值断言失败、所有回答同向更新 | 零均值/单位方差测试通过 |
| 零方差组直接除 std | NaN 或 inf | 全零 advantage 断言通过 |
| KL 项符号写反(减成加) | beta 越大 KL 反而越大 | KL 正则对照测试通过 |
| 把论文数字(93.3%、2.788M 小时)当本地实测写进 evidence | 违反"证据先于勾选"纪律 | evidence 只记本地 toy 运行值,论文数字注明来源 |
本章验收
不看资料,用 5–10 分钟回答:
- MLA 定量推导:给定 d_model/n_heads/层数/序列长,现场写出 MHA、GQA、MLA 的 KV 缓存公式并算出字节数;说清 93.3% 是 V2 对 DeepSeek 67B 的口径,而你手算的是同 shape 假设基线(head_dim = 128)。
- 长度外推拨的是哪个旋钮:YaRN 按频段改旋转速度;把全部频率除以同一个常数会压扁相邻 token 的相位。Qwen2.5 同时提高基频并加长后期训练,推理侧再用 YaRN。Llama 3 的 128K 是续训。Code Llama 改的是基频周期。只改配置里的最大长度,这三件事都还没发生。
- MoE 负载均衡为什么 aux-loss-free:讲负载坍缩的自我强化机制;aux loss 的梯度干扰问题;bias 只影响选择、不影响加权,为什么不引入辅助梯度。本步梯度进入 router、共享专家和被 top-k 选中的 routed expert;未被选中的专家权重本步梯度为零。专家参数仍然全部驻留,省的是本步更新集合,不是存储。
- MoE 推理通信:token 被路由到远端专家时为什么需要 all-to-all;expert parallelism 如何切分专家;expert offloading 的 PCIe 代价从哪来。
- GRPO vs PPO:画两者的组件图(critic 有无)、baseline 来源、KL 位置;说清 GRPO 为什么天然适配 rule-based reward。
- R1-Zero 为什么能纯 RL:base model 的潜伏能力 + 可验证 reward + 组内 advantage 无 critic;它有什么硬伤,R1 用哪四阶段修。
- MTP 与 FP8:MTP 的训练/推理双作用;FP8 e4m3 的动态范围问题与第10章 int8 推理量化的误差路径差异。
- SFT-first vs RL-first 取舍:R1-Zero(直接 RL)涌现反思但可读性差;R1(冷启动 SFT 再 RL)更稳但探索受 cold-start 数据上限约束——举一个你会在产品中选哪个、为什么。
- 测试时计算扩展(TTC)与自校正边界:说清 Best-of-N、Self-Debug 与树搜索(MCTS)三者的效率特征与适用边界;为什么无外部反馈的内在自校正容易把对的改错,R1 的 Aha moment 本质上内化了什么。
- 统一防守句(诚实边界纪律):"我没有亲手训练这些模型;我的理解来自公开论文和本课 toy 复现,数字以论文为准。toy 实现证明的是记账和更新规则,不是工业系统。"
可评分客观检查项(人工评分, rubric 式)
以下条目不设自动化测试;学习者需在闭卷解释或书面答辩中展示,评分者按 rubric 逐条打勾。
- 模型发布 excerpts 标注:给出一段模拟模型发布的技术描述(含 3–5 个设计决策),要求学习者标出每个决策属于 MLA / MoE / GRPO / MTP / FP8 / KV-cache 量化中的哪一类。正确率 ≥ 4/5 通过。
- 因果链写作:任选两个设计决策(如"为什么 MLA 要解耦 RoPE"或"为什么 V3 用 aux-loss-free 而非 Switch aux loss"),写至少 3 条因果链("因为 A,所以 B,进而 C"),每条链中的因果关系必须在章节正文中有对应依据。
- 架构图画法:在不参考资料的情况下,画出 V3 架构图并逐块标注:embedding → dense 前 3 层 → MoE 层(router + shared expert + MTP head)→ LM head,并说明每块的设计动机(为什么要这个块、省了什么)。
论文与延伸
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(DeepSeek-AI,2024)——MLA 与 DeepSeekMoE 出处
- DeepSeek-V3 Technical Report(DeepSeek-AI,2024)——aux-loss-free、MTP、FP8、671B/37B
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(DeepSeek-AI,2025)——R1-Zero 与多阶段流程
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning(Shao 等,2024)——GRPO 出处
- DeepSeekMoE: Towards Ultimate Expert Specialization(DeepSeek-AI,2024)——细粒度 + 共享专家
- YaRN: Efficient Context Window Extension of Large Language Models(Peng 等,2023)——长上下文高低频分治外推
- Fire-Flyer AI-HPC: A Cost-Effective Software-Hardware Co-Design for Deep Learning(DeepSeek-AI,2024)——3FS 与万卡集群软硬件协同
- Switch Transformers(Fedus 等,2021)——aux loss 负载均衡的经典出处
- 开源代码:DualPipe 双向流水线并行算法;3FS (Fire-Flyer File System) 分布式文件系统。
- 批判视角:Dr. GRPO(Liu 等,2025;arXiv 编号见讲义)——去掉 GRPO 长度归一化与 std 归一化的修正方案,其更新是按 (N−1)/N 缩放的无偏策略梯度;动机级与批判视角引用,未 readback。本地绑定:GRPO 的偏置与修正小节。讲义来源:Ernest Ryu, RL of LLMs(Spring 2025)课程页。
完整索引见 参考 / 必读论文;L1 动机级词条见 术语表(MLA / MoE / GRPO / MTP / PPO)。
前端/Agent 迁移
- MLA ≈ 状态压缩存储:像把冗长 state 压成序列化索引再按需还原——存压缩表示,用时展开;前提是你清楚还原成本。
- GRPO 组内相对打分 ≈ 组内排名而非绝对分数线:同一任务多次 rollout 形成相对反馈——这正是 Agent Harness 里 Eval 设计的直接灵感。
资源 / 成本 / 隐私
全部 toy 实验为本地 NumPy 计算,gross cost 为 0;不下载模型权重、不调用任何 API。论文数字只引用公开摘要与官方开源 config,面试资料(careers 仓库)为本地只读输入,内容不入库。
诚实边界声明
- toy ≠ 工业训练:本章所有代码只复现三类规则——KV 字节数记账、router bias 更新、GRPO 组归一化 advantage 更新。没有训练、服务或 benchmark 任何真实模型。
- 无 RL 环境:本课没有 rollout 采样器、verifiable reward 环境或 RL 训练循环;阶段四的全部 R1 数字引自论文。RL 实操是学习者已知缺口,需另找机会补齐,本课不伪造。
- 数字以论文为准:236B/21B、671B/37B、93.3% KV 压缩、5.76× 吞吐、2.788M H800 小时、15.6%→71.0%、600k/200k 均来自论文摘要/正文与官方开源 config;本地实测的只有 toy fixture 输出。
- 假设基线已标注:阶段一的 MHA/GQA 列是同头数假设,真实 V3 只有 MLA;router toy 用 softmax gate,V3 实为 sigmoid + 分组 top-k;toy 只复现 bias 更新规则。
- 范围外:V3.1/V3.2(DSA 稀疏注意力)、V4 Preview 等后续版本更新不在本章范围;DualPipe 与 3FS 在阶段五有完整机制讲解(系统层,非架构层);蒸馏在阶段四有独立小节;YaRN 长上下文扩展在阶段一有完整独立小节。
Evidence
仓库当前机器证据(只读快照)
evidence/20-deepseek-v1.json 是当前 checkout 的脱敏机器运行记录,只覆盖该 JSON 记录的命令、指标、产物和已知失败;它不是学习者提交,也不能推出学习者已完成本章。模块已登记进 evidence/module-manifest-v1.json。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。
yaml
schema: learn-llm.evidence.v1
module: 12-deepseek
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 13
commands:
  - PYTHONPATH=python .venv/bin/python -m pytest python/tests/test_deepseek_toys.py -q
metrics:
  - name: kv_mla_bytes_v3like_seq4096_bf16
    expected: 287834112
    actual: <recorded-value>
  - name: kv_mla_vs_mha_ratio_v3like
    expected: "≈0.0176"
    actual: <recorded-value>
  - name: router_unconstrained_max_load_fraction
    expected: 0.5
    actual: <recorded-value>
  - name: router_corrected_active_experts
    expected: 16
    actual: <recorded-value>
  - name: grpo4_final_expected_reward
    expected: ">0.5"
    actual: <recorded-value>
  - name: grpo6_kl_beta_stronger_is_smaller
    expected: true
    actual: <recorded-value>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
若没有 KV 对拍、router 纠偏对照和 GRPO 性质断言的真实运行值,本章只能标记为 gate;论文引用数字不替代本地运行证据。
下一步
进入 第13章 · 向量检索、RAG 原理与 ACL:走出纯模型权重参数空间,进入外挂知识库检索、向量空间与行级权限隔离的工业级落地实战。