
Appearance
第16章 · 真实大模型 API 实战
前置要求:掌握 第15章 · Typed Tools、MCP 与可恢复 Agent 的结构化工具声明与协议规范。
前13章全部在本地闭环:模型是自己手写的 TinyGPT 或离线 fixture。本章把管道接到真实的云端模型——通过 OpenAI 兼容端点调用 Gemini。你会发出第一次 chat completion、读懂 usage 账单、手写 SSE 流式解析、补全 function calling 往返,并学会一套前端工程师最关心的问题:怎么在 CI 里不打真实 API 也能测整条链路(录制 fixture 回放)。
没有 API key 也能完成本章:所有验收都跑在离线回放证据线上,live 路径单独标记。
live API 路径在本仓库证据中标记
unverified-live,默认证据线是离线 fixture 回放。
本章目标
学完后你能做到:
- 用环境变量持有 API key,经 OpenAI 兼容端点向 Gemini 发出第一次 chat completion,并读懂
usage元数据。 - 说清 OpenAI
system/user/assistant/tool角色与 Gemini 原生contents/systemInstruction的结构差异,并能在两种格式间手工互转。 - 手写 SSE 流式解析:跨 TCP chunk 的半行缓冲、
data: [DONE]终止、tool_calls 参数片段拼接、边收边打印与超时取消。 - 把单程模型调用补成完整 function calling 往返:声明工具 → tool_call → 本地执行 → 回传 result → 最终回答。
- 区分可重试(429/5xx)与不可重试(400)错误,实现带 jitter 的指数退避,并建立"价格为零但额度有限"的成本意识。
- 用本地 hash-vector 基线与
gemini-embedding-001做对比实验,写出基线在哪些任务上失效的诚实结论。 - 掌握"不打真实 API 的测试":transport 注入 + 录制 JSON fixture 回放,CI 默认离线、录制需显式开关。
接口 shape 速览
| 对象 | shape/结构 | 约束 |
|---|---|---|
| 端点 | POST {base_url}/chat/completions,base_url=https://generativelanguage.googleapis.com/v1beta/openai | 只走 https;key 放 Authorization: Bearer 头,不进 URL、不进日志 |
| message | {"role": "system|user|assistant|tool", "content": str} | tool 消息必须带 tool_call_id 回指 |
| tool 声明 | {"type": "function", "function": {"name", "description", "parameters"}} | parameters 是 JSON Schema |
| tool_choice / tool_config | OpenAI: {"type":"function","function":{"name":"X"}} 或 "auto"/"none"/"required";Gemini: tool_config | 强制模型使用指定工具;详见第15章 |
| stream chunk | choices[0].delta + SSE data: 帧 | 工具参数是 JSON 字符串片段,按 index 分别拼接后才能 json.loads;不同 index 的片段互相独立,不能混拼 |
| usage | {"prompt_tokens", "completion_tokens", "total_tokens"} | 流式需 stream_options: {"include_usage": true} 才返回 |
| 错误 | HTTP status + JSON error body | 429/5xx 可重试;400 立即失败 |
阶段一:Key 与第一次调用
在 Google AI Studio 一键创建 API key,写进环境变量(绝不落盘、不进 shell 历史文件、不进日志):
bash
export GEMINI_API_KEY="<your-key>" # 或 GOOGLE_API_KEY,SDK 两者都读python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GEMINI_API_KEY"],
    base_url="https://generativelanguage.googleapis.com/v1beta/openai/",
)
resp = client.chat.completions.create(
    model="gemini-3.6-flash",  # 免费层选 Flash 系;Pro Preview 不在免费层
    messages=[{"role": "user", "content": "用一句话解释 checkpoint"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens / total_tokens
动手:发出你的第一条 completion,只看 resp.usage 回答"这次调用花了多少 token、输入输出各占多少"。没有 key 时该步骤标记 unverified-live,用阶段七的回放代替,不要编造 usage 数字。
阶段二:消息结构与角色
OpenAI 兼容层与 Gemini 原生 API 的角色模型不同,这个差异本身是教学点:
| 关注点 | OpenAI 兼容 | Gemini 原生 |
|---|---|---|
| 系统指令 | {"role": "system", ...} 在 messages 里 | 独立 systemInstruction 字段,不进 contents |
| 对话角色 | user / assistant / tool | contents 只有 user / model 两种 role |
| 工具结果 | {"role": "tool", "tool_call_id": ...} | functionResponse part |
动手:手写同一段三轮对话(system + user + assistant)的两种格式,再写一对互转函数(几十行即可);用"转换后再转回来与原格式一致"自验。注意 system 在原生侧必须移出 contents,assistant 要改名 model。
前端类比:这就是同一数据模型的两种 DTO——像 GraphQL 响应和 REST 响应之间的 adapter,互转函数就是你的 mapping layer。
阶段三:Streaming 消费
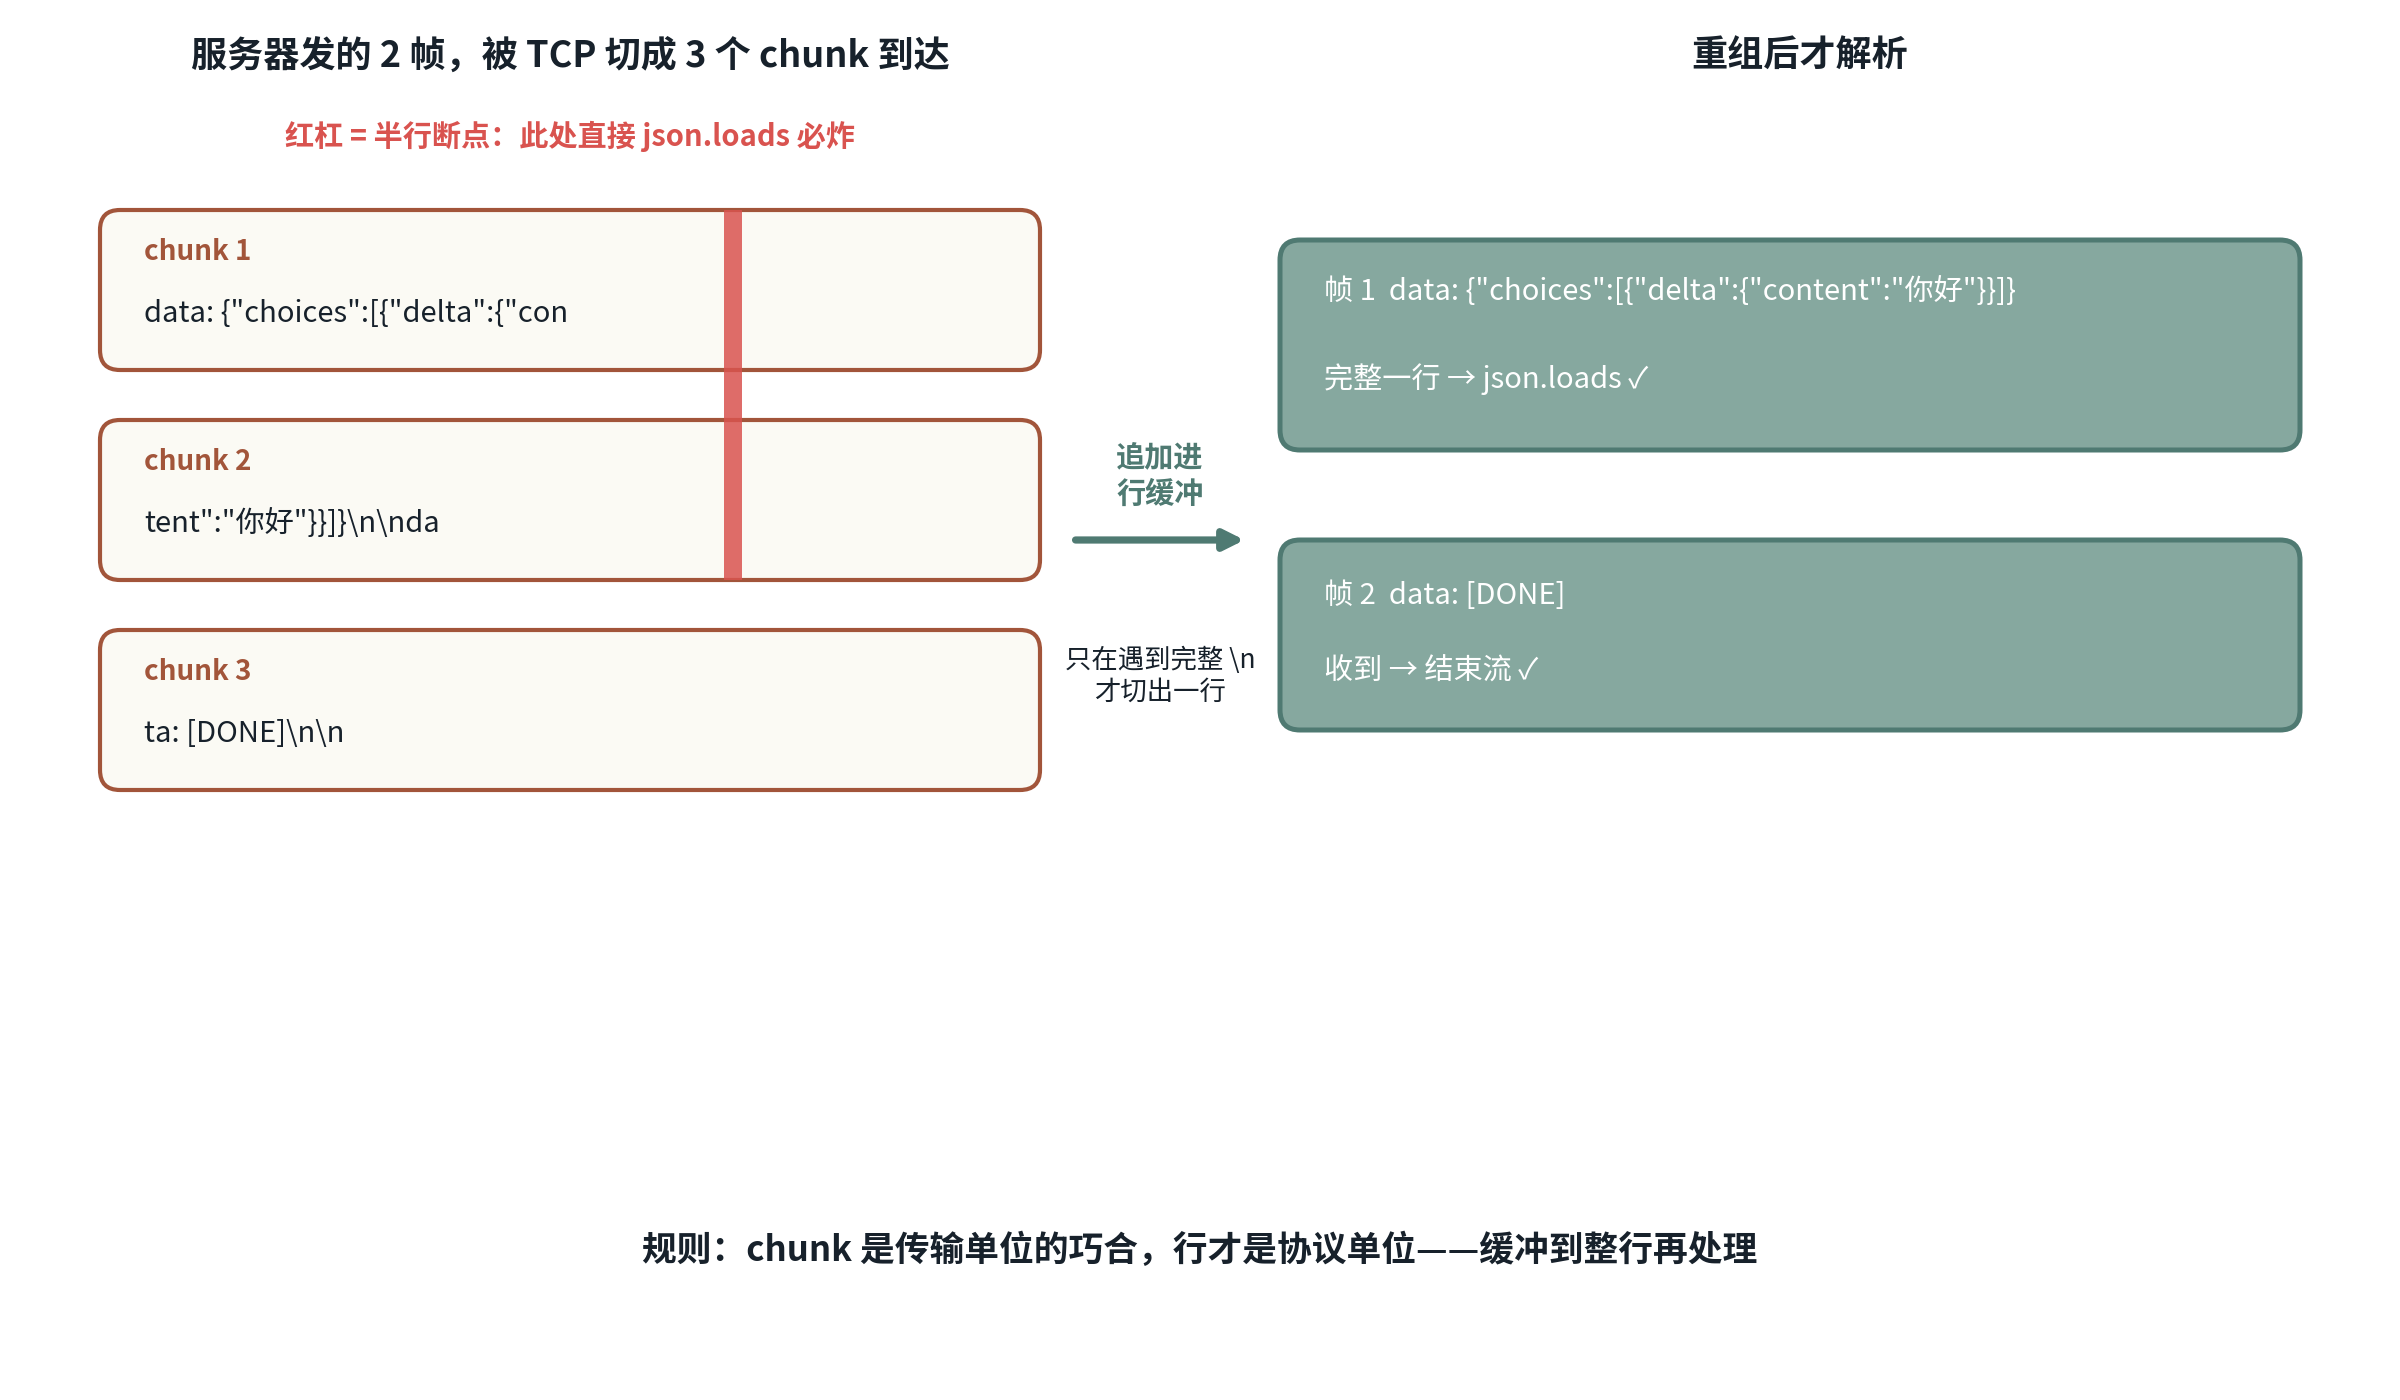
stream=True 后响应是 SSE(Server-Sent Events):每帧 data: {...}\n\n,结束帧 data: [DONE]。这里有个新手必踩的坑:TCP 不保证按行交付——一个 chunk 可能只含半行 JSON。
看个具体例子。服务器实际发来两帧,但被 TCP 切成了三个 chunk 到达:
text
chunk 1: 'data: {"choices":[{"delta":{"con'
chunk 2: 'tent":"你好"}}]}\n\nda'
chunk 3: 'ta: [DONE]\n\n'
如果对每个 chunk 直接 split("\n") 再 json.loads,chunk 1 的半行必然解析异常、流随机崩。正确做法是行缓冲:把到达的字节追加进 buffer,只在遇到完整 \n(或 \r\n)时才切出一行处理;忽略 : keep-alive 注释行;拼齐多行 data:。参考实现 parse_sse_events(python/agent_core/gemini_roundtrip.py)就是这么做的。
前端类比:这就是浏览器里 EventSource 和流式 fetch 内部做的事;你在 WebSocket 分帧重组里也见过同一个问题。
Provider 抽象层:Transport 注入模式
GeminiRoundtripClient(python/agent_core/gemini_roundtrip.py)把"发 HTTP 请求"抽象成一个可注入的 Transport:(url, payload, api_key) -> TransportResponse。这个 thin client 的职责只有一个——把内部统一的请求 shape 翻译成 provider 端点的一个 HTTP 请求,再把 provider 的原始响应翻译回统一的 ChatResult / TransportResponse。注入 transport 是整条 loop 可离线测试的原因:测试时塞入 ReplayTransport,零网络、零 key、确定性回放。
这个抽象层应该包含的内容:
- 端点:
base_url→chat/completions路径拼接(endpoint属性) - 认证:Bearer key 从环境变量读取,只传给 transport 调用,不落盘、不进 fixture、不进日志
- 角色映射:内部用 OpenAI 兼容的
system/user/assistant/tool,_build_payload不做格式转换——Gemini 原生格式转换在google_gemini.py的GeminiAdapter里独立完成 - 流式帧装拆:
parse_sse_events处理 chunk 边界、半行缓冲、data: [DONE] - 重试分类:
_post根据is_retryable_status区分 429/5xx(重试)和 400/401/403(立即失败)
不应该包含的内容:
- prompt 内容(属于调用方,不是 transport 的责任)
- tool policy(属于第15章 harness,不在 transport 层)
- business rules(租户隔离、凭据 scope 等,由调用方在传入 payload 前处理)
google_gemini.py 的 GeminiAdapter 是同一 transport 注入模式的另一实例——它面向 Gemini 原生 generateContent 端点,角色映射为 user/model,工具声明用 functionDeclarations。两者共享 Transport = Callable[[str, dict, str | None], Mapping] 类型签名,互不依赖。
动手:
- 用
on_text回调边收边打印(参考实现的stream_chat)。 - 手写一个 5 行级 SSE 解析器直接读原始
data:帧,与参考实现对拍同一 fixture。 - 加取消:Python 侧用
timeout_seconds+ 提前break/关闭响应;前端迁移时用AbortController。取消后确认没有"幽灵后半段"进入状态。
阶段四:Function calling 完整往返
GeminiAdapter 是单程:模型返回 tool_call 就结束。本节补成往返状态机:
text
messages + tools → 模型 → tool_calls → 本地 executor →
assistant(wire) + role:tool 消息回传 → 模型 → 最终文本
展开成消息序列,一轮真实往返长这样:
- 你发:
[user: "北京今天天气?"]+ tools 声明。 - 模型回:
assistant消息,带tool_calls: [{id: "call_1", function: {name: "get_weather", arguments: "{\"city\":\"北京\"}"}}]。注意 arguments 是 JSON 字符串(流式时还是分片到达的),要json.loads后才是 dict。 - 本地 executor 执行
get_weather("北京"),得到结果{"temp": 26}。 - 你追加两条消息再发:
assistant(原样回带 tool_calls)+{"role": "tool", "tool_call_id": "call_1", "content": "{\"temp\": 26}"}。 - 模型观察结果,回最终文本:"北京今天 26°C……"
为什么 tool result 必须回传、而不是本地直接拼进最终答案? 因为模型需要观察结果才能继续规划——这正是第15章状态机的 observe → plan 边。少了回传,第二轮请求的 messages 里缺 role: "tool" 消息,模型会重复调同一工具或胡答。
生产级 Tool Calling 的两大关键铁律
- 并行工具调用(Parallel Tool Calls)的 1-to-1 对齐: 现代大模型(如 GPT-4o、Claude 3.5、Gemini 1.5/2.0)支持在单轮响应中同时触发多个工具(例如
[call_1: get_weather("北京"), call_2: get_weather("上海")])。客户端必须为每一个tool_call_id严格追加一条匹配的role: "tool"消息。缺少任何一个 ID,服务端的 API 校验将直接拒绝(抛出 400 校验错误)。 - 工具执行异常不要挂断,作为 Observation 喂回: 如果本地工具执行抛出异常(如数据库超时、网络断开),不要让整个 Agent 崩溃退出!应该将错误结构化捕获为
{"error": "ConnectionTimeout", "detail": "数据库连接超时"}写入content返回给模型。大模型在看到报错后,具备自愈能力(Self-Correction),能够选择重试、调整参数或向用户解释失败原因。 - 流式参数按
index独立拼接: 在 SSE 流中,工具参数是分片到达的:delta.tool_calls[0].function.arguments = "{\"ci",紧接着delta.tool_calls[0].function.arguments = "ty\":\"北京\"}"。当存在多个并行调用时,不同工具的分片可能交织到达,客户端必须维护一个按index索引的字符串累加缓冲区args_buffer[index] += chunk,直至收到结束帧后再分别json.loads。
动手:用 GeminiRoundtripClient.run_tool_loop 跑通 python/tests/fixtures/w10a_openai_compat.json 的 roundtrip 场景(离线回放),断言第二次请求的 messages 里确实有 assistant tool_calls 和 role: "tool" 回传。
阶段五:限流、重试与成本意识
哪些错误值得重试:
- 429
RESOURCE_EXHAUSTED与 5xx:服务端暂时性问题,可重试——但要等,马上重试只会再撞一次。 - 400:请求本身有问题,立即失败——重试一百次也是同样的 400,白白消耗额度。
退避公式逐符号读(参考实现 RetryPolicy.delay):
:第几次重试(0 起)。 是指数退避:第 0、1、2 次分别等 base、2·base、4·base,间隔翻倍,给服务端喘息。 :封顶,防止重试次数多了以后等到天荒地老。 :jitter(抖动),rand 是 随机数,把延迟随机缩放到原值的 50%–100%。没有 jitter,一大批被 429 拒掉的客户端会在同一时刻一起重试、再一起被拒("惊群效应");有了 jitter,大家的重试时刻被随机错开。
测试里用固定 seed 断言退避序列等于确定性值 [0.375, 0.75]——你可以代入 base=0.5 自己验算。
成本意识:免费层"价格为零但额度有限"——限额按 RPM/TPM/RPD 三维、按 project 计,且随账户与政策变动;官方不再发布静态数字表,本课也不硬编码任何限额数字。动手:去 AI Studio 的配额页查你账户的实时配额,把三个维度各抄下一个当前值(这是查询练习,不是背书)。
重试分类的完整边界:is_retryable_status(gemini_roundtrip.py)只把 429 和 5xx 标记为可重试——两者都是服务端暂时性问题。400(请求本身有误)和 401/403(凭据或权限问题)立即失败,不进入退避循环。_post 里 ConnectionError / TimeoutError 也走重试路径(网络抖动),但其他异常直接转 ProviderError 抛出。重试一个非重试错误不仅浪费 quota,更危险的是:如果工具副作用已经发生,重试会带着相同参数再次调用——幂等键能防止重复副作用,但第一次调用本身的资源消耗已经发生。
诚实声明:免费层的请求数据会被 Google 用于改进产品——敏感内容、凭据、他人数据一律不发;这条与第15章的 redact 纪律一致。
阶段六:Embedding 对比实验
本地基线是第13章的 hash-vector(python/agent_core/embedding.py);live 对照是 gemini-embedding-001(纯文本现行模型,默认 3072 维,output_dimensionality 可截断到 768/1536,截断后需手动归一化;免费层可用。text-embedding-004 已退役,不要再引用)。
动手:先跑离线基线(命令见阶段八),对同一组四句句子算余弦相似度矩阵,观察:词面重叠高的 s1/s2 = 0.833,而零共享 token 的同义改写 s1/s4 只有 0.144,与不相关的 s1/s3(0.333)几乎拉不开——hash 基线在 paraphrase/同义任务上失效,且 32 维下存在哈希碰撞底噪。有 key 时再用 openai SDK 的 client.embeddings.create(model="gemini-embedding-001", ...) 算同一矩阵做对照(无 key 则此半段标 unverified-live)。结论必须写清:基线只在词面重叠任务上有效,语义任务的证据只能来自真实 embedding 模型。
阶段七:不打真实 API 的测试
沿用本章的 transport 注入:ReplayTransport 按序回放录制 JSON fixture,记录的 request 只保留 api_key_present 布尔值,key 永远不进 fixture、不进断言失败输出。纪律与仓库 approval 门禁同构:CI 默认回放;录制新 fixture 是显式开关——需要同时满足 GEMINI_API_KEY 在环境、学习者显式设置 W10A_RECORD_LIVE=1、并在提交说明里写明录制范围,否则一律离线。
前端类比:这就是 MSW(Mock Service Worker)/ VCR 的思路——把真实 HTTP 往返录成磁带,测试时回放。好处是 CI 确定性、零成本、无网络;代价是磁带会过期,所以录制必须是显式动作。
动手:给 roundtrip 场景之外再录(或手写)一个 stream fixture,要求至少一处 data: 帧被 chunk 边界切断,然后让 test_gemini_roundtrip.py 的回放通过。
阶段八:动手实验
把"接上真实模型"拆成可离线验证的确定性证据:SSE 解析、tool_calls 重组、往返状态机、重试策略、usage 解析全部由录制 fixture 回放覆盖;live 路径只在你自己的 key 下单独核验并标记。
参考实现是 python/agent_core/gemini_roundtrip.py:沿用本章 GeminiAdapter 的 transport 注入模式,全部 stdlib(urllib)实现,不引入新依赖。live 示例教你用 openai SDK;参考实现与测试走 stdlib + fixture 回放,两者互不依赖。
环境准备
bash
cd <仓库根>
export PYTHONPATH="$PWD/python"
命令与预期输出
bash
# 1) 离线回放测试(CI 默认线,无需 key、无网络)
.venv/bin/python -m pytest python/tests/test_gemini_roundtrip.py -q

# 2) embedding 本地基线对比实验
.venv/bin/python - <<'PY'
from agent_core.embedding import hashed_embedding, cosine_similarity
sentences = [
    "the cat sat on the mat",
    "the cat sat on the carpet",
    "a dog runs in the park",
    "a feline rested upon a rug",
]
vecs = [hashed_embedding(s, 32) for s in sentences]
for i, v in enumerate(vecs):
    print(f"s{i+1} " + " ".join(f"{cosine_similarity(v, w):.3f}" for w in vecs))
PY
text
..............                                                           [100%]
14 passed in 0.05s

s1 1.000 0.833 0.333 0.144
s2 0.833 1.000 0.333 0.289
s3 0.333 0.333 1.000 0.289
s4 0.144 0.289 0.289 1.000

判定信号:
  SSE 半行拼接、tool_calls 分片重组、往返两轮终止全部通过
  429 重试的 sleep 序列等于确定性断言 [0.375, 0.75];400 零重试
  s1-s2(词面重叠)0.833 远高于 s1-s4(零共享 token 同义改写)0.144
live 核验(有 key 时自选,不计入本仓库证据):
bash
export GEMINI_API_KEY="<your-key>"
python -c "import os, openai; c = openai.OpenAI(api_key=os.environ['GEMINI_API_KEY'], base_url='https://generativelanguage.googleapis.com/v1beta/openai/'); r = c.chat.completions.create(model='gemini-3.6-flash', messages=[{'role':'user','content':'ping'}]); print(r.usage)"
概念图
故障注入与预期信号
| 注入 | 预期失败信号 | 修复后证据 |
|---|---|---|
SSE 按 chunk 直接 split("\n") 不缓冲 | 跨 chunk 的半行 JSON 触发 json.loads 异常,流随机崩 | 行缓冲解析器通过半行 fixture;data: [DONE] 正常终止 |
每个 stream delta 都 json.loads 工具参数 | 参数片段不是合法 JSON,解析异常 | 按 index 拼接全部片段后只解析一次,得到完整 dict |
| 只发 tool_call 不回传 tool result | 第二轮请求缺 role: "tool" 消息,模型重复调同一工具或胡答 | 往返状态机两轮终止,final_text 来自第二轮 |
| 400 也进重试循环 | 固定次数重试后仍失败,白白消耗额度 | 400 第一次就抛 ProviderError(retryable=False),零次 sleep |
| 429 无退避立即重试 | 连续 429,退避序列为空 | sleep 序列满足 base * 2**attempt * jitter(测试断言 [0.375, 0.75]) |
| key 写进 URL / fixture / 异常消息 | fixture 或测试输出出现 key 字符串 | request 记录只有 api_key_present;transport 抛错也被 sanitize |
本章验收
不看资料,用 5–10 分钟回答:
- 闭卷解释一次完整 function calling 往返:每条消息的 role、tool_call_id 如何回指、为什么 tool result 必须作为 data 回传而不是拼接进 prompt。
- 画出 SSE 从 TCP chunk 到
delta.content的解析管线,指出半行、[DONE]、keep-alive 各在哪一步处理。 - 解释为什么 429 可重试而 400 不可重试;背出你实现的退避公式并说明 jitter 解决什么(惊群)。
- 说明 hash-vector 基线在 paraphrase 任务上的实测表现(0.144 vs 0.833)及其对"离线基线能证明什么"的限制。
规范与延伸
- Gemini OpenAI 兼容端点文档(以执行日官方文档为准)。
- Google AI Studio:创建 key、查实时配额。
- 诚实声明:
generateContent已被官方称为 legacy,Interactions API(2026-06 GA)是新的推荐入口。本课以 OpenAI 兼容端点为主线(生态与前端经验迁移最直接),但你要知道 Interactions 的存在;后续章节如切换主线,以当时官方文档为准。
前端/Agent 迁移
本章的几乎每个概念你都在浏览器里见过:SSE 对应 EventSource/流式 fetch 的行缓冲;on_text 边收边打印对应流式渲染;取消对应 AbortController;429 退避 + jitter 与前端重试策略同构;tool_calls 参数片段拼接等价于你在 WebSocket 分帧里做过的消息重组。迁移判断不变:模型输出是 data 不是 instruction——tool result 回传后仍走第15章的 schema/policy,不因"这次是真实模型"而绕过。
资源 / 成本 / 隐私
离线回放路径 gross cost 为 0、无网络。live 路径走免费层时账单为零但额度有限(RPM/TPM/RPD,按 project 计,随账户变动,官方无静态数字表,以 AI Studio 实时配额页为准)。免费层请求数据会被 Google 用于改进产品:敏感内容、凭据、他人数据一律不发;key 只走环境变量,不落盘、不进 fixture、不进日志与异常消息。模型选择:免费层用 Flash 系(如 gemini-3.6-flash),Pro Preview 不在免费层;embedding 用 gemini-embedding-001,已退役的 text-embedding-004 不再引用。
Evidence
仓库当前机器证据(只读快照)
evidence/14-llm-api-v1.json 是当前 checkout 的脱敏机器运行记录,只覆盖离线 fixture 回放:test_gemini_roundtrip.py 14 项全部通过、429 退避序列确定性断言、embedding 基线实测矩阵。live API 路径在无 key 环境下标记 unverified-live 并写入 known_failures。本模块已登记进 evidence/module-manifest-v1.json。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。live 指标(若有)必须来自你自己的 key 的真实调用,并在 known_failures 注明数据边界。
yaml
schema: learn-llm.evidence.v1
module: 16-llm-api
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 10
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_gemini_roundtrip.py -q
metrics:
  - name: offline_replay_tests_passed
    expected: 14
    actual: <recorded-value>
  - name: roundtrip_requests
    expected: 2
    actual: <recorded-value>
  - name: retry_backoff_sleeps
    expected: [0.375, 0.75]
    actual: <recorded-value>
  - name: live_usage_total_tokens
    expected: unverified-live
    actual: <recorded-value-or-unverified-live>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
只有 live 调用成功截图、没有离线回放测试与重试/往返断言时,本章保持 gate。
下一步
进入 第17章 · Prompt 工程与长短期记忆:把这条真实模型路径接回第15章的完整 harness——policy、HITL、checkpoint 与 live planner 的对拍。