
Appearance
第10章 · 现代推理、KV Cache、RMSNorm/SwiGLU、量化与 PagedKV
前置要求:掌握 第8章 · Attention 与 Transformer Block 的多头注意力张量结构与 第9章 · TinyGPT 预训练与恢复 的自回归生成路径。
第9章的 TinyGPT 用的是 2017 年的原始 Transformer 配方。本章把它升级到现代 LLM(LLaMA 系)的实际形态,并解决生成慢的问题。内容多,分上下两部分推进,建议两部分之间留出消化间隔:
- 上半部分 · 现代架构组件(阶段一~四):RoPE、RMSNorm、SwiGLU、Tied Embedding——把 block 换成现代配方。
- 下半部分 · 推理系统(阶段五~八):prefill/decode、KV Cache、MQA/GQA、PagedKV、量化——让生成又快又省。
本章目标
学完后你能做到:
- 推导 RoPE、RMSNorm、SwiGLU、MQA/GQA、prefill/decode 和单 batch KV Cache,并说清外推改的是频率、FlashAttention 改的是 HBM 读写、PagedKV 改的是块表。
- 证明增量 decode 与完整 causal forward 的 token/logit 等价。
- 解释 PagedKV 块表如何用"操作系统虚拟内存"的思路消除显存碎片、Tied Embedding 如何在词表巨大时节省参数。
- 在同一设备、同一 prompt、记录 warm-up 和重复次数的前提下,比较 cache、吞吐、首 token 延迟、权重大小和量化误差。
上半部分 · 现代架构组件
阶段一:RoPE——把位置"转"进向量里
第8章的位置编码是加在 embedding 上的绝对位置向量。RoPE 的思路更漂亮:不加,直接旋转 Q 和 K。每两个维度组成一个二维平面,按位置
这个矩阵就是高中数学里的二维旋转矩阵:它把向量转
Umar Jamil 的复数极坐标第一性原理:为什么两两分组就能表达相对位置?
很多工程师推导 RoPE 时感到繁琐,Umar Jamil 在其经典解析中给出了最优雅的复数视角:
- 二维向量对应一个复数: 在平面直角坐标系中,实数对
可以完美等价为一个复数 。 - 乘以欧拉公式即为旋转: 根据欧拉公式
,将复数 乘以 ,在几何上恰好等于将该向量逆时针旋转 弧度: - 点积中绝对位置的奇迹相消: 两向量的点积等价于两复数乘积的实部
(其中 为共轭复数,角度取负号): 看!绝对位置 与 在指数相减中瞬间抵消,最终的注意力得分只由两者的相对位移 决定!
关键性质:两个位置的 RoPE 向量做点积,结果只依赖位置差
直觉:两个向量各转了自己的角度,它们的夹角就是角度差——而第3章告诉你点积
一个反直觉的对照:decoder-only 模型即使完全不加位置编码(NoPE 设置),位置信息也没有真正丢失。第8章已经看到"把输入序列打乱,注意力分数的数值集合不变,只有 causal mask 依赖下标"——而 causal mask 恰恰让每个位置能 attend 的 token 数各不相同,各层据此就能"数"出绝对位置(显式构造可以做到让第
长上下文扩展演进:从线性插值到 NTK-Aware 与 YaRN
当模型需要从预训练的 4K 窗口扩展到 32K、128K 乃至 1M 时,直接输入超出训练范围的位置索引会导致角度暴增,引发困惑度(Perplexity)剧烈爆炸。业界经历了三代外推方案演进:
- 线性位置插值(PI, Position Interpolation):
- 将超长位置索引直接除以缩放因子
(即 ); - 痛点:全维度无差别压缩,导致高频维度相邻 Token 的角度相位差变小(
),模型丧失了对紧邻词(局部词序)的精细辨识能力。
- 将超长位置索引直接除以缩放因子
- NTK-Aware 缩放:
- 洞察到不同频率维度的物理职责分离:高频维度负责捕捉近距离语法细节,低频维度负责编码长程全局拓扑;
- 不改变位置
,而是修改基频底数 为 ,使得高频维度频率变化极微小,而低频维度发生主要拉伸。
- YaRN(Yet another RoPE extensioN)三段频域映射:
- 计算各维度的有效波长
与窗口阈值的比值; - 高频段(
):完全不插值,保持原始预训练高频分辨率; - 低频段(
):完全线性插值,将波长按比例拉伸; - 中间过渡段:用光滑斜坡函数在非插值与线性插值间无缝插值过渡;
- 同时引入注意力温控因子
修正随着上下文拉长 Softmax 熵增的平坦化趋势,无需大规模重训即可将模型上下文扩充数十倍。
- 计算各维度的有效波长
前端类比:CSS transform: rotate(θ)——每个通道对绕自己的中心旋转,两个元素的相对关系由角度差决定。
阶段二:RMSNorm——LayerNorm 的精简版
第7章的 LayerNorm 做两件事:去均值(中心化)+ 除标准差(缩放)。RMSNorm 砍掉了第一件:
| 维度 | LayerNorm | RMSNorm |
|---|---|---|
| 中心化(去均值) | ✅ | ❌ |
| 缩放 | ✅ | ✅ |
| 可学习参数 | 仅 | |
| 反向路径 | 3 条(分子/均值/方差) | 2 条(去掉均值路径) |
| 工程使用 | 原始 Transformer | LLaMA / PaLM / Mistral |
少一路计算、少一个参数,实践中效果几乎无差——这就是它成为现代默认 Norm 的原因。
阶段三:SwiGLU——带门控的 FFN
现代 LLM 的 FFN 不用 ReLU,用 SwiGLU:
逐个符号读:
工程细节:hidden 维度常取
阶段四:Tied Embedding——输入输出共用一张表
input  = token_ids [B, T]
embed  = wte[input]          # (V, D) 查表 → [B, T, D]
hidden = transformer(embed)  # [B, T, D]
logits = hidden @ wte.T      # 共享同一张 wte → [B, T, V]
"把 token 映射成向量"和"把向量映射回 token 概率"语义上是同一个空间的两个方向——所以 embedding 表和 LM head 可以共享同一权重。GPT-2 small 的词表 python/llm_train/model.py 默认 vocab_size=65, n_embd=64 下,embedding 表与 lm_head 几乎等大,共享节省接近 50%。反向时两处梯度自动累加,optimizer state 也减半。
为什么共享是合理的:概念、数值、参数三层论证
共享不是单纯为了省参数的权宜之计,三层各自独立地给出理由(论证化用自 Ernest Ryu, RL of LLMs (Spring 2025) Chapter 2 的 weight tying 讨论):
- 概念层:一个空间、两个方向。 输入侧查表(one-hot → 向量,token 进语义空间)与输出侧投影(向量 → 词表 logits,语义空间回到 token)是同一张"词表 ↔
维空间"映射的两个方向,彼此互逆。 把这种互逆直接写进参数:查表是取出第 行,tied 投影让第 个 logit 恰好等于第 行与末层向量的内积——同一批行向量,一个方向当索引用,另一个方向当判别器用。 - 数值层:随机矩阵的转置是近似逆。 把嵌入表记为
(与上面的 wte同一约定,第行是 token 的向量),tied 输出投影用的正是 本身。若 的各元素独立同 分布,则 (把 token 向量按列排布,同一句话写成 ,只是转置记法的差别;这个事实在压缩感知与字典学习里是标准工具。)按元素看:对角元是 个独立平方的平均,大数定律让它集中到 1;非对角元是 个独立乘积的平均,中心极限定理把波动压到 。也就是说,还没开始训练,各 token 的行向量就已近似等长、两两正交——"向量回词表"这一步天然是"词表到向量"的(缩放后的)逆方向。验证思路:取 A = np.random.randn(1024, 64),观察A @ A.T / 64的对角元均值与非对角元最大偏差如何随增大而收缩。训练之后这条近似不再精确成立,但起点上的几何合理性说明绑定是顺着初始分布性质的合理选择,不是任意约定。 - 参数层:整块删掉一个矩阵。 账在上一段已经算过:GPT-2 规模下 untied lm_head 约占三成参数,共享即整块消失;反向传播时查表与输出投影两处梯度自动累加到同一张表,optimizer state 同步减半。
下半部分 · 推理系统
阶段五:prefill/decode 与 KV Cache——生成慢的根源和解法
问题:生成第
解法:历史 token 的 K/V 一旦算出就不会再变(causal mask 保证了它们不依赖未来),所以把它们缓存下来,每步只算新 token 的 Q/K/V:
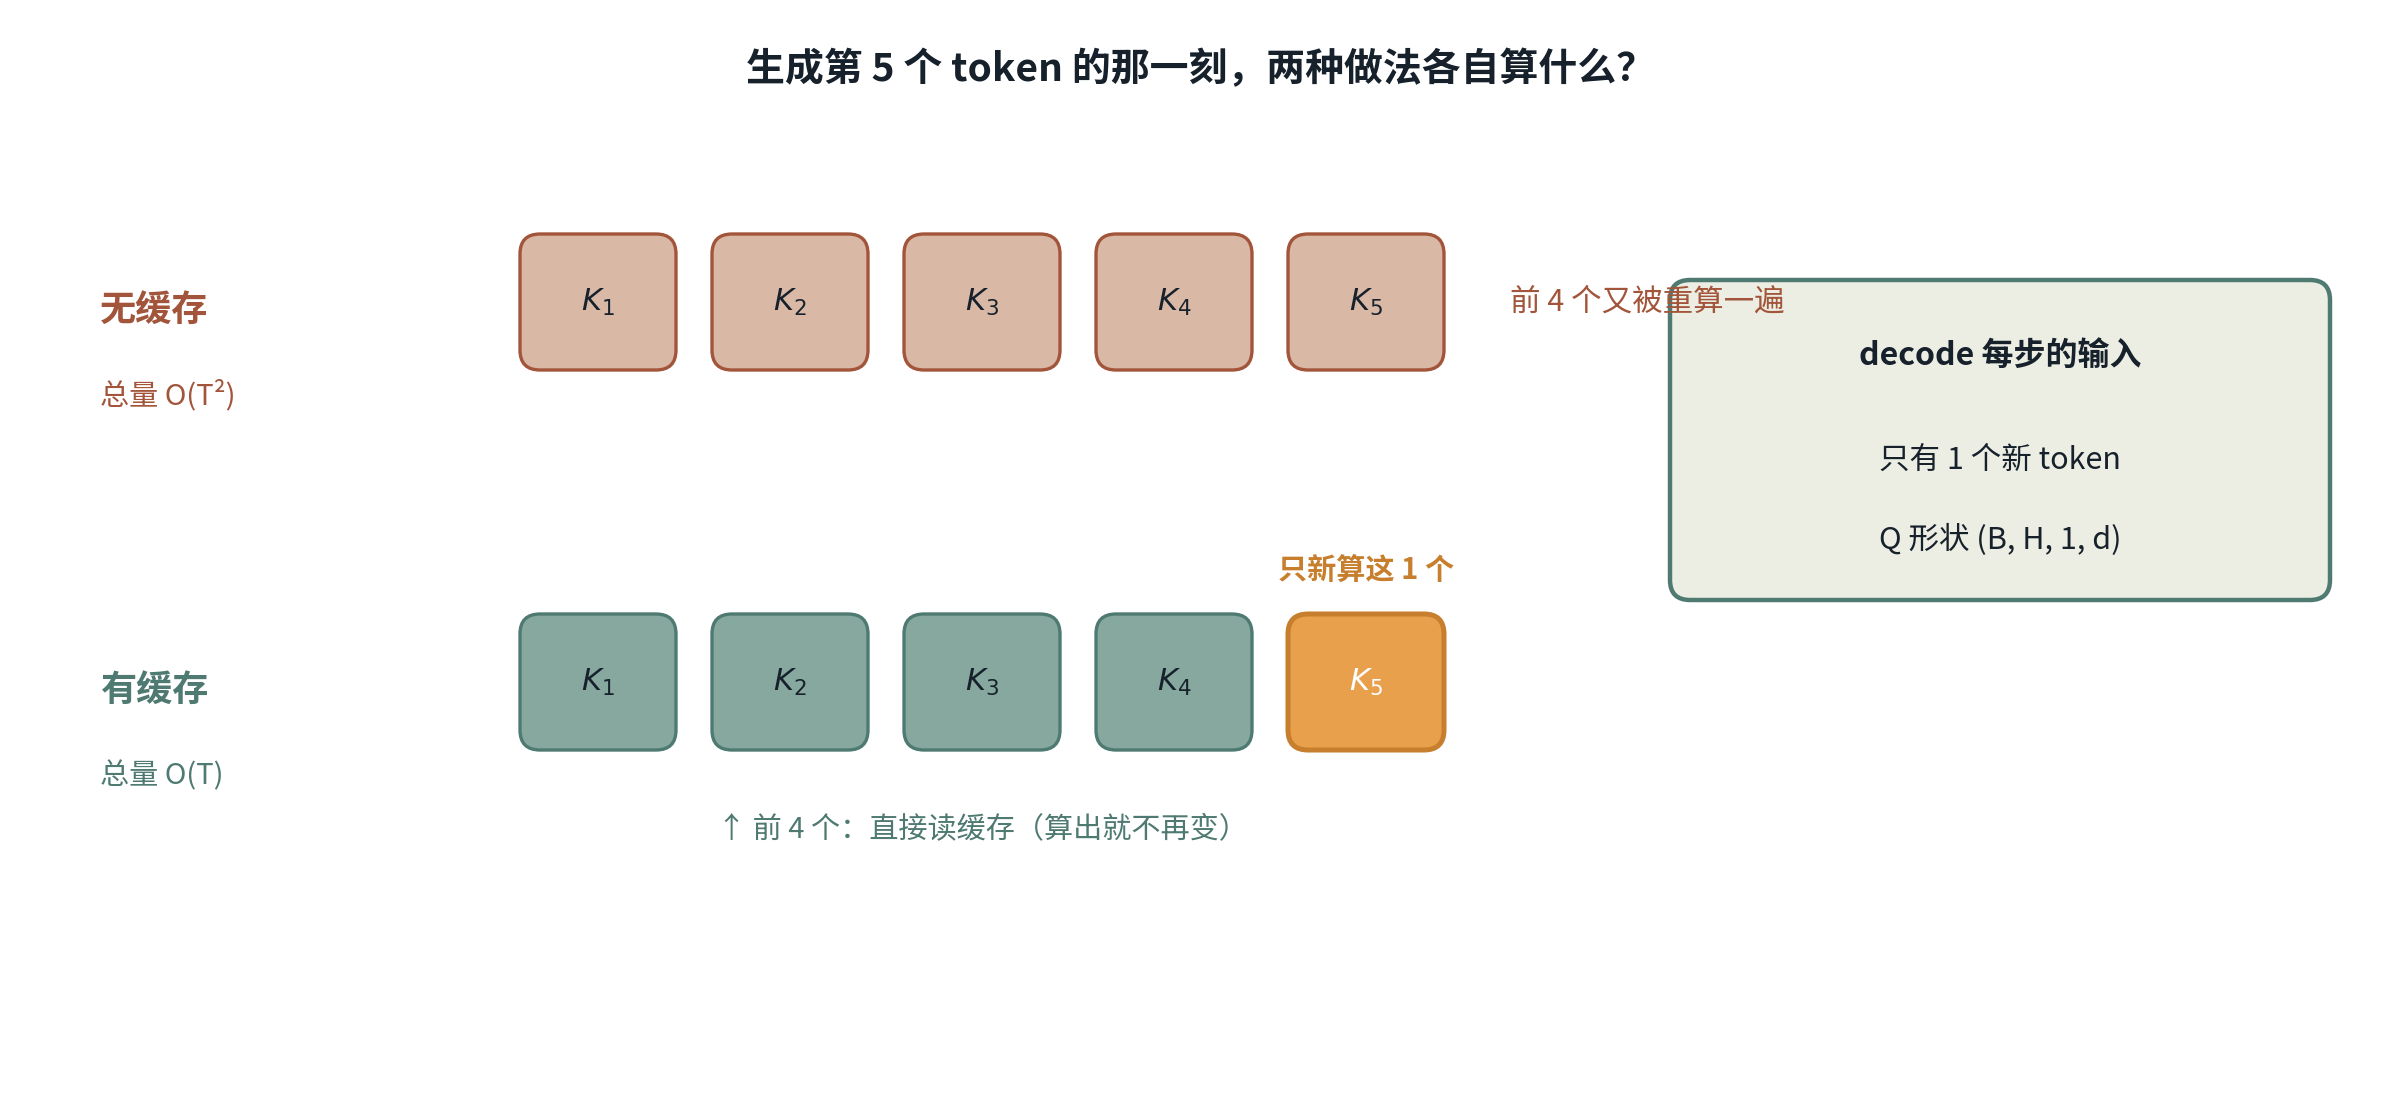
两个阶段因此分开:
- prefill:一次性处理整个 prompt,填满 cache——并行、计算密集;
- decode:每次只进来 1 个新 token,Q 是
(B, H, 1, d),从 cache 读出全部历史 K/V 做注意力——逐 token、访存密集。
Chip Huyen 的 Inference 物理学:显存墙与算力瓶颈剖析
在 Chip Huyen 的《AI工程》第 9 章中,揭示了大模型推理时的一个核心瓶颈:
| 阶段 | 输入形态 | 计算特征 | 瓶颈所在 | 用户可感知的指标 |
|---|---|---|---|---|
| Prefill 阶段 | 整个 Prompt(如 2000 个词) | 矩阵乘矩阵 (GEMM),大批量并行,GPU 核心完全吃满 | 算力受限 (Compute-bound) | TTFT (Time To First Token,首字延迟) |
| Decode 阶段 | 每次仅 1 个新 token | 矩阵乘向量 (GEMV),每次计算只用 1 个向量乘全量权重 | 显存带宽受限 (Memory-bound) | TPOT (Time Per Output Token,单字生成耗时) |
在 Decode 阶段,GPU 算力利用率通常暴跌到 1%~5%!庞大的 GPU 流处理器大部分时间都在“苦苦等待显存(HBM)把几十 GB 的权重和历史 KV Cache 搬运到芯片缓存中”。
TIP
因果机制第一问:为什么只有 Key 和 Value 需要被缓存,而 Query 绝不需要缓存?
初学者常问:“既然是 QKV 三个矩阵,为什么叫 KV Cache,而不是 QKV Cache?”
答案隐藏在自回归注意力的因果方向中:
- 在自回归解码中,生成当前第
个 token 时,模型只需要用当前最新位置的单向量 Query 去检索历史所有位置 的 Key 并加权读取对应的 Value; - 历史位置的 Query(
)在各自过去的生成步中已经彻底完成了历史使命,在未来的任何时间步都绝不会再被访问; - 但历史位置的 Key 与 Value,则必须作为被检索的知识基底,持续留存供未来所有新生成的 token 查询!因此,缓存 Key 和 Value 是数学与工程上完全充分且必要的,缓存 Query 纯属无意义的显存浪费。
算一算 KV Cache 到底有多占显存?
每个 token 的 Key 和 Value 都需要保存,公式如下:
其中第一个
真实震撼场景: 以 LLaMA-2 70B 模型为例(80层,采用 8 对 GQA 头,每头 128 维),如果一个企业服务同时处理 100 个并发请求,每个请求上下文为 4096 tokens:
光是存上下文的 KV Cache,就消耗了 268 GB 显存!这远超过了 70B 权重本身占用的 140 GB 显存! 这就是为什么必须有 GQA(阶段六)和 PagedKV(阶段七)——它们直接决定了大模型服务的生死成本。
等价性必须用对拍证明:同一权重、同一序列,逐 token 增量 decode 的 logits 必须与一次性全量前向在数值容差内一致。cache key、position 单调递增、容量边界都要是显式契约——append 时把 position 重置是经典故障(RoPE 相位错乱)。
前端类比:增量渲染缓存——命中旧状态就不用重算,但缓存键、失效条件和容量边界必须显式定义。
阶段六:MQA/GQA——给 KV Cache 瘦身
KV Cache 的大小 = 层数 × 头数 × 序列长度 × head_dim × 2(K+V)。标准 MHA 每个 query head 有自己独立的 K/V head。GQA 让多个 query head 共享同一组 K/V;MQA 是极端情况:全部 query head 共享一组。
效果:缓存大小从 H_q % H_kv == 0,且 repeat 的顺序要固定(错位是故障表第一项)。
MLA 缓存大小的基线约定
在比较 MHA / GQA / MLA 的 KV Cache 大小时,需要先约定 head_dim 的取值。标准 MHA 的 baseline 假设 K 和 V 的 head_dim 相等;对于 DeepSeek-V3,查询和键的 head 维度是 192(qk_nope_head_dim = 128 + qk_rope_head_dim = 64),如果 MHA baseline 把 K 和 V 都按 128 计算,则每头每 token 缓存
MLA 的 cache 独立于 query head 数的原因:DeepSeek-V3 的解耦 RoPE key 是所有 head 共享的单个 64 维向量(不是每头一份)。MLA 每 token 每层缓存总量固定为 kv_lora_rank + qk_rope_head_dim = 512 + 64 = 576,与 query head 数无关——这 576 维是压缩后的 latent KV,通过下层线性层解压为 per-head 的 K/V 后再做 attention。不要试图把 576 拆成"每头的某个数"——它本身就是压缩后的总维度。
滑动窗口注意力(Sliding Window Attention)
标准 causal attention 让每个 token 看见全部历史,复杂度
掩码定义:
效果:KV Cache 可以截断为最多
注意:score 矩阵仍然在窗口内做完整计算——节省的是 KV Cache 容量和带宽,不是窗口内的 FLOPs。score 的
clean_room/swa.py 是选学练习场(其 所属章节 现标注为本节;该文件未登记进 clean_room/contracts.json,只作为概念阅读材料),本章不实现滑动窗口注意力。
推测解码(Speculative Decoding)与拒绝采样无损证明
自回归生成的本质物理瓶颈是显存带宽受限(Memory-bound)与串行依赖:每生成 1 个 token 都必须把全量几十 GB 的权重从显存搬到计算核心,计算强度极低(Arithmetic Intensity
推测解码(Leviathan et al. 2023,arXiv:2211.17192)用一个小而快的草稿模型(Draft Model,如 0.5B)快速串行提出
推测解码的一个关键理论性质是无损保真(Lossless Guarantee):虽然候选词由较小模型提出,但最终生成的概率分布与目标大模型独立生成的理论分布严格一致,不存在语义劣化。
核心数学证明(基于 Metropolis-Hastings 拒绝采样)
设当前位置草稿模型的预测概率分布为
- 接受分支的发生概率: 从草稿采样出
且被接受的联合概率为: - 拒绝重采样分支: 该候选词被拒绝的总概率为
。当发生拒绝时,算法强制从截断差分分布中重新采样一个 token: - 边缘分布完全守恒: 把接受与拒绝重采样两路联合概率相加,总概率为:
无论草稿模型有多小、猜得有多差,最终输出的概率分布在数学上与大模型独立生成的分布严格恒等。在工业界(如 vLLM 与 TensorRT-LLM),推测解码通常能带来 2~3 倍的无损端到端吞吐提升。
clean_room/spec_decode.py 是选学练习场(其 所属章节 现标注为本节;该文件未登记进 clean_room/contracts.json,只作为概念阅读材料),本章不实现推测解码。
FlashAttention 与在线 Softmax(斯坦福 CS336 核心:IO 感知与分块计算)
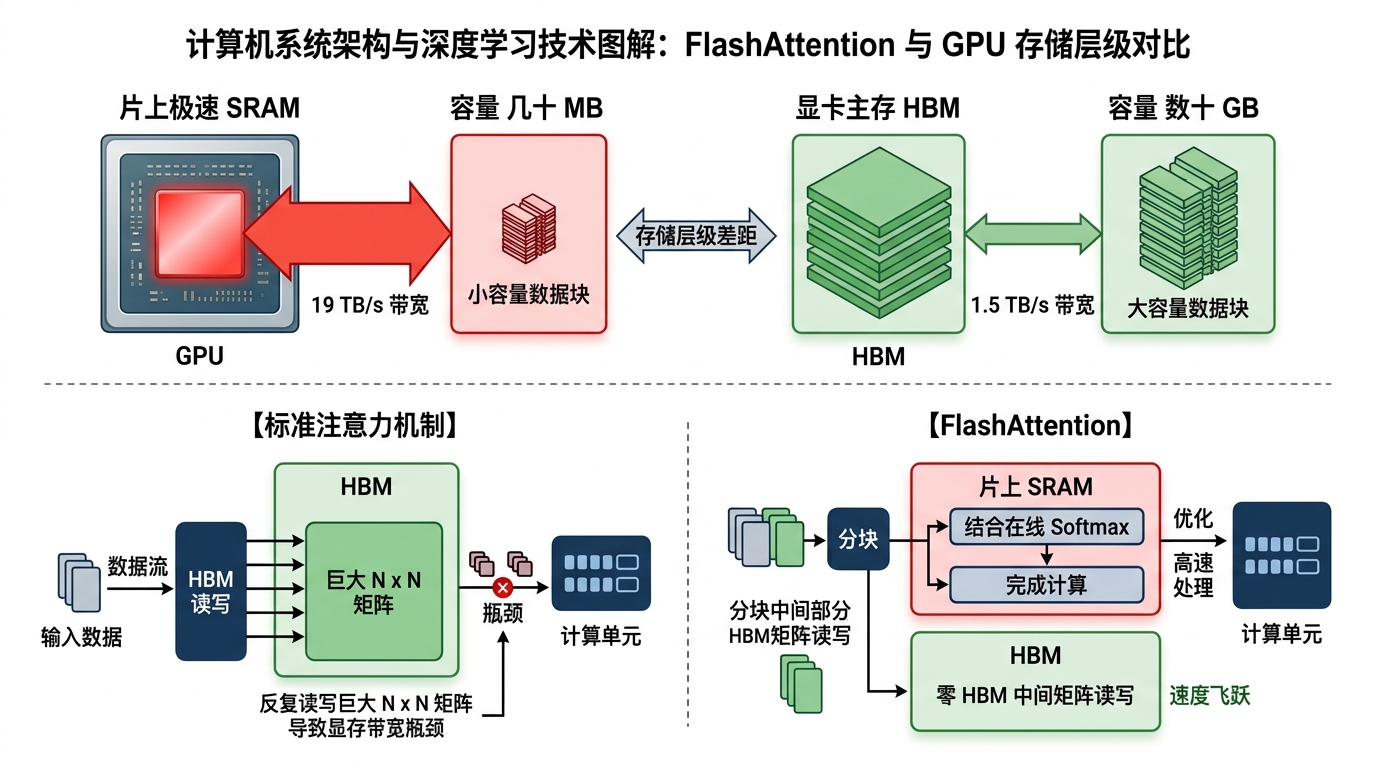
长文本注意力计算的最大痛点不是算力不够,而是显存带宽墙(Memory IO Bottleneck):
1. 现代 GPU 的物理存储金字塔
- HBM(High Bandwidth Memory,高带宽主显存):容量大(40GB~80GB),但带宽有限(约
); - SRAM(片上静态缓存):集成在 GPU 流处理器核心内部,容量极小(单卡仅几十 MB),但带宽高达惊人的
(速度快近 10 倍!)。
2. 标准 Attention 的
标准 Attention 计算:
当序列长度
3. FlashAttention(Dao 等,2022)的第一性原理破局
Tri Dao 等人提出了 IO-Awareness(硬件 IO 感知) 思想:彻底禁止在 HBM 中实体化中间矩阵
要做到这一点,最大的数学拦路虎是 Softmax: 标准 Softmax 必须遍历整行求得全局最大值
4. 在线流式 Softmax(Online Softmax)数学递推(高中指数与分数运算)
设当前已扫描的前序块最大值为
- 更新全局最大值:
- 对旧分母进行尺度补偿并合并:
- 输出向量流式动态重归一化:
震撼的工程价值:
- 依靠这个简单的指数幂次换底公式,GPU 仅在几十 MB 的快速 SRAM 中分块滑动,随算随扔;
- 分块之后,注意力的数学输出与整行 softmax 相同。少掉的是把
的 和 写入 HBM。它不是稀疏注意力,也不单独把训练时见过的上下文长度拉长。
分块预填充(Chunked Prefill)与连续批处理调度
一个长 prompt 的 prefill 可能包含几千个 token,一次性处理会阻塞调度器——期间新请求无法进入 decode 阶段,导致集群已在运行的会话出现严重的 Token 间延迟(Inter-token Latency, ITL)抖动与卡顿。
分块预填充(Chunked Prefill)(如 Sarathi-Serve、vLLM v0.6+)将超长 Prompt 切割为固定大小的 Chunk(如 512 个 Token)。调度器在每一次迭代中,把一个 Prefill Chunk 和其他处于 Decode 阶段的会话动态拼接在同一个 Batch 内(Piggybacking 策略):
- 抹平算力利用率波谷:Decode 阶段极度依赖显存带宽(Arithmetic Intensity 极低),而 Prefill Chunk 属于计算密集型(Compute-bound)。两者混编恰好互补,使 Tensor Core 和 HBM 带宽同时处于高饱和利用状态;
- 消除调度气泡:Decode 请求无需等待数秒完整的 Prefill 结束,可在每个 Chunk 间隙持续吐出 Token,首字延迟(TTFT)与每字耗时(TPOT)得到稳定保障。
因果掩码在分块时必须保持严格因果:chunk 2 中的 token 只能看到 chunk 1 及之前的内容,绝不能看到 chunk 3。python/llm_core/kv_cache.py 的 incremental_attention 天然支持分块输入,并通过 cols <= rows 校验因果正确性。
Speculative Decoding(投机采样解码):打破显存带宽墙
在标准自回归生成中,解码面临著名的显存带宽墙(Memory-Bandwidth Wall):
- 模型每生成一个 Token,必须将数百亿参数从 HBM 完整加载到 SRAM 一遍;
- 在单 Batch 下,计算一个 Token 仅耗费微秒,绝大部分时间都在干等显存搬运(Arithmetic Intensity
FLOPs/Byte)。
投机采样(Speculative Decoding)(Leviathan et al., 2023)给出了颠覆性的破局解法:“小模型打草稿,大模型批量校验”。
1. 核心思想与数学保证
在观察下方流程图前,请先思考一个关键定理:投机采样加速后的文本,会改变大模型的输出分布甚至降低生成质量吗?
答案是:数学上保证 100% 无损对齐!
图:投机采样解码 Draft-Verification 交互流 — 核心机制与数学推导如下:
- ① 轻量草稿:由一个参数量仅为目标模型几分之一的小模型(Draft Model,如 1B 参数草稿模型配合 70B 目标模型)极速自回归吐出
个草稿 Token; - ② 单次批量前向:目标大模型(Target Model)不再单步自回归,而是将这
个草稿 Token 打包进同一个前向计算(GEMM 矩阵乘法)!因为矩阵乘法是 Compute-bound,校验 个 Token 的耗时几乎等同于生成 1 个 Token; - ③ 拒绝采样准则(Rejection Sampling Criterion): 对草稿提出的每个 Token
,若: 则接受该 Token;一旦某个位置被拒绝,立即截断后续草稿,并从调整后的修正残差分布 中重新采样一个正确 Token; - ④ 加速比闭环: 若平均接受率为
,单步期望生成的有效 Token 数为 。当草稿开销 且接受率 时,端到端延迟降低 2~3 倍!(白盒代码见 python/llm_core/speculative_decoding.py的SpeculativeDecodingEngine)。
KV Cache 量化
权重量化压缩的是模型参数,KV Cache 量化压缩的是推理时的中间状态——这些状态在 decode 阶段占用的显存往往超过权重本身。把缓存的 K/V 从 FP16 量化为 INT8 或 FP8,直接减少内存带宽压力(decode 是 memory-bound),质量损失通常远小于对同等精度权重量化的损失,因为 K/V 的数值分布比权重更集中。
KV Cache 量化与权重量化正交:两者可以独立选择精度,也可以组合使用(例如 INT8 权重 + FP8 KV Cache)。量化粒度可以是 per-tensor 或 per-head——per-head 粒度更能适应不同 attention head 的数值动态范围。
阶段七:PagedKV——操作系统的虚拟内存思路
传统 KV Cache 为每个请求连续分配 最大长度 × 层 × 头 × 维 × 2 的显存——请求长短不一,大量浪费和碎片。PagedKV(vLLM 的做法)借操作系统虚拟内存的思路:
text
把 cache 切成固定大小的 block(如 block_size = 16 个 token)
每个请求维护一张 block_table:逻辑块号 → 物理块
按需增长、用完即还,碎片几乎为零
多个请求共享相同 prefix 时,直接共享物理块| 对象 | 传统连续分配 | PagedKV |
|---|---|---|
| 内存分配 | 一次性按最大长度 | 按 block 增长 |
| 碎片 | 长短不一浪费严重 | 几乎为零 |
| 共享 prefix | 难 | 容易(共享 block table) |
前端类比:IndexedDB 的分页存储,或无限滚动列表的"虚拟化"——逻辑地址映射到物理页帧。
从 PagedKV 到 SGLang Radix Cache:为什么我们需要前缀树?
你可能会问:既然 PagedKV 已经有了共享 block table 的能力,为什么工业界(如 SGLang)还要大费周折构建一棵 Radix Tree(基数树/紧凑前缀树)?
答案在动态多轮对话、Few-shot 模板与树状解码的分支爆炸。vLLM 原版的 Prompt Cache 采用简单的 Chunk 哈希:它把 Prompt 切成固定 16 个 token 的块,为每个块计算哈希值存入扁平哈希表。这带来两个致命局限:
- 边界对齐惩罚:只要用户 Prompt 在开头多敲了一个空格,后续所有 16-token 块的哈希值全部错位,导致缓存全盘失效;
- 分支管理失控:在 Agent 多步推演、投机采样或并行采样(Tree of Thoughts)时,多次请求呈现复杂的树状分叉。扁平哈希表无法表达父子依赖关系,更无法在显存吃紧时优雅地自底向上回收叶子节点。
微观数据结构:Radix Trie 内存拓扑
SGLang 采用基数树来管理物理 KV Block。树的边存储一段连续的 Token ID 列表;节点保存对应的物理块编号句柄(Block Indices)、活跃请求引用计数(ref_count)与最后访问时间戳(last_access_time):
text
┌─────────────────────────────────────────────────────────────┐
│                   Radix Tree 根节点 (Root)                   │
└──────────────────────────────┬──────────────────────────────┘
                               │ Edge: [101, 2054, 2003] ("System Prompt")
                               │ Blocks: [Block_0, Block_1]
                               ▼
               ┌───────────────────────────────┐
               │    公共前缀节点 (Node A)      │
               │    ref_count = 2 (被两个会话锁定)│
               └───────┬───────────────┬───────┘
                       │               │
      Edge: [1037, 3899]               │ Edge: [9999, 8888]
      Blocks: [Block_2]                │ Blocks: [Block_3]
      ("User Q1")                      │ ("User Q2")
      ▼                                ▼
┌───────────────────────────┐    ┌───────────────────────────┐
│     分支叶子 (Node B)     │    │     分支叶子 (Node C)     │
│     ref_count = 1         │    │     ref_count = 0 (可回收)│
└───────────────────────────┘    └───────────────────────────┘
最长前缀匹配(LPM)与生命周期闭环
当一个新请求到达推理引擎时,执行以下生命周期流转(我们在 python/llm_core/radix_cache.py 中提供了完整的白盒实现):
- 最长前缀匹配(LPM):从根节点出发,沿边逐 Token 匹配。若某条边部分匹配,系统会自动将该边在分叉处**分裂(Split)**成父子两个节点;
- 零拷贝复用:匹配到的整块物理 Block 直接映射给新请求的逻辑页表,新请求的 Prefill 阶段彻底跳过命中部分,仅对剩余后缀发起计算;
- 引用计数写保护(
acquire/release):只要有请求正在基于该节点进行自回归 Decode,该节点及其所有祖先节点的ref_count > 0,处于写保护态,严禁任何机制将其驱逐; - 树形 LRU 淘汰(Tree-based Eviction):当 GPU 显存耗尽时,系统递归扫描
ref_count == 0的候选叶子节点,挑选last_access_time最老的冷叶子优先回收物理显存块;当父节点下仅剩单一子分支时,触发合并折叠(Merge)。
分级 KV 缓存(Tiered Storage)与 Terark/HiCache:跨越百倍带宽鸿沟
在日调用数十亿 token 的高并发生产系统中,GPU 显存(HBM)极其昂贵。哪怕配置了 H200(141GB HBM3e),数千个并发的长上下文请求也会瞬间把显存打满。为了避免请求被拒绝排队,工业界(如 HiCache、TerarkKVCache)引入了多级缓存层次结构(Tiered Storage):
工程痛点与带宽 Trade-off: GPU HBM 的内部读取带宽(4.8 TB/s)与跨 PCIe Gen5 x16 的传输带宽(实测约 55 GB/s)之间存在近 100 倍的断崖式差距!
- 如果盲目把冷 KV Cache 换出到 CPU 内存或本地 SSD,再次换入时耗费的总线传输时间,甚至可能比 GPU 重新执行一遍 Prefill 还要慢;
- TerarkKVCache 的核心解法:引入可检索的高压缩比结构,在 Host 侧将 KV Cache 压缩 2~4 倍,用微不足道的 CPU 解压时间换取总线传输吞吐翻倍,显著拓宽了 Offload 的收益区间。
多级缓存收益黄金不等式(The Golden Inequality of Tiered Caching)
究竟在什么场景下,从次级存储加载 KV 才能产生正收益?我们进行形式化推导:
设前缀命中的 Token 数量为
从次级存储加载该段 KV 的耗时为:
在当前 GPU 上重新执行 Prefill 的计算耗时为:
多级缓存产生正收益的充要条件为加载时间小于重算时间:
两边同时约去命中的序列长度
核心洞察与证伪分析:
- 与匹配长度
完全无关:只要硬件带宽与模型吞吐的比值满足该不等式,无论命中 100 个 token 还是 10,000 个 token,加载始终优于重算! - 压缩架构的威力:
- 对于普通 MHA 大模型(如 70B MHA),
高达数兆字节, 的门槛极低;如果 GPU Prefill 算力充足,重算甚至比从 PCIe 搬运更快! - 但当模型采用 SWA(滑动窗口) 或 MLA(低秩压缩,如 DeepSeek-V3 的
维) 时, 暴降至原本的 !这使得临界吞吐阈值 提升了数十倍,让 Host DRAM 甚至分布式 RDMA 存储的 Offload 性价比暴增!我们在 python/llm_core/tiered_cache_model.py中对此进行了完整的定量检验。
- 对于普通 MHA 大模型(如 70B MHA),
高并发服务调度权衡四角
PagedKV 解决“显存怎么放”,多级存储解决“放不下放哪里”,而推理服务的控制中枢是批处理调度器。
在高并发在线服务中,调度器面临四个核心指标的极端张力(权衡四角):
text
               总吞吐 (Throughput / TPS)
                       ▲
                      / \
                     /   \
                    /  ★  \
                   / 调度平衡 \
                  /         \
首字延迟 (TTFT) ◄────────────► 字间延迟 (TPOT)
                  \         /
                   \       /
                    \     /
                     \   /
                      ▼
显存/算力释放速度 (Release Velocity)- 总吞吐(Throughput / TPS):每秒系统完成生成的总 Token 数量。追求极限吞吐需要尽可能拉大 Batch Size,但这会拉长每次迭代时间;
- 首字延迟(TTFT, Time To First Token):用户从发送请求到看到第一个字的时间。由排队等待时间与 Prefill 计算时间决定。大 Batch 会导致新请求在队列中严重积压;
- 字间延迟(TPOT, Time Per Output Token):Decode 单步迭代时间。受限于 GPU 显存带宽;Batch 越大,读取权重的单步延迟越长,TPOT 劣化;
- 显存释放速度(Memory Release Velocity):请求完成并交还物理显存块的速率。长短请求混杂时,超长请求会长时间霸占槽位和 KV 块(长尾效应),阻碍新请求进入,导致队头阻塞(Head-of-Line Blocking)。
工程解法:Chunked Prefill 与 Decode 优先调度:
- 静态批处理中,Prefill 是整块执行的,大 Prompt 会直接打断所有正在进行的 Decode,导致 TPOT 发生剧烈抖动(Jitter);
- 现代调度器实行 Chunked Prefill:将大 Prompt 切成固定大小的 Chunk(如 512 tokens),在每次迭代中强行优先执行 Decode 步,再用剩余显存与算力时间切片塞入一个 Prefill Chunk。这在保障 TPOT SLA(如
)的前提下,平滑了 TTFT。
AI Configurator 算子 Latency 建模:实测、SOL 与 MAPE < 10%
在超大规模集群中,调度器与自动配置器(AI Configurator)需要在请求下发前,毫秒级预测出任意输入 Shape
1. 数据来源三元组
- 实测基准(Empirical Microbenchmark):基于离线网格搜索,使用 CUDA Event 在真实卡上测量典型 Shape 的实测耗时表;
- SOL 理论值(Speed of Light / Roofline):基于硬件物理规格计算出的理论下界:
- 网格参数插值(Bilinear/Spline Interpolation):对稀疏实测网格之间未覆盖的 Shape 进行双线性插值,并在边界结合 SOL 外推。
2. 如何将预测误差控制在 MAPE < 10%
平均绝对百分比误差(MAPE)定义为:
要做到工业级
- 常数发射延迟(Kernel Launch Overhead):CPU 侧驱动下发与 GPU 响应有固定的
延迟。在极小 Shape 下,这一常数项甚至占总耗时的 50% 以上; - 硬件波浪量化效应(Wave Quantization / Tail Wave Effect): GPU 由固定数量的流式多处理器(SM)组成(如 H100 拥有 132 个 SM)。若算子网格划分出的 Thread Blocks 数量为 133,前 132 个 Block 会占满所有 SM 并行跑完第一波(Wave 1),而剩下的 1 个 Block 必须独占一个 SM 跑第二波(Wave 2),其余 131 个 SM 全程闲置!这种尾浪惩罚会导致时延阶梯状突增,Cost Model 必须显式对齐
。
手写公式全景:MHA/GQA/MLA 在 TP 下的切分与 MQA 陷阱
面试官要求手推的通用 KV Cache 显存公式:
:Key 与 Value 各存一份; :并发批大小(Batch Size); :上下文序列长度(Sequence Length); :KV 注意力头数(MHA 时 ;GQA 时 ;MLA 时直接退化为固定维度); :Head Dimension(通常为 128); :数据类型(BF16/FP16 为 2,FP8 为 1); :Transformer 层数。
张量并行(TP)下的切分与工业陷阱
在多卡部署时,若采用张量并行(Tensor Parallelism,度数为
- 注意力头被均匀切分到各卡上,单卡本地维护的头数为
; - MHA 与典型 GQA:单卡 KV Cache 显存开销严格线性缩减为原来的
。
致命工业陷阱:MQA 与极小 GQA 的广播复制退化:
- 如果模型采用 MQA(
),或者 GQA 的头数小于 TP 度(如 而 ),头数在数学上无法整除 TP 度; - 此时各卡无法做张量切分,引擎被迫在所有卡上全量复制广播这一份 KV Cache;
- 后果:此时哪怕把 TP 从 1 堆到 8,单卡的 KV Cache 显存占用完全没有减少一分一毫!这是大模型架构选型与并行切分中极为隐蔽的性能杀手。
手写 C++:LRU Cache 的工业级实现
在推理引擎的显存分配器底层(如 PagedKV 的 Block 回收与多级存储换出),最基础的数据结构是双向链表加哈希表的 LRU Cache。我们在 python/labs/lru_cache.cpp 提供了现代 C++17 完整实现:
cpp
template <typename Key, typename Value>
class LRUCache {
public:
    std::optional<Value> get(const Key& key) {
        auto it = map_.find(key);
        if (it == map_.end()) return std::nullopt;
        // O(1) 将命中节点切移至表头,零内存重分配
        items_.splice(items_.begin(), items_, it->second);
        return it->second->second;
    }

    std::optional<Key> put(const Key& key, Value value) {
        auto it = map_.find(key);
        if (it != map_.end()) {
            it->second->second = std::move(value);
            items_.splice(items_.begin(), items_, it->second);
            return std::nullopt;
        }
        std::optional<Key> evicted = std::nullopt;
        if (items_.size() >= capacity_) {
            evicted = items_.back().first;
            map_.erase(items_.back().first);
            items_.pop_back(); // 淘汰最冷节点
        }
        items_.emplace_front(key, std::move(value));
        map_[key] = items_.begin();
        return evicted;
    }
private:
    size_t capacity_;
    std::list<std::pair<Key, Value>> items_;
    std::unordered_map<Key, typename std::list<std::pair<Key, Value>>::iterator> map_;
};
连续批处理:让每个解码步都花在有效请求上
PagedKV 解决"显存怎么放",推理服务的另一半是"请求怎么排"——连续批处理(continuous batching,也叫 iteration-level batching)。
| 维度 | 静态批处理(Static Batching) | 连续批处理(Continuous Batching / Orca) |
|---|---|---|
| 批的形状 | 组批后固定不变 | 每次 decode 迭代重新组批 |
| 先完成的请求 | 槽位和 KV 显存等到批内最长的请求跑完才释放 | 立刻出队,物理块立即回收 |
| 新请求入场时机 | 整批结束后 | 随时可以插入下一轮迭代 |
| 显存碎片 | 高(长短不一的请求固定分配) | 低(PagedKV 的 block 粒度按需释放) |
| 调度器复杂度 | 低 | 每步重算 batch 组成,是显式旋钮 |
| 吞吐 | 低(大量空转) | 高(每步都有有效请求) |
| 首 token 延迟 | 差(新请求等整批) | 更好(随时可入队) |
静态批处理把一批请求凑齐后一起跑,批的形状在组批那一刻就固定:先生成完毕的请求,其槽位和 KV 显存也要等到批内最长的请求跑完才能释放,期间的解码步还在为已完成的槽位空烧算力;新请求只能等整批结束才能入场。连续批处理(Orca 提出的 iteration-level re-packing)把调度粒度降到每次 decode 迭代:每步重新组批,先完成的请求立刻出队并释放物理块,新请求随时入场。vLLM 正是把 PagedKV 的按块分配与这套调度组合起来,成倍推高了服务吞吐。代价在调度器本身:每步都要重算 batch 组成,"同时在批里跑多少请求"成了显式旋钮——批塞得越满吞吐越高,但单步解码随之变慢,排队新请求的首 token 延迟(TTFT)与在场请求的出词间隔都被拉长,需要按业务目标权衡。Chip Huyen《AI工程》第 9 章把"模型优化"与"推理服务优化"分开讨论——本章的量化与 KV 瘦身属于前者,这里的批处理调度属于后者。
阶段八:量化——用更少位数存权重
本章量化的覆盖范围分两层:python/llm_core/post_training.py 保留 per-tensor 对称 INT8 / INT4 基线;python/llm_core/gptq.py 增加真实打包的 group-wise INT4 与 GPTQ-style 顺序误差补偿。后者只复现可在 NumPy/CPU 中检验的校准 Hessian、阻尼、逐列量化和误差传播,不复现上游 blockwise CUDA kernel、模型接入或端到端服务栈。AWQ、GGUF、NF4、FP8 仍是对照术语,不在本仓库实现。
16-bit 浮点权重压成 8-bit(INT8)或 4-bit(INT4),模型体积和带宽直接减半再减半。核心机制:
- scale/zero_point:每组权重记录一个缩放因子,存储整数、计算前反量化回浮点;
- 信息损失:第3章的视角——每个权重的自信息从 16 位降到 8/4 位,丢失量 ≈ 量化前后的熵差;
- 校准(calibration):用一小段代表数据估计最优 scale——思想上和
mle_bernoulli的"用样本估计参数"同构。
从 per-tensor 到真实 packed group-wise INT4
per-tensor 只给整张矩阵一个 scale。若少量离群值拉高动态范围,其余权重能使用的离散刻度会变粗。group-wise weight-only 量化把输入列切成组,并为每个“输出行 × 列组”保存一个 scale:
[ s_{r,g}=\frac{\max_{j\in g}|W_{r,j}|}{7},\qquad q_{r,j}=\operatorname{clip}\left(\operatorname{round}(W_{r,j}/s_{r,g}),-8,7\right) ]
quantize_groupwise 随后把两个 signed INT4 的二进制补码 nibble 合进一个 uint8。因此 packed.nbytes 是真实 payload,不是把 int8 数组的逻辑位宽写成 4。代价是 scale metadata:组越小,局部动态范围越贴合,scale 数量也越多。nbytes 同时计入 packed payload、float32 scales 与非恒等 permutation,避免只报理想的“4 bit/weight”;它不计 Python 对象、shape、bits、method 等固定控制元数据,所以课程证据把该口径称为 payload_plus_scales_bytes,不称序列化总字节。
GPTQ-style 顺序误差补偿
量化单个权重的绝对误差不等于线性层输出误差。给定校准输入 X,本课用
[ H=\frac{X^\top X}{N}+\lambda I ]
近似输入方向的重要性。每量化一列,就用 H^{-1} 中该列与尚未量化列的耦合,把当前重建误差传播到后续列。damping 产生的 \lambda I 不是装饰参数:校准样本重复或样本数少于输入维度时,X^T X 会秩亏;无阻尼实现必须被门禁拒绝。开启 act_order 时按 Hessian 对角线从大到小处理列,并在反量化时按 permutation 恢复原始输入列顺序。
这里使用 “GPTQ-style” 是有意的边界声明。GPTQ 论文与官方实现还包含 blockwise 分解、static groups、true-sequential、模型适配与专用低比特 kernel;本课只实现能独立重建和验证的最薄机制。AWQ 作为 activation-aware 对照保留在论文索引中,本切片没有实现 AWQ 搜索。
质量、体积与性能要一起读
固定 seed=5940 的 gate fixture 中,FP32 权重为 384 bytes;INT4 payload 为 48 bytes,含 group scales 后为 144 bytes。group-wise round-to-nearest 的校准输出 MSE 为 0.1801436422,GPTQ-style 为 0.1578135745。这些是合成矩阵实测值,只证明这一个 fixture 上的输出误差变化,不能外推为真实模型 perplexity。
python scripts/benchmark_gptq.py 在 64×64 权重上同时记录 bytes、output MSE、量化耗时和端到端调用耗时。当前 NumPy 路径没有 packed INT4 matmul kernel:它需要先反量化再执行浮点矩阵乘,因此可能比直接 FP32 更慢。压缩存储、算法质量与推理吞吐是三个不同结论;只有接入真实低比特 kernel 并在目标设备测量,才能声称速度提升。
本轮的 MIT 6.5940 主题取舍、信源定位、延期/排除边界与 ROI 重算见覆盖差距审计;本机指标见 evidence/10-advanced-quantization-v1.json。
推理系统的多目标权衡:显存-吞吐-精度的帕累托前沿
无论是把注意力头从 MHA 压缩为 GQA/MLA,还是把权重从 FP16 压至 INT8/INT4,亦或是通过连续批处理拉大并发,现代推理架构的本质都是在**显存占用、端到端吞吐、首字延迟与生成质量构成的帕累托前沿(Pareto Frontier)**上寻找工程平衡点:
- 精度 vs 显存前沿(Quality vs. Memory Footprint):FP16 保持 100% 完整精度但显存庞大;粗暴的均匀 INT4 量化虽大幅省显存但可能诱发困惑度陡增。AWQ(保护激活显著权重)和 GPTQ(按二阶泰勒展开补偿权重误差)等工业量化算法的核心价值,就是在同等压缩比下把困惑度损失降到最低——将“精度-显存”的帕累托前沿整体向外推移。
- 吞吐 vs 延迟前沿(Throughput vs. Latency):增大 batch size 可以充分利用 GPU 算力使总吞吐(tokens/sec)翻倍,但排队和显存搬运会劣化单请求的交互延迟(TTFT 与 TPOT)。生产部署不是追求单一维度的极限,而是在满足交互 SLA(例如 TTFT
)的硬约束下,在前沿上寻找吞吐量最大的配置点。
推理阶段的 shape 契约:
| 对象 | shape | 说明 |
|---|---|---|
| Q | (B, H_q, T_new, d) | decode 时 T_new 常为 1 |
| K/V cache | (B, H_kv, T_cache, d) | MQA/GQA 中 H_kv ≤ H_q |
| attention weights | (B, H_q, T_new, T_cache) | position 必须单调递增 |
| quantized weight | packed (out × in / 2) bytes + (out, groups) scales | 记录 bits、group size、metadata bytes、误差与 kernel 边界 |
一次权重读取能换来多少运算
本章前面已经建立了 prefill 与 decode 的分工、KV Cache、FlashAttention 的分块、连续批处理、量化和推测解码的接受/拒绝证明。Akshay Pachaar 在 2026-08-13 的这篇帖子补上的是一张可手算的账:峰值算力除以显存带宽得到脊点,一次 decode 的运算量除以它从主存搬走的字节得到算术强度。工作负载落在脊点的哪一侧,决定下一步该加算力还是该减字节。这张图叫 roofline。
帖子用 H100 SXM5 做例题,输入与 python/llm_core/roofline.py 的 decode_roofline 相同:稠密 BF16 峰值
这条上限没有把 KV Cache 的字节算进去,也没有把 kernel 启动开销算进去。量化减少每个权重的字节,算术强度和这条 batch 为 1 的出词上限一起提高。连续批处理增加同一次读取所服务的序列数,算术强度和整批总吞吐一起提高;decode_roofline 返回的这条上限按单条序列计算,batch 从 1 换成 512 时数值不变。带宽加倍,上限加倍;每个权重的字节减半,算术强度和上限一起加倍。
2026-09-23 核对 NVIDIA 的 H100 产品页:H100 SXM 的显存带宽是 3.35 TB/s,与例题一致。同一张表里的 BFLOAT16 Tensor Core 是 1,979 teraFLOPS,脚注写明 With sparsity。页面没有另印一行 dense BF16。例题里的 989 是帖子采用的无稀疏数字,等于该行带稀疏数字的一半再取整(
监控里的高 utilization 表示调度器已经把工作派到芯片上。算术单元有没有在做有效浮点运算,要另看实际 FLOP/s 离峰值有多远。带宽接近自己的上限而算力远低于峰值,是访存受限;算力接近峰值而带宽远低于上限,是计算受限。两条上限都没有碰到,是第三种情形:开销占主导,常见来源是大量很小的 kernel 启动。
帖子把已经讲过的手段收成两步,这里只指向本章对应的小节:
- 提高每个被取字节上的运算量。连续批处理把多个请求叠在同一次权重读取上;FlashAttention 的分块把一块数据留在片上做完再用。
- 减少被取的字节。量化直接降低每个权重的字节数。算子融合让中间结果留在片上,连续布局让一次取回的块都被用上;这两件事在本章里就是 FlashAttention 拒绝把
和 写回主存的那一步,仍然见上一链接。
推测解码的接受率证明以本章前面基于 Leviathan et al. 的推导为准。这篇帖子在开头点到推测解码,正文没有重做那份证明。
交互观察
交互:KV Cache 增量解码
自回归生成时,历史 token 的 K/V 永远不变。缓存它们,把每步的 O(n) 重算降成 O(1)。
KV Cache(每步只追加一行)
| # | token | K | V | attn |
|---|---|---|---|---|
| 0 | <s> | [-0.56, -0.94, -0.14, -0.89] | [-0.10, -0.63, -0.05, -0.85] | |
| 1 | 我 | [0.78, -0.18, 0.69, 0.08] | [-0.26, -0.70, 0.67, 0.42] |
无 Cache(全量重算)Q,K,V 形状 [2, 4]累计行数 3 → O(n²)
有 Cache(增量)Q 形状 [1, 4],KV 读缓存 [2, 4]累计行数 2 → O(n)
输出(两条路径完全相同)[-0.2185, -0.6789, 0.4682, 0.0666]
$$\text{Attn}(q_n, K_{1:n}, V_{1:n}) = \text{softmax}\!\left(\frac{q_n K_{1:n}^\top}{\sqrt{d}}\right) V_{1:n}$$
教学要点:加速的代价是显存 —— cache 大小 = 2 × layers × heads × n × d_head。 这就是长上下文推理「显存爆炸」的根源,也是 MQA / GQA / PagedAttention 要解决的问题。
交互:RoPE 旋转位置编码
每一对维度 (d2k, d2k+1) 被当成复平面上的一个矢量,位置 pos 让它旋转 θ = pos × ωk。
| k | ωk | θ = pos·ω | 圈数 |
|---|---|---|---|
| 0 | 1.00e+0 | 3.000 | 0.48 |
| 1 | 7.50e-1 | 2.250 | 0.36 |
| 2 | 5.62e-1 | 1.687 | 0.27 |
| 3 | 4.22e-1 | 1.265 | 0.20 |
$$\omega_k = \text{base}^{-2k/d},\quad \begin{pmatrix} x'_{2k} \\ x'_{2k+1} \end{pmatrix} = \begin{pmatrix} \cos\theta & -\sin\theta \\ \sin\theta & \cos\theta \end{pmatrix} \begin{pmatrix} x_{2k} \\ x_{2k+1} \end{pmatrix},\ \theta = \text{pos}\cdot\omega_k$$
教学要点:低维(k 小)旋转快 → 编码「近距离」;高维(k 大)旋转慢 → 编码「远距离」。 调大 base 会让所有频率变慢,这正是「NTK 插值」外推长上下文的原理。
交互:量化的显存 / 精度权衡
量化就是把 float 权重塞进更少的比特里。省下来的显存,代价是舍入误差。
显存占用(GB)
FP16
14.0
INT8
7.0
INT4 (朴素)
3.5
INT4 (分组 RTN)
4.4
权重重建误差 RMSE(越低越好)
FP16
0.0000
INT8
0.0130
INT4 (朴素)
0.2224
INT4 (分组 RTN)
0.0926
$$\text{scale} = \frac{\max|W_{\text{group}}|}{2^{b-1}-1},\qquad \hat{W} = \text{scale}\cdot\text{round}\!\left(\frac{W}{\text{scale}}\right)$$
教学要点(试试关掉分组量化 + 拉高离群值):单个离群值会撑大整个 tensor 的 scale, 让其余权重使用很粗的刻度。较小的 group 能隔离离群权重,但会增加 scale metadata;本图按 每 32 个权重一个 float32 scale 计入体积。这里只演示 group-wise round-to-nearest, 没有实现 GPTQ 的 Hessian 误差补偿或 AWQ 的 activation-aware 搜索;两者请以本章正文和 Python 实验为准。
交互:LayerNorm vs RMSNorm
LLaMA 之后几乎所有模型都换成了 RMSNorm。差别只有一步:要不要减均值。
LayerNorm
- μ = 1.7000
- σ² = 3.1600
- σ = 1.7776
- y = γ·(x−μ)/σ + β
x0
0.169
x1
-1.519
x2
1.294
x3
-0.675
x4
0.731
参数量:10(γ + β),归约次数 2
RMSNorm
μ = 0(跳过)- mean(x²) = 6.0500
- RMS = 2.4597
- y = γ·x / RMS
x0
0.813
x1
-0.407
x2
1.626
x3
0.203
x4
1.220
参数量:5(只有 γ),归约次数 1
$$\text{LN}(x)=\gamma\odot\frac{x-\mu}{\sqrt{\sigma^2+\epsilon}}+\beta,\qquad \text{RMSNorm}(x)=\gamma\odot\frac{x}{\sqrt{\frac{1}{d}\sum_i x_i^2+\epsilon}}$$
教学要点:拖动「整体平移 c」。LayerNorm 输出完全不动(平移不变), RMSNorm 输出会跟着变 —— 它牺牲了平移不变性。 实践证明这个性质没什么用,换来的是省掉一次全量归约(GPU 上约 10~15% 的 norm 层加速)和一半参数。
交互:SwiGLU 门控前馈层
普通 FFN 是「过一次激活」。SwiGLU 是「一路算内容,另一路算开关,然后逐元素相乘」。
Swish(xW) — 门(虚线)
xV — 内容(点线)
SwiGLU = 门 ⊙ 内容
ReLU(xV) — 老方案
ReLU FFN(d=4096):hidden = 16384,2 个矩阵,参数 134M
SwiGLU FFN:hidden = 10923(缩到 8/3 d),3 个矩阵,参数 134M
$$\text{Swish}_\beta(x)=x\cdot\sigma(\beta x),\qquad \text{SwiGLU}(x)=\text{Swish}(xW)\odot(xV),\qquad \text{FFN}(x)=\text{SwiGLU}(x)\,W_2$$
教学要点:把 β 拉到 8,Swish 几乎就是 ReLU —— 但 SwiGLU 曲线依然是平滑的、可正可负的, 因为它是两条曲线相乘。这种「乘法交互」让 FFN 能表达更复杂的特征选择, 代价是多一个矩阵(所以 LLaMA 把 hidden 从 4d 缩到 8/3·d 来保持参数量持平)。
分别对应:KV cache 增量解码、RoPE 频率对比、量化误差、两种归一化差异、SwiGLU 门控信号。
阶段九:动手实验
目标:证明增量 KV Cache 解码与全量前向数值一致;RoPE 在 position 0 恒等、旋转保持二维范数。这两条是后续所有量化与吞吐实验的对照基准。
环境准备
bash
cd <仓库根>
export PYTHONPATH="$PWD/python"
必做任务(八个实现)
- RoPE:实现
apply_rope,验证 position 0 不改变输入且每个旋转保持二维范数。 - GQA:实现 KV head 分组、单调 cache append、bounded context 和逐 token decode。
- PagedKV:实现 block table append、读取和清空;验证跨请求 prefix 共享。
- SwiGLU:实现
swiglu_forward与swiglu_backward,对拍 torch 参考。 - RMSNorm:实现前向 + 反向,与 LayerNorm 做数值与参数数对比。
- Tied Embedding:实现
TiedEmbedding,对比参数数。 - 高级权重量化:从
clean_room/gptq.py重建 group-wise INT4 打包、阻尼 Hessian 与顺序误差补偿;比较 baseline/GPTQ-style output MSE 与真实总字节。 - Radix 前缀树与多级缓存收益:实现
RadixCache最长前缀匹配与节点分裂,运行python/llm_core/tiered_cache_model.py验证多级存储黄金不等式临界点。
验证
bash
python -m pytest \
  python/tests/test_transformer_contract.py \
  python/tests/test_align_kv.py \
  python/tests/test_quantization.py \
  python/tests/test_gptq.py \
  python/tests/test_diagnostics.py \
  python/tests/test_radix_cache.py \
  python/tests/test_tiered_cache.py \
python/tests/test_w07_algorithms.py -q(test_w07_algorithms.py 是旧文件名,测的就是本章的 RoPE / SwiGLU / RMSNorm / PagedKV。)
text
判定信号:
  逐 token 增量解码 logits 与全量前向差距 < atol=1e-5
  KVCache 每 append 一次长度严格加 1、shape 与 head 对齐
  RoPE position=0 等价于恒等变换;任意位置的二维范数与旋转前相等
  量化只在显式反量化后才参与损失计算
  两个 signed INT4 必须真实打包到一个 uint8;无阻尼秩亏校准必须被 gate 拒绝
故障与参考路径分别执行:
bash
python scripts/verify_gptq_gate.py --implementation no-damping  # 预期 exit 1 / learner_gate=gate
python scripts/verify_gptq_gate.py --implementation reference   # 预期 exit 0 / status=passed
python scripts/benchmark_gptq.py
写作任务
为八组概念各写一条"论文主张 → 本地可观察量 → 不可推出的结论"记录(RoPE position、GQA head 分组、cache/full 等价、group-wise/GPTQ-style 量化误差、SwiGLU gate、RMSNorm 中心化、PagedKV 碎片率、packed-kernel 边界)。缺实测值时填 <未测量>,不要从论文或别人的 benchmark 补数。
概念图:两条优化线
故障注入与预期信号
| 注入 | 预期失败信号 | 修复后证据 |
|---|---|---|
| K/V head repeat 错位 | GQA 输出与 MHA 对照不一致 | head grouping fixture allclose |
| cache append 时重置 position 指针 | RoPE 相位错乱、输出分布漂移 | 维护单调递增的绝对位置计数器 |
| cache 超过 context 未定义策略 | 形状增长无界或读取旧位置 | bounded-context 失败策略可解释 |
| KV 缓存未按 head 维对齐 | 矩阵乘 shape 报错或静默错位 | 缓存维度固定为 (batch, head, seq, dim) |
| 量化 scale 为零未处理 | 全零权重产生 NaN/Inf | zero-weight test finite |
| 量化后忘记反量化 scale | 输出尺度整体偏移、loss 假低 | 算前反量化、算后再量化落盘 |
SwiGLU 把 * 写成 + | 反向传播梯度符号错误 | torch 参考实现对拍通过 |
RMSNorm eps=0 | 除零 → NaN | eps=1e-5 后 finite |
| Tied embedding 漏掉梯度累加 | 反向时 wte 梯度只算了一份 | 梯度累加正确 |
| PagedKV block_id 越界 | 写入越界或读取到旧 block | 边界测试 fail-closed |
| 用单一小 fixture 计时宣称吞吐提升 | 结论不成立、无法泛化 | 至少三个长度 × 三种 batch 重复测量 |
本章验收
- 自查清单全部能答"是":
- 不看资料,完成这十二道闭卷解释题:
- 解释 RoPE 如何在二维对上旋转、为何 position 0 不变;用第3章的点积说明旋转后内积为什么只依赖位置差 Δ。再说明:从线性插值到 NTK-Aware 与 YaRN,为什么简单的全维度线性压缩会破坏近距离高频特征?YaRN 是如何通过波长阈值实现高频保留、低频插值的频域分段映射?
- 解释 prefill 与逐 token decode 的 position/cache 更新如何保持等价;滑动窗口注意力的 mask 是什么、KV Cache 如何截断为 W 条、Mistral 为什么交替使用滑动窗口层和全注意力层;MQA/GQA、PagedAttention、KV Cache 量化分别优化的是什么瓶颈。
- Speculative Decoding 投机采样解码核心:为什么自回归生成是显存带宽受限(Memory-bound),而目标大模型验证是计算密集(Compute-bound)?写出拒绝采样判定准则
,说明为什么投机采样能够严格数学保证输出分布与目标大模型 100% 无损对齐,并推导平均接受率 下单步期望生成的有效 Token 数。 - Chunked Prefill 调度机制:长 Prompt 的 Prefill 为什么会导致已在 Decode 阶段的会话发生严重的首字延迟(TTFT)与每字延迟(TPOT/ITL)抖动?调度器是如何通过将 Prefill Chunk 与 Decode 步骤混编在一个 Batch(Piggybacking)来同时打满 Tensor Core 和 HBM 带宽的?
- 用一句话解释 SwiGLU 为什么需要三个矩阵而不是两个。
- 写出 PagedKV 的 block_table 在跨请求 prefix 共享场景下如何工作。block_table 改的是 K/V 的物理存放。score 仍是
。GQA 改的是 KV 头数,分页不改头数。 - 解释为什么 RMSNorm 比 LayerNorm 快且参数更少。
- 说明 FlashAttention 与标准注意力的输出关系:在线 softmax 与整行 softmax 的结果相同。改变的是不再把
的 、 写入 HBM。它不是稀疏注意力,也不单独扩大训练时见过的上下文长度。 - 手写 MHA/GQA 的 KV Cache 显存占用公式:
。并说明在张量并行度为 时单卡显存如何切分。若模型采用 MQA( )或头数无法整除 TP 度,TP 切分会发生什么致命陷阱? - 推导多级缓存(HBM
Host RAM)收益黄金不等式: ,说明为什么收益临界点与匹配长度 无关,以及为什么 SWA / MLA 架构能使多级缓存收益暴增。 - 解释 SGLang Radix Cache 与 vLLM 扁平 Chunk 哈希的本质区别:说明最长前缀匹配(LPM)、节点分裂(Split)与引用计数写保护(
ref_count)如何协同避免死锁与误驱逐。 - 离散事件仿真(DES)在 PD 分离集群中的应用:在千卡级推理集群中,为什么用单进程虚拟时钟与状态机模拟(P/D Worker 池)比直接搭建物理集群更能敏捷指导 Cache-Aware 路由与 P/D 比例配比?
- 通过条件复核:同环境 baseline、warm-up/重复次数、cache/full 对拍、量化误差和算法对拍齐备。本地 benchmark 不替代这些验收项。
论文与延伸
- RoFormer: Enhanced Transformer with Rotary Position Embedding(Su 等,2021)
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints(Ainslie 等,2023)
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(Dao 等,2022)
- PagedAttention: Virtual Memory for LLM Serving(Kwon 等,2023,vLLM)
- Root Mean Square Layer Normalization(Zhang 等,2019)
- GLU Variants Improve Transformer(Shazeer,2020)
- 完整索引:必读论文
参考实践绑定
- Karpathy 的 nanochat / llama2.c:只观察现代推理、cache 和端到端约束;把一个观察问题改写成自己的 shape 草图或失败题。
- Raschka 的 LLMs-from-scratch Chapter 4 的 KV cache/attention 选读:只对照接口和张量流,运行本章自己的 full/cache 对拍。
- 中文复习入口:LLMs-from-scratch-CN 与 dive-into-llms;只用于术语和问题导航。
前端/Agent 迁移
KV Cache ≈ 增量渲染缓存:命中旧状态减少重复计算,但 cache key、position、失效和容量边界必须是显式契约。Agent 的上下文压缩/记忆同理:必须区分"可复用事实"与"当前会话状态",不能无条件复用旧结果。
资源 / 成本 / 隐私
RoPE、cache 等价性、SwiGLU 对拍、RMSNorm 和 int8 误差可在本地 CPU/MPS 完成;性能数字只对记录的设备有效,预计 gross cost 为 0。不要下载未核验权重或把真实 prompt 写进 benchmark。
Evidence
仓库当前机器证据(只读快照)
evidence/module-manifest-v1.json 中第10章条目指向基础快照 evidence/09-runtime-v1.json 与高级量化快照 evidence/10-advanced-quantization-v1.json。它们只覆盖各自记录的命令、指标、产物和已知失败;不是学习者提交,也不能推出学习者已完成本章。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。
yaml
schema: learn-llm.evidence.v1
module: 09-inference
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 7
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_transformer_contract.py python/tests/test_align_kv.py python/tests/test_quantization.py -q
  - PYTHONPATH=python python -m pytest python/tests/test_diagnostics.py python/tests/test_w07_algorithms.py -q
metrics:
  - name: cache_full_max_logit_error
    expected: <versioned-tolerance>
    actual: <recorded-value>
  - name: quantized_weight_bytes
    expected: <versioned-bound>
    actual: <recorded-value>
  - name: generation_fixture_match
    expected: <versioned-threshold>
    actual: <recorded-value>
  - name: benchmark_warmup_repeats
    expected: "5/20"
    actual: <recorded-warmup-and-repeat-count>
  - name: full_attention_p50_ms
    expected: measured-on-device
    actual: <recorded-value>
  - name: incremental_attention_p95_ms
    expected: measured-on-device
    actual: <recorded-value>
  - name: swiglu_forward_max_error_vs_torch
    expected: <versioned-tolerance>
    actual: <recorded-value>
  - name: rmsnorm_no_mean_centered
    expected: "mean(out) !=_0"
    actual: <recorded-value>
  - name: tied_param_count_savings
    expected: "≈30%"
    actual: <recorded-value>
  - name: pagedkv_block_table_fragmentation_rate
    expected: <versioned-bound>
    actual: <recorded-value>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
下一步
进入 第11章 · 后训练与对齐:在固定集上比较 SFT / LoRA / DPO toy,不要把它们写成工业 RLHF。