
Appearance
第11章 · 后训练与对齐
前置要求:掌握 第9章 · TinyGPT 预训练与恢复 的训练循环与 第10章 · RoPE、KV Cache 与量化 的自回归推理验证。
第9章训练出的模型只会"续写文本"——你问它"如何煮咖啡?",它可能续写成另一个问题,因为在预训练语料里,问题后面常常跟着更多问题。后训练(post-training)把它从"续写器"改造成"助手":SFT 教它按指令回答,LoRA 让改造变得便宜,DPO 教它在两个回答里选更好的那个。本章全部用小规模实现——目标是理解机制,不是复现工业 RLHF。
本章目标
学完后你能做到:
- 区分 pretraining、SFT、preference data、reward model、RLHF 和 DPO 各自的目标。
- 实现 assistant-only loss mask、极小 SFT、LoRA adapter、可解释的 reward/advantage 小规模路径 和 DPO toy path。
- 用固定评估集比较 base/SFT/LoRA/DPO 的行为差异,同时报告遗忘、数据污染和不确定性边界。
- 把一次生成写成有限步 MDP,并指出整段 REINFORCE、critic 的
、GAE、PPO 概率比和 GRPO 组内均值各是哪个量。
阶段一:后训练全景——从续写器到助手
四条路线的关系:
- SFT(监督微调):用"指令 → 回答"的样例教模型对话格式。
- Reward model + RLHF(InstructGPT 路线):先训一个打分模型,再用强化学习按分优化。强大但复杂——本章只做 reward 记账小规模实现,不实现 PPO。
- DPO:跳过 reward model,直接用"chosen/rejected 偏好对"优化策略,公式上可以证明等价于在 KL 约束下对齐。
工业级后训练全管线与数据配方:以 AI2 TÜLU 3 为例
工业界当代的后训练并非单一算法的单次微调,而是一条精密编排、多阶段演进的数据飞轮管线(Post-Training Data Flywheel Pipeline)。UC Berkeley CS294-280 (Spring 2025) Hanna Hajishirzi 教授团队在完全开源复刻工业前沿的 TÜLU 3(Lambert et al., 2024) 全流程中,揭示了后训练成功的第一决定要素:严格的数据混合配比(Data Mixture)与分阶段对齐机制。
1. SFT 阶段的黄金数据配方(高质量合成 + 严苛去噪)
- 绝不盲目堆量:传统观念认为微调数据“越多越好”(如海量爬虫抓取的问答),但在 TÜLU 3 与 Llama 3 的工程实践中,5 万到 20 万条经过严格清洗、信噪比极高的精选样本,表现远胜数百万条嘈杂数据。
- 任务混合的互补效应(Synergy):
- 代码(Code, 约 20%~25%):代码不单用于写程序,其严格的缩进、变量作用域和因果执行逻辑,能直接外溢并显著提升自然语言推理的严密性;
- 数学与逻辑(Math & Reasoning, 约 20%~25%):多步链式推理(Step-by-step reasoning),打破直觉单步浅层模式;
- 严格指令遵循(IFEval, 约 15%~20%):包含硬约束(如“字数严格在 300-400 之间”、“必须以 JSON 输出”、“不得出现‘苹果’这个词”),逼迫模型学会压制自回归惯性;
- 通识对话(General Chat, 约 30%~35%):维持基础人机交互的顺畅与情商。
任务多样性的反直觉收益。 Flan-PaLM(Chung 等,2023)的关键发现:在 A、B、C 多个任务上训练,比只在 A 上训练对 A 更好——哪怕你唯一关心的就是 A。Flan 系列把 1836 个任务纳入指令微调;多任务混训不是摊薄资源,而是加厚了对单一任务的支撑。这与上文 TÜLU 3 的配比是同一条原理的两个侧面:配比回答"混合里放什么",任务多样性发现回答"为什么一定要混合"。
2. 多阶段对齐的分流策略
- 客观域与主观域分离:有客观对错的标准答案(如代码能跑通与否、数学结果是否等于 42),绝不要使用模糊的人工偏好模型,而应接入可验证环境(RLVR);对于主观偏好、语言风格,则采用基于偏好对的 DPO/SimPO 优化;
- 末端安全熔断(Safety Guardrail):把安全拒答训练放在管线后半程,避免模型在早期 SFT 阶段因过度防御而丧失推理探索的灵活性。
阶段二:SFT 与 assistant-only mask
SFT 的训练目标还是第5章的交叉熵,但加了一个关键改动:只在 assistant 的回答 token 上算 loss:
为什么必须 mask? 如果不 mask,模型会连用户输入一起学,结果是它在对话里自说自话、替你提问。这是「故障注入与预期信号」表中的真实故障。
第9章的 build_sft_batch 把其余位置写成 ignore_index=-100,标签与 input_ids 在同一下标对齐(python/llm_core/post_training.py)。平均的分母是这些仍保留标签的位置个数。未监督项先乘 0、再除以整行长度
前端类比:v-if="role === 'assistant'"——只对 assistant 角色"渲染" loss,其他角色不产生梯度。
SFT chat template 与 loss mask 的对应关系
实际 SFT 数据不是裸 token 序列,而是带角色标记的对话。一个典型的 chat template 长这样:
text
<bos>
<system>你是助手。</system>
<user>如何煮咖啡?</user>
<assistant>首先准备咖啡豆和热水……</assistant>
<eos>
build_sft_batch 接收两路输入:token_rows(上面对应的 token ID 序列)和 assistant_masks(布尔序列,<assistant> 到 </assistant> 之间的位置为 True)。loss mask 的逻辑只关心"这段是不是 assistant",不关心具体的角色标记——这也是 assistant-only mask 能跨模型家族复用的原因。不同模型家族的 template 字符串不同(<bos> vs `` vs 空),但 m_t = role === 'assistant' 这条规则不变。Source: 仓库 python/llm_core/post_training.py build_sft_batch,已验证。
真实工业模板与特殊 token 如何进入模型。 上面的示例用了泛化的 <system>/<user> 标签;工业模板的真实形态以 ChatML 为例:
text
<|im_start|>system
你是助手。<|im_end|>
<|im_start|>user
如何煮咖啡?<|im_end|>
<|im_start|>assistant
首先准备咖啡豆和热水……<|im_end|>
机制层(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 2):<|im_start|>/<|im_end|> 这类特殊 token 意味着词表扩充——嵌入矩阵为它们增加新行,随机初始化后会在指令微调的少量更新内快速学会;若模型使用第9章的 tied embedding(输入嵌入与输出投影共享同一矩阵),LM head 随嵌入矩阵同步扩行,输入侧与输出侧同时"认识"这些新 token。chat template 也不是可省的格式美化——缺少稳定的特殊 token 边界,模型就要从裸文本里重新推断"谁在说话",这份不确定性直接侵蚀指令信号。
阶段三:LoRA——不动主干,只装旁路
全量微调要更新所有参数,贵且容易把原模型"学忘"。LoRA 的做法:冻结原权重
约定差异说明:上述公式是文献常用写法(
是 , 是 );本仓库的实现( python/llm_core/post_training.py:102-103)把存为 (in_features, rank)、存为 (rank, out_features),forward 为x @ A @ B。两者只差一个转置,乘积结果相同,但参数初始化和矩阵顺序不直接照搬公式。
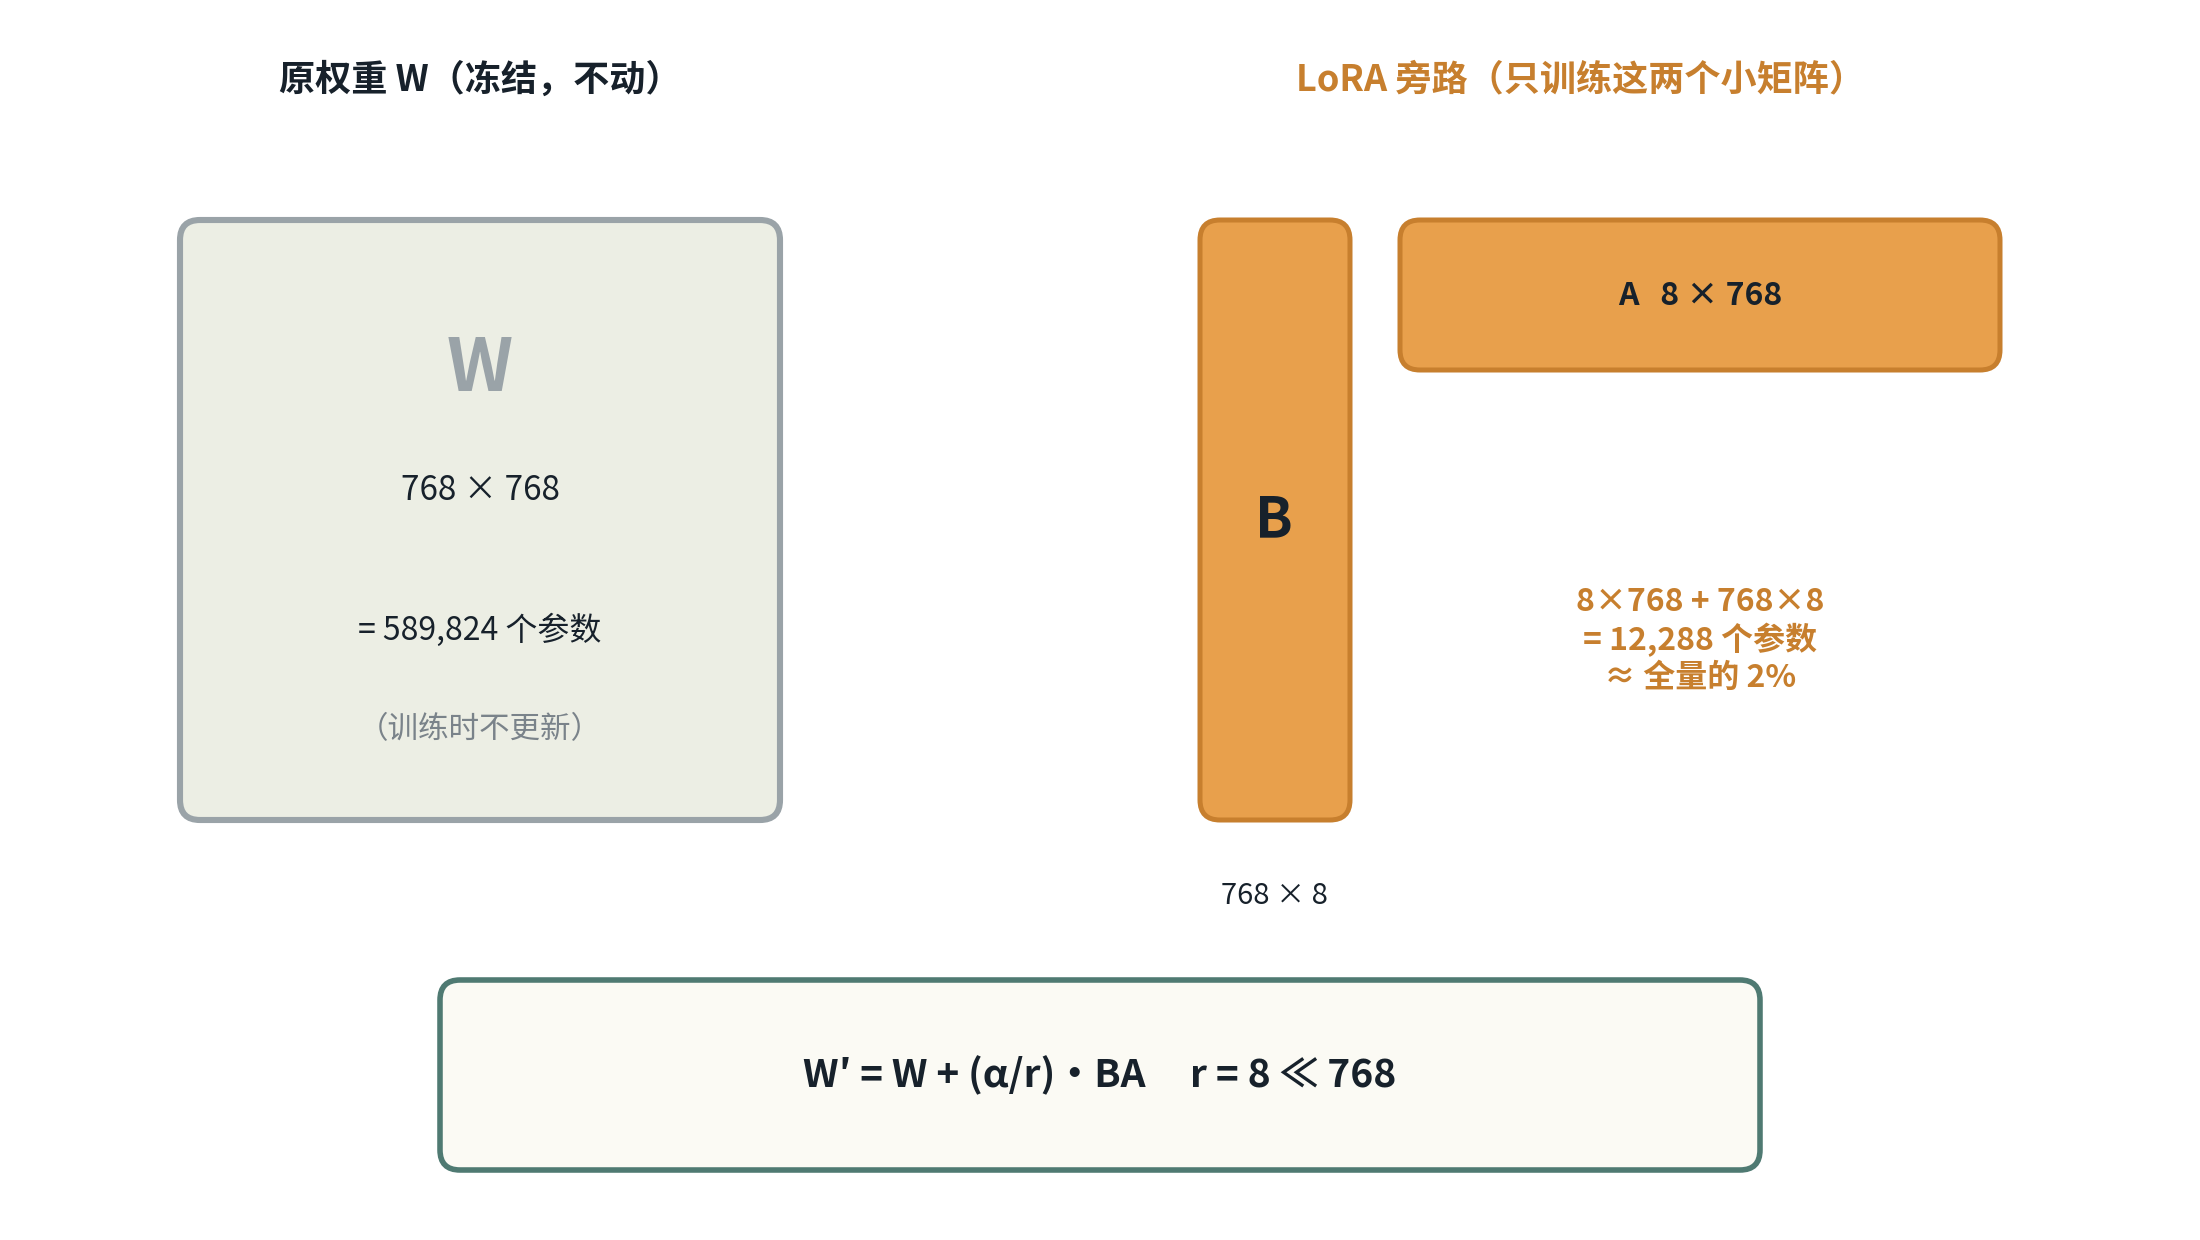
逐个符号读:
为什么省? 手算:
为什么低秩可行? 经验事实:微调对权重的"修改量"通常是低秩的——它只沿少数几个方向调整行为,用一个低维旁路就足够表达。
两个工程要点:
手写 LoRA 核心模块(Raschka 附录 E 与 Hu et al. 2021 原版实现)
看懂一个工业级 LoRALinear 层有多么优雅简练:
python
import torch
import torch.nn as nn
import math

class LoRALinear(nn.Module):
    def __init__(self, linear: nn.Linear, rank: int = 8, alpha: float = 16.0):
        super().__init__()
        self.linear = linear
        # 1. 冻结原预训练权重!反向传播时不再计算主干梯度
        self.linear.weight.requires_grad = False

        d_in = linear.in_features
        d_out = linear.out_features

        # 2. 创建两个低秩矩阵 A 和 B
        self.A = nn.Parameter(torch.empty(rank, d_in))
        nn.init.kaiming_uniform_(self.A, a=math.sqrt(5)) # Kaiming 初始化

        # 3. 关键绝招:B 初始化为全 0!保证 step 0 时 B @ A 严格为 0,模型行为毫无突变
        self.B = nn.Parameter(torch.zeros(d_out, rank))
        self.scaling = alpha / rank

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # 主干输出 + 缩放后的低秩旁路输出
        # x: (B, T, d_in) -> x @ A.T -> (B, T, r) -> @ B.T -> (B, T, d_out)
        lora_out = (x @ self.A.T @ self.B.T) * self.scaling
        return self.linear(x) + lora_out

    def merge_weights(self):
        # 部署上线时:将低秩增量直接加回主权重,零额外推理耗时!
        weight_delta = (self.B @ self.A) * self.scaling
        self.linear.weight.data += weight_delta
两个工程延伸:QLoRA 与分类微调
工业上最常见的搭配是 QLoRA(Dettmers 等,2023):把被冻结的主权重
另一个容易混淆的方向是分类微调:把 LM head 换成
Chip Huyen 的决策罗盘:Prompt vs RAG vs 微调
很多开发者一上来就想微调模型。Chip Huyen 在《AI工程》第 7 章给出了经典的选型准则:
| 技术路径 | 最擅长改变什么? | 不擅长什么? | 成本与复杂度 |
|---|---|---|---|
| 提示词工程 (Prompting) | 快速原型、指导输出结构、给出少样本示例(Few-shot) | 无法大幅改变模型内在风格,受限于上下文窗口长度与单次 token 费用 | 成本最低,迭代以秒计算 |
| 知识库检索 (RAG) | 动态知识、私有数据、可溯源事实(最新政策、内部文档、引用源定位) | 无法教会模型新的特定语言风格或长篇格式规范 | 中等,依赖向量库与检索重排管线 |
| 监督微调 (SFT / LoRA) | 改变语言风格、输出口吻、特定领域术语对齐、缩短 Prompt 降低调用延迟 | 千万不要试图用微调教会大模型新的事实!(极易产生虚构幻觉,更新成本高昂) | 最高,需要高质量问答对策展与算力支持 |
强化学习的第一性原理:为什么文本生成需要策略梯度与似然比技巧?(结合 Ernest Ryu 课程精髓)
在经典的监督微调(SFT)中,每个 token 都有确定的 target 标签,我们可以直接通过交叉熵反向传播计算梯度。然而在强化学习中,环境(如人类打分、代码编译器或数学判题器)针对的是模型自主采样生成的一整段完整文本给出一个标量奖励
这就带来了一个本质困境:文本采样是离散且不可导的(Non-differentiable Sampling)。模型不能像在连续空间中那样,直接对采样操作求导。
1992 年 Ronald Williams 提出了著名的 REINFORCE 算法,其核心是极为精妙的对数导数技巧(Log-Derivative Trick / Likelihood Ratio Trick):
1. 数学推导(高中微积分链式法则
我们希望最大化期望奖励:
对参数
注意利用标量微积分恒等式:
2. 几何与工程直觉
- 概率乘以奖励:求导结果把不可导的采样变成了对数概率梯度
与奖励标量 的乘积; - 直觉含义:如果一次生成的回答获得了高分(
),梯度更新就会沿正方向增大生成这串 token 的概率;若获得低分或负分,就减小其概率; - 方差缩减(Baseline):单次采样的
方差很大,如果给奖励减去一个与当前回答无关的基线 (如平均奖励),由于 ,梯度的数学期望完全保持无偏,而方差被极大压缩!这就是 Advantage(优势函数 ) 的数学来源。
生成过程是 MDP:回报、TD 残差与重要性采样
整段 REINFORCE 是策略梯度在「奖励只出现在序列结束」时的特例。这个「中间步奖励为 0、序列结束记一个标量、状态由 prompt 给出」的生成设定有个名字:contextual bandit(上下文老虎机)——每条 prompt 提供一个上下文,模型在该上下文里做一次单步决策;它的单状态原型与探索-利用装置见RL 基础的阶段 0。把一次生成写成有限步马尔可夫决策过程之后,critic 的
这条链上,策略
时刻
中间奖励为
左边就是上一节的序列级 REINFORCE,右边是逐步策略梯度乘同一个终止回报。
PPO 的 value head 拟合的就是
一组实践默认值值得记下(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 1):
读论文陷阱:策略梯度里的
更新用的 token 是在旧策略
后文 PPO 小节的
GRPO 用上一节的基线
从序列 REINFORCE 到一般策略梯度定理
上一节把整段 REINFORCE 拆成"逐步对数概率梯度乘同一个终止回报"——那是奖励只在序列结束时出现一次时的特例。一般的折扣 MDP 里,策略梯度定理的结论是(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 1):
其中
这个一般形式是靠一串方差缩减增强逐步抵达的。课程讲义的处理方式值得复述:每一步先证无偏、再谈方差,让每条增强的代价在无偏性框架内显式标价。
增强一:去掉过去奖励。
增强二:减去 baseline。 对任何不依赖当前动作的
(第12章 GRPO 小节有这条恒等式的逐符号展开。)每个样本的梯度因此零均值化——期望不动,方差再降一级。这就是 advantage 里减去
增强三:Q 估计的统一定理。 更一般的陈述:只要估计量满足
Rao–Blackwell 定理解释"为什么是这个形状"。 条件期望不增方差(Jensen 不等式):对一部分随机性取条件期望,估计量保持无偏、方差单调不增。
最优 baseline 与工程代理。 最小方差引理能解出理论最优 baseline
没有 baseline 时,softmax 在"硬推"什么。 很多环境的奖励恒非负(判对记 1、判错记 0)。无 baseline 的更新系数
一般 MDP 的形式化、Bellman 方程与价值迭代,以及 Cliff Walk 上从表格精确解到策略梯度的完整阶梯,见《RL 基础:从 MDP 到策略梯度》参考页。
Actor-Critic 谱系:A2C、A3C 与半梯度的诚实边界
把策略网络
策略头与 LM head 是同一个设计。
为什么演进到 PPO:每一步都在修上一步的痛点。 单看 PPO 的 clip 公式像凭空出现的工程技巧;把它放回演进链,每一步的动机都明确:
- 策略梯度 / A2C:梯度无偏但样本效率低——一批轨迹只支撑一轮更新;
- surrogate(代理)目标 + 重要性采样:想从同一批样本里学更多,把期望改写到采样分布
下,权重是概率比——正是前文 MDP 小节的重要性采样公式; - 信任域(trust region)约束:概率比权重在
离 远时失准,且代理目标只在采样参数附近一阶近似真实目标,所以更新必须被限制在采样策略附近; - TRPO(Schulman 等,2015):把信任域写成 KL 约束,用近似二阶方法求解,效果好但实现复杂;
- PPO-Clip(Schulman 等,2017):回到一阶优化器,用 clip 消除"改进过头"的激励——只允许把概率比增大一个小倍数,策略就没有理由一次迈得太远。信任域不再显式约束,由 clip 加少量更新轮数隐式保证。
这条链的落点是:PPO 仍然要学
第 2 步的代理目标从哪来:紧凑推导与三条结论。 演进链把 surrogate 一句话带过,这里把它补全(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 1)。第一步,把目标换成性能差
(
三条结论:其一,代理目标与真实目标在
顺带一个问题:信任域为什么用 KL、不用参数距离?一句话:
半梯度的诚实注脚。 前文 MDP 小节的 TD 残差 .detach():
python
target = (r + gamma * v_next).detach()   # stop-gradient:目标视为常数,只对当前状态的价值求梯度
loss = ((v - target) ** 2).mean()
讲义在这里放了一条诚实注脚:这种"半梯度"TD 可证明不是梯度下降(Sutton 1993 年一系的收敛性分析);而真正梯度化的 GTD(2008/2009)在实证上反而常常更差。理论上不严格、实践上更好用——这道缝隙被直接标注出来,而不是被措辞掩盖。
本课边界:沿本章口径,本课不实现完整 PPO / actor-critic 训练循环,critic 只作为 PPO 目标的配套概念出现;本章唯一的真实策略梯度训练循环在动手实验区——Cliff Walk 表格 REINFORCE。
第二视角:策略优势与近似策略迭代
上一节的演进链从"样本效率"一路推导出 TRPO/PPO。同一批方法还有第二条推导路径,出发点换成经典的策略迭代;把它放在演进链之后,是因为两条路径在同一处汇合——信任域(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 1)。
定义策略优势(policy advantage):策略
读法用课程里的一句拟人提问最直接(化用自口头讲解):"Dear policy
两个事实把定义变成推导机器:
- 最大化策略优势等价于策略迭代。
的最优解是逐状态贪心 ——恰好是策略迭代(policy iteration)的改进步。经典 PI 因此可以整句重述为"每轮找一个策略优势最大的新策略"。 - 内层期望实现不了。 它要求对
取期望,而 从未被执行、没有样本。近似方案是在 的样本上做重要性采样:只观察 实际执行的动作,用似然比 加权。 与 差得越远,权重越集中在极少数样本上、方差越失控——一步求出 的希望破灭。
破灭之后的出路,与演进链殊途同归:既然直接跳到最优
本课边界:与演进链相同,本课不实现 TRPO/PPO。这一节的作用是概念完整——让"信任域"不只是一个工程词,而是两条独立推理共同指向的同一个数学对象。
Best-of-N:reward model 的第零种用法
进入 RL 机器之前,reward model 还有一种完全不动策略权重的用法(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 3):对同一个 prompt 独立采样
它值得单独一节,是因为它是所有 RM 方案永远该先跑的 baseline:任何"用 RM 做 RL"的管线,都应该先报告免训练的 Best-of-N 成绩作参照——若训练后的策略打不过"采样
换个视角,Best-of-N 本身就是 test-time scaling 的一种——花更多推理时算力换更高质量,与第12章 TTC 小节的"并行采样与投票扩展"是同一个机制在两种语境下的名字。它也划出一条正交轴:RM 训好之后,算力可以花在推理时筛选(Best-of-N),也可以花在训练时固化(RLHF)——两条轴可以叠加。
看懂技术报告需要的 PPO 目标
“如果总是这个方向推得太远出问题——那把‘继续推过头的好处’直接拿掉呢?”(引入节奏化用自 Pramod Goyal, Reinforcement Learning from scratch #1, 2026)这个想法的形式化是——
InstructGPT / RLHF 路线在工业界通常用 PPO(Proximal Policy Optimization,Schulman 等 2017,arXiv:1707.06347)优化策略。读懂技术报告里的 RLHF 段落,需要知道它的目标函数长什么样:
其中
clip 读作激励机制,而不是禁止。 "剪回区间、防止崩溃"的口吻容易把 clip 听成一道禁令。更准确的读法(化用自 Ernest Ryu, RL of LLMs (Spring 2025) 的口头讲解):似然比超过
实践参数的量级。
PPO 目标还包含三个配套项:
- KL 惩罚与古德哈特定律(Goodhart's Law): 在目标中加入
。为什么必须把策略拴在冻结的参考策略附近? 社会学与统计学中的古德哈特定律指出:“当一个指标变成目标,它就不再是一个好指标”。用于打分的神经奖励模型(Reward Model)必然存在分布外对抗盲区。若取消 KL 约束( ),策略模型会迅速利用奖励模型的漏洞,学会堆砌看似讨好、大量感叹号或充满谄媚的虚假回复来刷取不合理的超高奖励值(奖励黑客,Reward Hacking)。KL 惩罚充当了“信息论安全绳”,强制模型不能偏离人类高质量基座语料太远。 - Value head(critic):和策略共享主干、头部独立,拟合上一节的
,即该前缀上的期望剩余回报; - Advantage 估计:GAE 把上一节的一步残差
做成指数加权和,用来降低把整段回报直接乘梯度时的方差; - Entropy bonus:策略输出分布的熵乘以一个小正系数,鼓励探索,防止策略过早坍缩到单一路径。
InstructGPT 的三网络与规模权衡。 这套目标的完整训练配置是三个网络(Ouyang 等,2022):策略
工业级 PPO 四模型协同拓扑与运行流程:在真实工程实现(如 Hugging Face TRL 的 PPOTrainer 与 DeepSpeed-Chat 管线)中,一次完整的 PPO 迭代通常涉及四个功能明确的模型实体或权重副本:
TIP
通俗心智模型:PPO 四模型考场协同演练
初学者理解 PPO 四个模型协同的最佳比喻:
- Actor(答题学生,训练中):负责当场作答,从题目中写出完整文章;
- Critic(估分辅导员,训练中):坐在学生身边,逐句评估“写到现在这句,最后大概能拿几分?”,提供估分基线以削减得分波动;
- Reference Model(入学时的原版学生,已冻结):时刻比对新答案与旧答案,防止学生为了骗高分走火入魔、胡言乱语(Reward Hacking 惩罚);
- Reward Model(严格的考官,已冻结):等到整篇文章写完,给出一记公正客观的最终总分。
- Actor(策略网络
):待优化的自回归语言模型,根据 Prompt 生成候选回复序列; - Critic(价值网络
):通常以带标量 Value Head 的语言模型实现,负责对序列中的每个 token 位置估计期望累积价值 ,为 GAE 提供低方差基线; - Reference Model(参考网络
):完全冻结的初始 SFT 模型副本,负责在每个 token 位置提供参考对数概率,用于计算 散度约束; - Reward Model(奖励网络
):基于人类偏好对预训练的打分模型,在完整序列生成完毕后输出环境奖励标量。
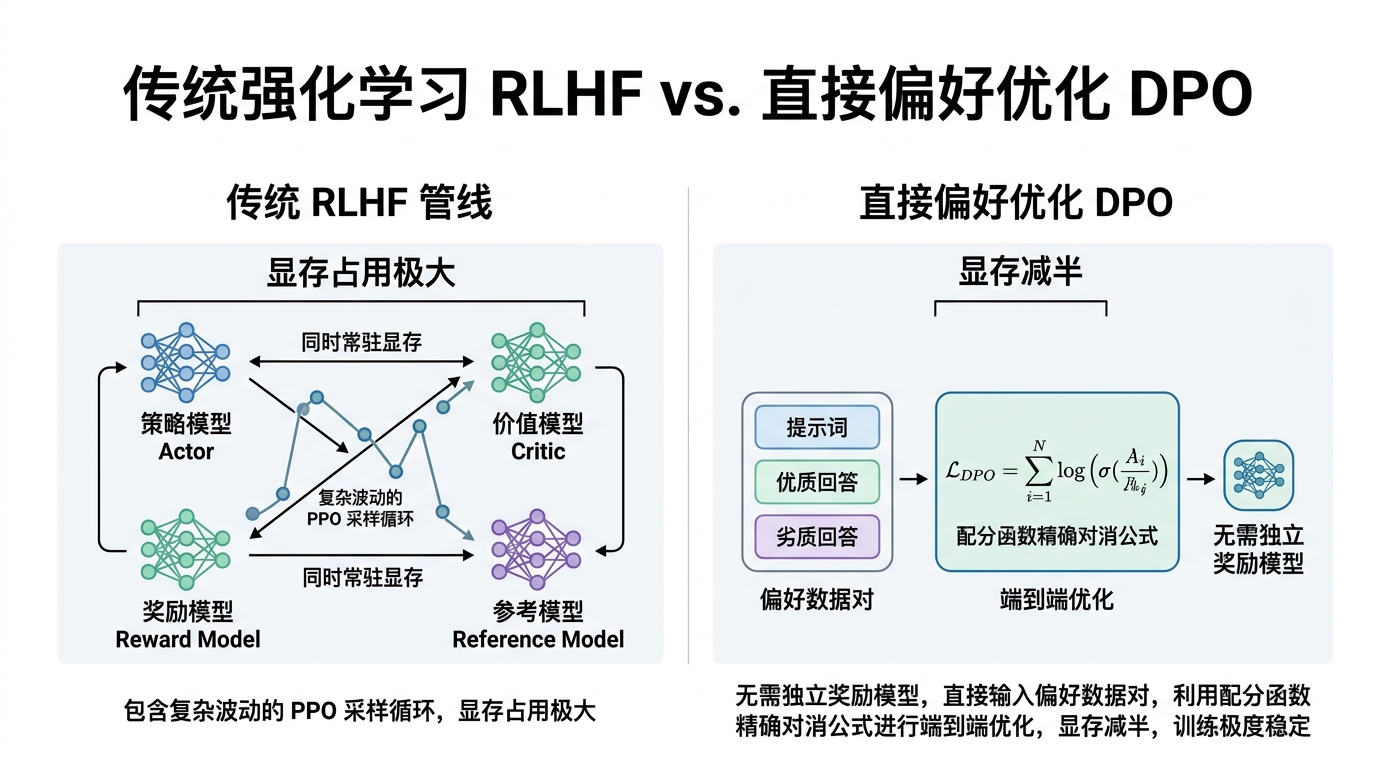
显存开销与算法演进动力:PPO 训练期间需要同时维护 4 个模型的权重与激活缓存(即使 Reference 和 Reward 模型处于 eval 模式无需梯度,也需要占用可观显存)。这解释了为什么强化学习对齐是后训练阶段最昂贵的环节,也正是推动后续 DPO(完全消除 Critic 与 Reward 网络)和 GRPO(用组采样消除 Critic 网络)算法革新的根本工程动力。
RM 的偏好数据是怎么采的。 InstructGPT 的标注流程值得作为工程细节记下(同上讲义):对每个 prompt,用 SFT 模型独立采样
蛇赏金:Goodhart 定律的日常版。 上文 KL 一条的古德哈特定律可以配一个最干净的案例(化用自 Ernest Ryu, RL of LLMs (Spring 2025) 的口头讲解):政府想灭蛇,按上缴蛇尸的条数发赏金;领赏人的理性应对是在家养蛇、定期领取;粗心的饲养让蛇逃逸——区域里的蛇不降反升。指标(蛇尸条数)与目标(蛇变少)在代理人学会利用指标的那一刻脱钩。RM 的分数就是那笔赏金:策略一旦发现堆砌讨好话术能换高分,它优化的就不再是回答质量本身——这就是奖励黑客最直观的形态。
RM 只在
KL 惩罚的等价改写:吸收进逐 token 奖励。 上面把 KL 写成目标里的单独一项;InstructGPT 的 PPO 实现用的是等价形式——把它折算成逐 token 的中间奖励。改写用到的只是对数性质:序列级 KL 等于逐 token 对数比的伸缩求和。于是生成 MDP 的记账从"中间步奖励恒 0、结束记
PPO-PTX:预训练损失混训,第三道保险。 InstructGPT 在 RL 目标之外再混入一小项
带着一个问题往下读。 机器凑齐了
本章定位:本章只做 reward → baseline → centered advantage → normalized advantage 的记账小规模实现,不实现 PPO。上面的内容是知识边界——它让你能读懂 DeepSeek-R1、Gemini 等模型技术报告里的 RLHF 段落,但本章的代码只覆盖 advantage 计算和 DPO。
GRPO 与变体
PPO 的 value head 是主要开销:它要和策略一样大、一样频繁更新。GRPO(Group Relative Policy Optimization,DeepSeekMath, arXiv:2402.03300;DeepSeek-R1, arXiv:2501.12948)把这个组件整个去掉:用同一个 prompt 采样的 G 个回答的 reward 均值作为 baseline,advantage 直接做组内归一化。效果是省掉一个同规模 critic 的显存和训练时间,成本比 PPO 低一档,是目前工业界的主流路线。
第12章会展开 GRPO 的完整公式与小规模实现;本章的 compute_reward_advantages 已经完成了 GRPO advantage 记账的前半段(组均值 baseline + 归一化),只是还没有把它放进策略梯度目标。
与 GRPO 同源的另一个简化是 RLOO(REINFORCE Leave-One-Out):从
选型边界:为什么 RL-LLM 不用 DQN / SAC 家族
把"对 LLM 做 RL"这个问题本身写清楚,大部分经典深度 RL 算法会被问题性质直接筛掉(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 1)。三条性质:
- 动作空间离散且巨大:词表量级
——比 Atari 的十几个离散键大几个数量级,且完全不是连续空间。 - 预训练的初始策略是绝对前提:从随机初始化出发的"白纸 RL"(tabula rasa)在 LLM 上不成立——随机网络输出的"回答"是乱码,奖励信号无从区分好坏。讲师强调这条时的语气强度本身是信息量:tabula rasa RL 对 LLM "never, ever, ever work"。
- 方法必须能利用预训练策略:更新规则要能从一个已经很强的
出发继续改进,而不是把策略当成学习过程的副产品。
旁注:冷启动是同一条原理的两个化身。 性质 2 不是 LLM 特有——围棋用职业棋谱的模仿学习提供初始策略,LLM 用 SFT;"初始策略必须以某种方式提供"是 RL 的一般约束。第12章 R1-Zero 的"不做 SFT"要读成"不做推理数据的 SFT"——它的起点 V3-Base 本身就是预训练提供的强初始策略。
| 方法 | 为什么被筛掉 |
|---|---|
| DQN 系(value-based) | 策略表示是 |
| DDPG / TD3 / SAC(连续控制系) | 为连续动作空间设计,与性质 1 的离散词表不相容;且奖励信号只通过 Q/critic 间接影响策略,不是直接在策略概率上做梯度。 |
筛剩下的正是本章的路线:策略显式参数化为
RLVR / 可验证 reward / 推理模型
RLVR(Reinforcement Learning with Verifiable Reward) 是 DeepSeek-R1(arXiv:2501.12948)采用的训练范式:奖励不再是学出来的 reward model,而是可以自动判定的结果——数学题的答案相等、代码通过单元测试、输出匹配正则。可验证 reward 的梯度信号无噪声,不需要 RM 的泛化能力,天然适配 rule-based 评估。
对应的,推理模型(reasoning model)的测试时计算不再花在"生成更长的回答"上,而是花在更长的思维链(Chain-of-Thought)和自我验证上:模型先输出推理过程,再用可验证 reward 判定结果是否正确。
ORM vs PRM 工业落地深度权衡(大模型招聘高频考点)
两种 reward 粒度在现代推理大模型研发中各有明确的取舍:
| 对比维度 | ORM (结果奖励模型, Outcome RM) | PRM (过程奖励模型, Process RM) |
|---|---|---|
| 奖励粒度 | 稀疏奖励(Sparse Reward):仅在生成完毕后针对最终答案给出一个标量分数 | 稠密奖励(Dense Reward):对思维链(CoT)中的每一个步骤单独打分 |
| 标注成本 | 极低:在数学、代码领域可完全由编译器/单元测试/正则自动化打分,零人工介入 | 极高:需要人类专家或超强模型(如 o1)对每一步推理进行逻辑审阅 |
| 假阳性风险 | 较高:存在“过程胡说八道却巧合蒙对答案”(False Positive)的隐患,导致错误推理逻辑被强化 | 极低:每一步必须合乎逻辑才能获得高分,能精确定位“错误从哪一步开始”(Error Localization) |
| 奖励欺骗 (Hacking) | 较低(最终答案是非分明) | 较高(模型容易学会堆砌“看似严密实则空洞”的形式主义论证套话来骗取步骤高分) |
| 工业界典型代表 | DeepSeek-R1-Zero, OpenAI o-series 纯可验证强化学习 | OpenAI Let's Verify Step by Step, Math-Shepherd |
本章只做可验证 reward 的记账小规模实现(compute_reward_advantages),不实现 RLVR。完整流程在第12章 GRPO 语境下展开。
RLVR 为何突然奏效:四个认知行为,与"学到新推理了吗"的未收敛辩论
可验证 reward 与组内 baseline 都不是 2024 年的新发明,更早的同型工作(如 2024 年初在数学题上做 RL 的 ReFT)并没有引爆推理能力。"为什么同样的配方突然奏效"是一个值得认真回答的问题,而不是用"涌现"一词带过。(讲法源自 Ernest Ryu, RL of LLMs (Spring 2025), Chapter 3。)
一个可检验的答案:四个认知行为。 Gandhi 等(2025)把"基座模型是否携带四类认知行为"做成了可检验命题,论文标题戏称为 "four habits of highly effective STaRs":
| 认知行为 | 含义 |
|---|---|
| verification(验证) | 系统性地检查已写的步骤有没有错 |
| backtracking(回溯) | 识别死路后放弃并折返 |
| subgoal setting(子目标设定) | 把问题分解为可依次解决的子问题 |
| backward chaining(反向链) | 从目标出发倒推所需条件 |
实验事实:Qwen 与 DeepSeek 的基座天然携带这四种行为,RLVR 对它们奏效;Llama 基座基本不具备,RLVR 对其几乎无效——但先用少量含这些行为的数据做 SFT(prime,预先注入),或在 OpenWebMath 这类天然携带这些行为的语料上补训之后,RLVR 开始工作。含义:RLVR 更像放大器而不是发生器,它放大的是基座已有的推理行为模式——这与第12章 R1 的"预训练潜伏能力 + 可验证信号"解释是同一件事的两面。
"RLVR 学到新推理了吗":一场尚未收敛的三回合辩论。 2025 年上半年三组工作给出方向相反的证据。本课按"未收敛领域"的口径转述,不选边:
- 回合一,No(Yue 等,2025.04):证据是 pass@k(同一题独立采样 k 次、至少一次答对的概率)。RLVR 之后小 k 的采样更高效,但大 k 的 pass@k 反而变差——解读为 RLVR 把概率质量集中到模型已会的正确模式上,采样更高效的同时收窄了能力范围,探索到新解法的机会被压缩。
- 回合二,Yes(ProRL,2025.05):只要防住 entropy collapse(输出分布的熵在训练早期骤降、策略过早收敛到窄输出集、探索枯竭,RL 随之停滞),长时间 RL 能学到基座模型不可及的新策略。ProRL 用 DAPO 损失组件加周期性重置 KL 惩罚,支撑了远长于常规的训练时长。
- 回合三,又 No(Wang 等,2025.04):RLVR 用一个训练样本就能起效——同一道题生成多条解路径、强化其中的正确步骤即可。这支持"强化预训练已知的正确推理模式",不支持"学到新推理"。
回合三的单题实验值得摆成一道讨论题。 干预设置极端到反直觉:不在题库上训练,只在一道关于帆船受风压的物理单题上做 RLVR——模型在该题上反复采样解题路径、按答案对错强化——结果这个"单题模型"在 MATH500 上拿到约 70% 的正确率。值得停下想清楚再往下读:这个结果支持"RLVR 学到新推理",还是"强化了预训练已有的推理模式"?一个可用的思考抓手:单题训练为什么没有像 SFT 那样过拟合到这一道题——每次采样的思维链都不同,模型在同一题上试出多条解路,按结果正负强化,等价于自造一份课程;再对照回合一的 pass@k 证据,两个实验各自倒向哪一方?
讲义对这场辩论的收尾是 fog of war(战争迷雾):新兴领域的结论噪声大、最佳实践尚未建立,这些论文要带适度怀疑阅读——同期还有指认部分近期声明所用 baseline 评测有误的博文。读到任何一方的强结论时,先核对它的评测口径。
一条标注为个人假说的解释:SFT 缺显式负信号。 为什么 RL 训练的分布外泛化常好于 SFT?讲义作者在此明确标注"个人假说":SFT 数据没有显式负信号——一个行为不可取时,模型只能通过它在数据中的缺席间接推断,信号弱而低效;RL 直接给出显式负反馈,明确告诉模型哪些行为要避免。代价是缺少 credit assignment(信用分配):导致坏结局的一整段动作被一概降权,无法细粒度归因到具体某一步。假说的价值在于可检验,而不在于已是定论。
不用策略梯度也能学推理:STaR 与 expert iteration
RLVR 路线有一条对照面:完全不用 policy-gradient 更新,也能让模型学出 CoT 推理。expert iteration 的通用循环是:当前模型
STaR(Zelikman 等,NeurIPS 2022)把这个循环落成三步:
- rationale generation:让模型对每道题生成带推理过程的解答,只保留终答正确的轨迹(结果验证);
- rationalization:对答错的题,把正确答案作为提示喂给模型让它补出解释;若解释通向正确结论,就把提示去掉,把这条轨迹当作模型"自己想出来"的数据使用;
- 迭代:数据集逐轮变好——更多题被解出、更少题需要 rationalization。
第12章 R1 流程的阶段三(用拒绝采样生成约 800k 数据再做 SFT)正是这个循环的工业版实例:RL 阶段产出正确轨迹,拒绝采样做结果验证,SFT 拟合增强后的数据。RLVR 与 expert iteration 两条线在 R1 里合流。
那句"更接近监督学习"的标注背后,是一条可以显式陈述的稳定化原则(化用自 Ernest Ryu, RL of LLMs (Spring 2025) 的口头讲解):监督学习稳,RL 难稳,所以实践里凡是能把 RL 的某个组件替换成监督学习形态的机会都会被抓住——RLHF 从 SFT 起步而不是对 base 模型直接上 RL、R1 的阶段三在 RL 之后回退到 SFT 重整数据、expert iteration 把整轮迭代写成"生成数据 → 监督拟合"。读任何后训练管线时,看到一个"回到 SFT"的环节,先问它在稳定什么。
On-policy distillation:把教师带进学生自己的轨迹
“固定数据集上模仿教师会吃到分布偏移——那让学生自己走、教师在旁边逐步给反馈呢?”把这个想法落到蒸馏上——
第12章蒸馏小节的两种形态——logit 蒸馏在固定数据集上模仿教师的输出分布、response 蒸馏把教师生成的文本直接当 SFT 数据——共享同一个结构:训练数据不是学生自己产生的。用强化学习的记号说,它们都是 off-policy 的(在别的策略产生的数据上训练);**on-policy distillation(OPD,在线策略蒸馏)**改的正是这一处:学生自己采样轨迹,教师跟着进入这条轨迹,在每个 token 位置给出稠密监督。(主题与对照框架参考 Stanford CME295 (Fall 2026) 的 cheatsheet 相关条目。)
机制上只有两个动作:
- 学生自采样:
,训练数据来自当前策略。《RL 基础:从 MDP 到策略梯度》第 4 节讲过行为克隆的分布偏移:在别人的状态分布上学到的恢复行为,到不了学生自己会走进的状态。OPD 让"训练时到访的状态分布"与"部署时的分布"是同一个分布,从源头消掉这层偏移——"让模仿尽量 on-policy"的思想在 RLHF(在当前策略的采样上训练)与 expert iteration 之后,在这里又一次回归。 - 教师逐步给信号:对学生轨迹
的每个位置 ,教师输出完整分布 ,学生最小化两个分布在每个位置上的散度。以反向 KL 为例,损失写成
逐个符号读:外层期望对两组随机性取——提示
GKD(Agarwal 等,2023,generalized knowledge distillation)把这个方法一般化:用一个混合比例在"学生自采样"与"固定数据集"之间插值,散度选择也纳入设计空间——OPD 相当于混合比例取满"学生自采样"那一端的特例。
放进本章的两条主线之间看:生成过程的 MDP 视角下,SFT 与固定数据蒸馏是模仿学习一路(信号稠密、分布在别人那里),RLVR/GRPO(第12章)是强化学习一路(分布在学生这里、信号稀疏)。OPD 是第三条路——用教师替代 verifier 的 RLVR:采样照旧来自学生,把终答的可验证判定换成教师逐步的分布信号。第三条路还有一个一步可验证的对偶读法:把损失取为学生轨迹上的教师交叉熵
| 维度 | 固定数据蒸馏 / SFT | RLVR(GRPO 等) | On-policy distillation |
|---|---|---|---|
| 监督对象 | 教师输出 / 人类标注 | 终答的可验证判定 | 教师在每个 token 位的分布 |
| 信号密度 | token 级稠密 | 序列级稀疏 | token 级稠密 |
| 数据分布来源 | 数据集 / 教师策略(off-policy) | 学生当前策略(on-policy) | 学生当前策略(on-policy) |
代价也随之显形:教师要对学生的每条采样轨迹做逐步 forward,且这些前向无法像固定数据集那样离线缓存——学生策略每步都在变,轨迹随之变,教师预算随采样量线性增长。本课不实现 OPD(需教师模型推理预算),机制级理解即可。在可验证 reward 覆盖不到的领域(写作风格、领域知识),它是 RLVR 的现实替代项,也是上一节"凡是能把 RL 的某个组件替换成监督学习形态的机会都会被抓住"原则的又一个落点——保留 on-policy 采样,把策略梯度换成教师监督下的散度损失。
KTO:基于前景理论的非成对偏好对齐
DPO 虽然优雅,但它有一个严苛的前提:训练数据必须严格成对——针对同一个 prompt
KTO(Kahneman-Tversky Optimization, Ethayarajh et al. 2024) 巧妙地解决了这个问题:
- 它直接借鉴了诺贝尔经济学奖得主卡尼曼与特沃斯基的前景理论(Prospect Theory);
- 前景理论指出:人类对损失的敏感度远大于同等程度的收益(损失厌恶,Loss Aversion);
- KTO 据此为每个独立的输入输出对
定义了关于参考模型的相对效用,并赋予“点踩(负样本)”更大的惩罚权重:
其中
MoE 基础
MoE(Mixture of Experts,混合专家)层把标准 Transformer 的 FFN 替换成
关键性质:
- 总参数量随专家数线性增长(
个 FFN),但每个 token 只激活 个,单 token 计算量接近一个 dense 模型; - 如果不加约束,router 会把所有 token 都路由到少数几个热门专家上(负载坍缩),需要用 **auxiliary loss(辅助损失)**惩罚不平衡——经典实现是 Switch Transformer(Fedus 等 2022,arXiv:2101.03961)的 expert-choice 机制。
本章定位:本章只给出 MoE 的基础概念。第12章会系统展开 DeepSeekMoE 的细粒度专家与共享专家设计,以及 auxiliary-loss-free 的 bias 动态均衡方案。
阶段四:reward 与 advantage——对齐的记账单位
强化学习路线需要一个标量信号回答"这个回答比平均水平好多少":
标准化后(零均值、单位方差),不同样本的更新步长才可比较。本章用 3 个固定样例手算这条链:reward → baseline → centered advantage → normalized advantage。符号交换后更新方向必须反转——这是验收点,不是细节。
阶段五:DPO——不要 reward model,直接优化偏好
DPO 的洞察:chosen/rejected 偏好对里已经隐含了 reward 信号,可以跳过显式 reward model。toy loss:
逐个符号读:
/ :chosen(更好的回答)/ rejected(更差的回答); :正在训练的模型; :冻结的参考模型(SFT 后的副本,eval 模式、不算梯度); 方括号里是margin:模型对 chosen 的相对偏好比对 rejected 的相对偏好强多少。margin 越大,
越小,loss 越低; :控制允许模型偏离 多远——数学上等价于第3章的 KL 散度约束:对齐但不"忘本"。 数值上,本仓库小规模实现的
train_dpo默认 β = 0.5(python/llm_core/post_training.py:317),dpo_batch_loss默认 β = 0.1(post_training.py:51);工业实践通常在 0.01–0.1 之间,在验证集上调优。β 越大,KL 约束越强,模型越不敢偏离参考策略。
DPO 的数学神来之笔:配分函数 Z(x) 是如何被完美对消的?
DPO 的 sigmoid loss 不是经验拼凑出来的,它的推导是现代深度学习算法中最优美的代数对消范例之一:
1. Bradley–Terry 偏好模型
假设人类对同一输入
统计血缘一句点破:BT 就是配对逻辑回归。 把 BT 的负对数似然
2. KL 约束下的最优策略闭式解
经典的 RLHF 求解带 KL 散度约束的最大期望奖励:
根据变分极值推导(或凸对偶原理),该问题的理论最优策略具有显式闭式解(Closed-form Solution):
其中
3. 隐式奖励代换与神奇对消
Rafailov 等人(2023)反其道而行之:对最优策略公式两边取对数并移项,解出隐式奖励函数
把
注意这一步神奇的代数对消:因为配分函数
直接将该结果代入负对数似然损失函数,就得到了大名鼎鼎的 DPO 损失:
工程机制解析:该推导直接建立了隐式奖励与策略概率比值的等价性,使得系统无需维护独立的奖励模型(Reward Model),也省去了复杂的在线采样循环,直接把强化学习偏好对齐转换为了监督式的二分类对比目标。
4. 反方向也是闭式解:r 与 π 的双射(顺带一瞥 inverse RL)
上文只走了单方向:给定奖励
于是
5. 梯度解读:隐式 RM 与人类标注分歧越大,梯度越强
把
方向项是"推高 chosen、压低 rejected",与损失直觉一致;更有信息量的是前面的权重
DPO 的致命陷阱:长度偏置(Length Bias)与模式塌缩(Over-optimization)
虽然 DPO 省去了训练显式奖励模型的复杂性,但在工业级训练中,团队普遍遇到了两大致命陷阱(AI2 TÜLU 3 与 Meta FAIR CS294-280 核心反思):
1. 长度偏置与作弊(Length Bias / Verbosity Hacking)
- 现象:经过 DPO 训练的模型,倾向于输出字数极其冗长、排版繁复、包含大量礼貌客套话与无实质信息填充的回答。在 MT-Bench 或 AlpacaEval 2 等评测中,回答长度甚至成倍膨胀。
- 数学根源:回忆 DPO 的隐式奖励差值:
注意公式中的求和项是未归一化的序列总对数似然。如果模型在每一个额外的 token 上只要稍微保持正向的对数比优势(哪怕只有 ),只要输出长度 增加 100 个 token(例如堆砌“总而言之”、“从多维度深入分析”、“希望以上要点能够为您提供参考”),累积的 margin 就会暴涨 !模型因而掌握了一条投机取巧的捷径:无需提升答案质量,仅靠注水拉长篇幅就能极大降低 DPO 损失。
2. 模式塌缩与参考模型分布漂移(Over-optimization & Mode Collapse)
- 离线隐式奖励的无界性:由于静态偏好数据集中的负样本覆盖有限,优化器很容易在某些稀有 token 路径上找到“无限抬高对数比”的局部漏洞;
- 表现:当 DPO 迭代超过一定步数(Step)后,策略模型
的输出熵(Entropy)发生断崖式下跌,生成结果退化为高度模板化、死板的刻板句式,甚至陷入连续重复吐字的“复读机”(Repetition Degeneracy)状态; - 本质:静态离线数据(Off-policy)中无法提供实时的阻尼反馈,参考模型
的静态锚定能力随着策略深入优化而逐渐失效。
长度归一化与 SimPO:消除长度作弊(附最小 Python 演示)
针对长度偏置与双倍显存问题,业界提出了两大主流解法:
- 长度归一化 DPO(Length-Normalized DPO):将总累加对数似然除以各自的序列长度
,度量单位 token 的平均对数概率; - SimPO(Simple Preference Optimization, Meng et al. 2024):
- 采用平均对数似然;
- 引入固定间隔常数
(目标边界 Target Margin); - 彻底丢弃参考模型
,显存直接减半:
最小 Python 演示:长度归一化如何纠正作弊判定
下面是用 NumPy 编写的数值稳定偏好损失函数,清晰展示“未归一化 DPO”如何被冗长填充内容误导,而“长度归一化”如何准确还原真实偏好:
python
import numpy as np

def length_normalized_dpo_loss(
    policy_chosen_logp: float,
    policy_rejected_logp: float,
    reference_chosen_logp: float,
    reference_rejected_logp: float,
    chosen_len: int,
    rejected_len: int,
    beta: float = 0.1,
    length_penalty: float = 0.0,
    normalize: bool = True,
) -> tuple[float, float]:
    """计算带长度归一化与显式长度惩罚的 DPO 损失。

    参数:
        policy_chosen_logp: 策略在 chosen 上的累加 log-prob sum_t log pi_theta(y_w^t)
        policy_rejected_logp: 策略在 rejected 上的累加 log-prob sum_t log pi_theta(y_l^t)
        reference_chosen_logp: 参考模型在 chosen 上的累加 log-prob sum_t log pi_ref(y_w^t)
        reference_rejected_logp: 参考模型在 rejected 上的累加 log-prob sum_t log pi_ref(y_l^t)
        chosen_len: chosen 回答的 token 长度 |y_w|
        rejected_len: rejected 回答的 token 长度 |y_l|
        beta: 隐式奖励缩放系数
        length_penalty: 针对长度差异 (len_w - len_l) 的惩罚权重
        normalize: 是否使用平均对数似然进行长度归一化
    """
    if normalize:
        # 1. 长度归一化:转换为每个 token 的平均对数似然,消除序列长度带来的虚假优势
        p_w = policy_chosen_logp / max(chosen_len, 1)
        p_l = policy_rejected_logp / max(rejected_len, 1)
        r_w = reference_chosen_logp / max(chosen_len, 1)
        r_l = reference_rejected_logp / max(rejected_len, 1)
    else:
        # 原始未归一化 DPO 累加对数概率
        p_w, p_l = policy_chosen_logp, policy_rejected_logp
        r_w, r_l = reference_chosen_logp, reference_rejected_logp

    # 2. 计算隐式相对偏好 margin
    implicit_margin = (p_w - r_w) - (p_l - r_l)

    # 3. 显式长度惩罚(若 chosen 冗长则扣分)
    adjusted_margin = implicit_margin - length_penalty * (chosen_len - rejected_len)

    # 4. 数值稳定的 log-sigmoid 损失: -log(sigmoid(z)) = max(0, -z) + log(1 + exp(-|z|))
    z = beta * adjusted_margin
    loss = float(np.maximum(0.0, -z) + np.log1p(np.exp(-abs(z))))
    return loss, float(adjusted_margin)

# 案例:chosen 是优质精炼回答 (len=10),rejected 是过度填充的冗长回答 (len=100)
# 策略模型在精炼回答上每个 token 质量明显更高(平均 -1.2 vs -1.0)
# 但因为 rejected 有 100 个 token,累积对数出现虚假膨胀:
loss_raw, m_raw = length_normalized_dpo_loss(
    policy_chosen_logp=-12.0, policy_rejected_logp=-100.0,
    reference_chosen_logp=-15.0, reference_rejected_logp=-110.0,
    chosen_len=10, rejected_len=100, normalize=False
)
loss_norm, m_norm = length_normalized_dpo_loss(
    policy_chosen_logp=-12.0, policy_rejected_logp=-100.0,
    reference_chosen_logp=-15.0, reference_rejected_logp=-110.0,
    chosen_len=10, rejected_len=100, normalize=True
)

# 实测结果:
# 原始 DPO: margin = -7.0000, loss = 1.1032(错误判决!误判注水回答更优)
# 归一化 DPO: margin = +0.2000, loss = 0.6832(正确判决!精炼回答胜出)
Iterative Reasoning DPO 与 On-policy 对齐机制(CS294-280 前沿)
UC Berkeley CS294-280 L02 Jason Weston(Meta FAIR)与 L04 Hanna Hajishirzi(AI2)指出了一个关键理论事实:单轮离线(Offline)DPO 根本无法让大模型真正学会多步复杂推理(Deep Reasoning)!
1. 为什么静态单轮 DPO 无法训练深层推理?
- 离策略分布偏移(Off-policy Gap): 静态偏好数据集中的样本
是由早期基座或外部更强模型生成的历史快照。但在多步推理(例如解数学难题、编写复杂递归算法)中,解空间极其庞大,状态空间呈现序列决策树分布。 - 负样本过时效应: 在训练前 50 步,模型可能因为静态数据集里的简单负样本(如第 1 步符号抄错)获得提升;但当模型进入更强状态后,它在第 1 步已经绝对不会犯错,它真正会失误的地方在于推导至第 8 步时的隐蔽逻辑断裂。 此时如果继续拿旧的静态数据集训练,所有的负样本都是模型“早已解决的基础浅层错误”,模型在自己当前最脆弱的逻辑盲区得不到任何梯度信号!训练迅速陷入饱和瓶颈。
2. Iterative DPO 的数学机制与演进闭环
要让 DPO 学会深层推理,必须打破静态离线模式,转向在线迭代偏好优化(Iterative / On-policy DPO):
- 递推机制:
- 在第
轮,使用当前策略 针对题目集批量生成多条候选思考链; - 接入客观真实环境(编译器报错、数学判题器、或高保真过程验证器 PRM)对候选链打标;
- 构造出严格属于当前策略生成分布的胜负对
; - 将上一代策略设为参考模型
,计算 DPO 梯度更新得到 。
- 在第
- 攀爬推理难度阶梯(Curriculum of Hard Negatives): 随着迭代推进,当前策略生成的负样本不再是荒谬的低级错误,而是逼近正确答案但包含极其隐蔽逻辑漏洞的“硬负样本”。模型在与自己当下的最高水平博弈中,被一步步推向深层 System 2 慢思考。
DPO vs PPO vs GRPO 深度对比全景矩阵
在现代后训练对齐技术选型中,团队必须在以下三大范式之间权衡:
| 对比维度 | DPO (直接偏好优化) | PPO (近端策略优化) | GRPO (组相对策略优化) |
|---|---|---|---|
| 数学目标 | Bradley-Terry 偏好对数比二分类损失: | 截断似然比优势目标: | 组内相对优势目标:基于 |
| 独立 Reward Model | 不需要(隐式对消) | 必须常驻(若为开放场景) | 不需要学 RM,天然适配可验证规则(RLVR) |
| 常驻模型实例开销 | 2 份(Actor 训练 + Reference 冻结) (SimPO 可进一步减至 1 份) | 4 份(Actor + Critic + Reference + Reward Model) | 2 份(Actor + Reference),无 Critic,Reward 为纯规则代码 |
| 显存与硬件门槛 | 极低(单卡/双卡即可跑通用微调) | 极高(4 模型并行显存与通信开销巨大) | 中等偏低(省去一个同等体量的 Critic 网络) |
| 梯度方差与稳定性 | 梯度方差小,但离线容易发生长度作弊与模式塌缩 | 方差受 Critic 价值估计准确度极大影响,超参敏感、极易训练崩溃 | 组内蒙特卡洛均值基线严格无偏,方差大幅压缩,训练鲁棒 |
| 探索能力 (Exploration) | 弱(离线拟合为主,需靠 Iterative 补齐探索) | 强(在线连续采样探索) | 极强(组内采样自由探索解空间,自发涌现反思与思维链) |
| 策略漂移约束 | 目标函数内隐式 KL 散度 | 显式 KL 惩罚项 | 显式全局 KL 项加在损失函数中 |
| 工业最佳适用场景 | 通用对话、语言风格对齐、算力受限团队 | 无法由确定性规则自动判分的复杂多维度开放任务 | 数学、代码、逻辑谜题等具备可验证环境的深度长思考链(Reasoning)模型 |
选型决策一句话:
- 如果你的任务是让 7B 对话模型“说话更温柔”、“格式更整洁”,且显存有限
首选 SimPO / Length-Normalized DPO; - 如果你的任务是打造类似 DeepSeek-R1 / OpenAI o-series 那样具有自我验证、长程思考链的推理专用模型
必须采用可验证环境下的 GRPO / RLVR 强化学习。
面试深度硬核:DPO 为什么用 KL 散度不用交叉熵?什么时候两者可互换?
很多工程师去一线大模型团队面试时,经常被问到这道灵魂考题。搞清两者的本质区别,你对后训练对齐的理解就会上升一个台阶:
1. 核心数学关系与定义
回忆第 2 章 §6 的公式:
注意右边第二项就是交叉熵
2. 什么时候两者完全等价?
当真实标签
- 真实分布
是常数分布,它的熵 (或者固定常数)。 - 此时:
! - 结论:在有标准答案的监督学习(SFT/预训练)中,最小化交叉熵与最小化 KL 散度梯度完全等价,算交叉熵更简单,所以用交叉熵。
3. 为什么 DPO 和 RL 对齐必须用 KL 散度?
- 没有唯一的标准答案:对于“如何幽默地向老人解释量子力学”,不存在唯一的 one-hot 标签。
- reward hacking 有三类主要机制,每类有对应 countermeasure:
- 长度偏差(length bias):模型发现"越长的回答得分越高",不断填充冗余内容。Countermeasure:长度归一化(length-normalised reward)或在构造偏好对时控制长度一致;
- 重复与退化(repetition / degeneracy):模型进入局部循环输出重复 token,降低 perplexity 但失去信息量。Countermeasure:熵奖励(entropy bonus)或 early stopping;
- Reward model 分布偏移(RM distribution shift):优化器持续向 RM 打分高的方向推进,逐渐离开 RM 训练时的数据分布,RM 打分失去校准。Countermeasure:KL penalty 限制策略偏离参考模型 + 周期性重新训练 RM。
- 必须约束相对偏离:KL 散度
充当了“隐形安全绳”——它度量的是动态策略 偏离基座先验 的信息距离。此时参考模型分布 不再是只有 0 和 1 的常量向量,它的熵不是 0!必须显式计算比值 。 - 面试一句话总结:
“交叉熵用于标准答案拟合(抬高正确答案概率);KL 散度用于行为边界约束(允许模型学新偏好,但用信息距离绳索勒住它,绝不允许偏离预训练常识太远)。”
4. 对齐的代价:对齐税与安全-有用的帕累托前沿(Pareto Trade-off)
后训练工程中无法回避的核心矛盾是多目标冲突与对齐税(Alignment Tax):
- 对齐税(Alignment Tax):在强化安全性(Safety/Harmlessness)或对话格式(Helpfulness)的过程中,模型的通用推理、数学或代码能力往往出现伴随性下降。这是因为参数更新将概率分布强行拉向人类偏好的子空间,挤压了基座模型原有的知识多样性。
- 安全与有用的帕累托前沿: 若安全过滤规则与拒答对齐过紧,模型会产生过度拒答(Over-refusal)——例如用户询问“如何杀死后台僵尸进程”或“炭疽杆菌的生物学形态”,过度防御的模型会将其误判为攻击并拒绝回答,严重损害有用性(Helpfulness)。 在“无害性”与“有用性”构成的二维空间中,模型表现受制于一条帕累托前沿:在给定模型容量下,无法在不增加过度拒答的前提下无限提高拦截率。
- 工程应对:现代对齐(如多目标 DPO 与细粒度强化学习)通过构造更精准的对比样例(如区分良性技术词汇与真实恶意代码注入),目标是在保持通用能力的前提下,把这条安全-有用的帕累托前沿整体向外推进。
| 对象 | shape | 约束 |
|---|---|---|
| conversation ids | (B, T) | system/user/tool token 可以存在但不一定监督 |
| loss labels | (B, T) | 未监督位置使用 ignore index |
LoRA A/B | (r, d_in) / (d_out, r) | r 明显小于 full rank |
| chosen/rejected log-prob | (B,) | pair 顺序固定 |
对齐安全:概念级地图
后训练对齐不只是让模型"更好用",还涉及防止模型被滥用——至少要知道这些术语出现在安全报告里时它们在说什么:
- Red-teaming(红队测试):从攻击者的视角对模型做对抗性探测,在正式发布前找到 jailbreak 和有害输出路径;
- Jailbreak:已知的攻击类别——通过特定 prompt 绕过模型的拒绝机制,诱导其输出有害内容;
- Refusal training(拒绝训练):在 SFT 或 RLHF 阶段加入拒绝样例,教会模型对有害请求说"不"同时对良性请求保持帮助——Anthropic 的 Constitutional AI(arXiv:2212.08073)是这一思路的代表性工作。
本章定位:概念级介绍,不实现任何安全过滤或拒绝机制。Agent 层的工具权限和人工决策边界在第15章独立处理。
交互观察
交互:LoRA 合并动画
LoRA 训练时只新增一个低秩增量 ΔW = (B·A)·α。推理前把这个增量「焊」进 W,就回到单矩阵前向。
y = (W0 + α/r · B·A) x① 训练时冻结 W0,只更新 A、B(r 远小于 dIn×dOut)
W₀(冻结的基础权重)
1.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
1.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
1.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
1.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
1.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
0.0
1.0
0.0
0.0
+
α·(B·A) · 0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
=
W'(合并后)
1.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
1.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
1.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
1.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
1.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
0.00
1.00
0.00
0.00
LoRA 增量参数:28(r × (dIn + dOut))
原权重参数:48(dIn × dOut)
比例:58.3%
$$W' = W_0 + \Delta W,\quad \Delta W = \frac{\alpha}{r}\,B\,A,\quad A\in\mathbb R^{r\times d_{in}},\ B\in\mathbb R^{d_{out}\times r}$$
教学要点(红旗实验):把 r 调到 1、α 调到 32 —— 增量看起来不小,但参数只有 14 个。 这就是 LoRA「便宜微调」的本质:把表达能力锁在低秩流形上,换取极高的参数效率。 合并后推理图就少两个矩阵算子(省启动开销 / 少算一次 matmul),代价是这一份 LoRA 不能再热切换。
拖动 rank 与 α,观察低秩增量 α/r·BA 如何叠加到冻结权重上;把 merge 滑块从 0 推到 1,确认"LoRA 在路上"与"合并进 W"两种形态输出一致——这正是「故障注入与预期信号」表前两行(adapter 初始非零、merge 缩放/顺序错误)的直观版。
阶段六:动手实验
目标:把后训练三件事钉牢——SFT 的 loss 只由 assistant 区域贡献;LoRA 训练中 base 权重冻结、只有 adapter 参数变化;DPO 让 chosen 相对 rejected 的对数比单调上升。
环境准备
bash
cd <仓库根>
export PYTHONPATH="$PWD/python"
步骤
构造带 system/user/assistant 的最小 batch,逐位置打印
input_ids、labels和loss_mask。训练极小 SFT/adapter,确认 adapter 或权重变化,再在固定 prompt 集上比较 base 与适配后输出。
用极小 reward fixture 计算逐样例 reward、baseline、advantage 和 normalized advantage;故意交换符号,确认方向故障可见。
用极小 preference fixture 验证 DPO 的 chosen margin 方向。
跑判分:
bashpython -m pytest \ python/tests/test_post_training_eval.py \ python/tests/test_post_training.py \ python/tests/test_quantization.py -qtext判定信号:全部 passed、0 skipped。 prompt 位置 loss 被掩码为 0,assistant 位置 loss 大于 0 LoRA 训练一步后 base 权重逐元素不变,adapter 权重更新 chosen-rejected 对数比在优化后单调上升 chosen 与 rejected 配对顺序与标签方向一致生成一份对照表:
base → SFT → LoRA → DPO,每行绑定固定 prompt/样例 ID、观察量、运行命令和局限;未运行的指标写<未测量>,不借用上游或论文数字。
参考实现 post_training.py 提供 build_sft_batch、LoRABigramPolicy、LoRAAdapter、compute_reward_advantages、dpo_batch_loss。固定 fixture 实测:reward baseline 0.0,chosen/rejected normalized advantage ±1.2247…;四条路线在固定合成集上 base accuracy 0.375、SFT 与 LoRA 0.875、DPO preference rate 1.0、holdout 遗忘 0/9、训练/评估 ID 污染 0/8(机器快照见 evidence/10-reward-advantage-v1.json)。这些是小规模行为证据,不是生产质量结论。
动手:Cliff Walk 表格 REINFORCE 与 baseline 故障注入
这个实验不属于上面的后训练三件事:它把一般策略梯度定理搬到一张小网格上真实训练——是本章唯一的真实 RL 训练循环(练习设计源自 Ernest Ryu, RL of LLMs (Spring 2025) 的 Cliff Walk 教学装置;实现为本仓库独立重写)。python/llm_core/rl_basics.py 提供三个入口:CliffWalkEnv 是经典的悬崖行走网格世界——从起点沿悬崖上缘走向终点,踏入悬崖受到远大于步进惩罚的负奖励;value_iteration 做同步价值迭代,求最优价值与最优路径;policy_evaluation_exact 用线性代数精确解评估任一策略,与迭代解对拍。想亲手从零实现这套流程的学习者路径是 clean-room 第 9 模块 clean_room/tabular_rl.py(合同见 clean_room/contracts.json 的 tabular-rl 条目,参考实现为 python/llm_core/tabular_rl_ref.py)。
实验步骤与预期信号:
- 基线对拍:价值迭代的收敛结果与线性代数精确解一致(只差数值容差)——确定性检查,验证贝尔曼算子收敛到唯一不动点。
- 开 baseline 训练:
reinforce_train(env, agent, baseline=True),表格 softmax 策略,固定 seed——预期期望回报相比随机初始化显著提升,逐步逼近价值迭代给出的最优路径水平。 - 故障注入:
baseline=False重跑——预期跨 seed 不稳定:部分 seed 仍能学出避崖策略,部分 seed 灾难性失败(实测 8 个 seed:3 个坠入反复跳崖的循环、期望回报 -35000 量级;开 baseline 的 8 个 seed 全部稳定收敛,其中一个逼近最优路径量级)。机制与策略梯度定理末段的分析互为镜像:那里是全非负奖励下每个被采样动作都被推高、只能靠"推得比别人狠"区分好坏;这里是全负奖励下每个动作都被压低、同样只剩相对效应——且未中心化的整段回报幅度巨大(一次坠崖回合就是数百到数千),单个坏回合的巨大梯度足以把策略推进"越学越坠崖"的正反馈。讲义对同型设定的断言 "Without the baseline, this will not work!" 在表格 Cliff Walk 上的诚实版本是"不保证工作"——python/tests/test_rl_basics.py的跨 seed 测试把这条不稳定性固化成了可复现断言。
判分:
bash
python -m pytest python/tests/test_rl_basics.py -qtext
判定信号:全部 passed、0 skipped。
  价值迭代与精确解对拍一致
  开 baseline 的 REINFORCE 期望回报显著优于随机初始化
关 baseline(同 seed)回报退化,与开启时形成可对照差距边界:表格 Cliff Walk 的收敛数字不能外推到 token 级 PPO/GRPO 的训练动态——两者共享的是策略梯度定理与贝尔曼算子这条数学结构,不共享优化景观与规模。一般 MDP 形式化与价值迭代的完整推导见《RL 基础:从 MDP 到策略梯度》参考页。
概念图:三种对齐的关系
偏好数据构造
偏好对的质量直接决定 DPO 的上限。三个实操规则:两个回答的长度应该相近——否则模型会学到"选长的"而不是"选好的";标注指南(rubric)必须在开始标注前冻结,中途修改 rubric 会让数据分布不一致;记录标注者之间的 disagreement 率,高 disagreement 是数据质量的早期预警信号。
灾难性遗忘
对模型做窄域 SFT 后,它在窄域上表现提升,但在之前学好的任务上性能下降——这就是灾难性遗忘(catastrophic forgetting)。三种主要缓解手段:在 SFT 数据里混入原域数据(replay)、降低学习率、使用 adapter(冻结 base 权重,只训旁路——LoRA 本身就是 adapter 家族的一种)。
重要边界:本章 evaluate_post_training 报告的遗忘率 0/9 是一个单小规模 fixture 的固定 holdout 结果,不能证明 LoRA 一般性地防止遗忘。LoRA 降低遗忘风险的机制(base 冻结)在小规模下成立,但生产规模下是否足够、是否需要额外 replay,需要在大模型和真实 holdout 上重新验证。
知识编辑:如何精准外科手术式修正模型记忆?(ROME / MEMIT 与 Locality 守恒)
在模型上线运营后,常面临事实知识变更与纠错需求(例如“某公司管理层变更”、“过时事实更新”、“消除已确认的幻觉”)。若使用全量 SFT,哪怕只调整一条事实,不仅训练昂贵,还容易诱发上述灾难性遗忘。
**知识编辑(Knowledge Editing / Model Editing)**提出了一种外科手术式的参数定向修改范式:仅针对特定事实更新模型权重,同时严格保证模型在所有无关领域的已有输出不受扰动。
TIP
几何直觉:为什么秩一更新(Rank-One Update)能做到不影响其他知识?
在 4096 甚至更高维度的向量空间中,绝大多数随机向量彼此之间近乎严格正交(即几何内积接近 0)。ROME 利用历史通用文本的激活协方差矩阵求逆
1. 因果中介分析(Causal Mediation Analysis)与反事实介入追踪
我们如何严格证明“事实知识确实存储在中间层 FFN,而不是注意力头或最终输出层”?Meng 等人在 ROME(Rank-One Model Editing, NeurIPS 2022)中采纳了 Judea Pearl 的因果推断框架(参考 Shalizi Advanced Data Analysis from an Elementary Point of View, Ch 20),构建了由三组前向流构成的**反事实因果追踪(Causal Tracing)**实验:
- 清洁运行(Clean Run
):向模型输入标准事实提示词(如 "The Space Needle is located in the city of [Seattle]"),模型正常输出正确目标词"Seattle",记录全网所有层所有位置的清洁激活状态; - 受损运行(Corrupted Run
):在输入端对主体词元( "Space Needle")的词嵌入注入高斯噪声。此时主体事实信息被阻断,模型输出目标词的概率大幅下跌( ); - 反事实介入恢复(Restored Run):在受损前向流中,利用 Pearl 的
算子进行微创手术式介入——强行将第 层第 个词元的隐状态替换为清洁流的对应状态(即 ),观察下游输出目标词概率的恢复幅度。
总间接因果效应(Total Indirect Effect, TIE):
因果追踪热力图的决定性结论: 对所有层
- 前几层(Layers 1–4):注意力机制收集主体语法边界,TIE 接近于零;
- 中间层(Layers 5–8):在主体词元的最后一个 token 处,中间层 FFN 的 TIE 呈现出尖锐的峰值(IE 恢复率高达 70% 以上)!这提供了坚不可摧的因果证据:事实的联想检索(Associative Recall)发生且仅发生在特定中间层的 FFN 中;
- 高层(Layers 9+):TIE 再次衰减,信息被复制到末尾 token 准备输出。
这从理论上决定了知识编辑手术的最佳下刀点:针对中间层 FFN 实施闭式更新。
2. 定位与编辑假说(Locate-and-Edit)与 FFN 记忆库
现代 Transformer 中的两层前馈网络(FFN)在因果分析中被形式化为键值联想记忆库(Key-Value Associative Memory):
的列向量充当“特征探测器”(Key),负责匹配特定主体的隐层表征; 的对应行充当“属性投射器”(Value),存储与该主体强绑定的知识属性。
因此,更新模型事实在机制上等价于在中间层 FFN 的投影矩阵
3. ROME 的秩一更新数学推导
设当前层主体表征键向量为
- 新知识精确写入:
- 已有知识最小扰动:在基座语料的历史激活键矩阵
上最小化均方扰动:
通过拉格朗日乘子法求解,可得到闭式解析解(Closed-form Solution):
其中
4. MEMIT:多层批量扩展
ROME 针对单条知识的秩一更新精度极高,但在批量编辑数千条事实时,连续求逆会累积误差。MEMIT(Mass-Editing Memory in a Transformer, ICLR 2023)将残差向量
5. 模型编辑的四维黄金评估契约
衡量模型编辑是否成功,学术界与工业界(如 EasyEdit 框架)建立了严格的四维评估契约:
| 评估维度 | 数学定义 | 判定要求 | 典型退化表现 |
|---|---|---|---|
| 可靠性(Reliability) | 编辑后的模型在原始 Prompt 上必须稳定输出新目标事实 | 编辑未生效,仍输出旧知识 | |
| 通用性(Generality) | 对原始 Prompt 的语义等价改写(Paraphrase)同样生效 | 发生浅层字符串记忆,换个句式便失效 | |
| 局部性(Locality) | 邻域无关主体的已有知识输出完全不变(守恒性) | 发生附带损伤,破坏了无关实体的既有记忆 | |
| 可移植性(Portability) | 编辑后的新事实能够被多跳推理链或下游应用正确调用 | 单步问答能通过,但在多跳组合推理中逻辑断裂 |
Perplexity 作为指标
PPL(perplexity,困惑度)是 autoregressive 模型最自然的指标:数值越低,模型对序列的"惊讶程度"越低。注意它和 tokenizer 绑定——不同 vocab 的 NLL 不可直接比较,所以 PPL 只在同一 tokenizer、同一语料下横向比较有意义。
PEFT 家族(概念速览)
PEFT(Parameter-Efficient Fine-Tuning)是"只更新少量参数就能让模型学会新行为"的方法族,LoRA 只是其中一种:
- LoRA:在 attention 的
投影旁并联低秩增量(本章实现); - DoRA(Weight-Decomposed LoRA):把
显式拆成幅值(magnitude)和方向(direction)两部分,只对方向做低秩更新,LoRA 是 DoRA 在 magnitude 固定为标量的特例; - Adapter:在 Transformer 层的 FFN 输出后插入一个可训练的小 MLP(
down → nonlinearity → up),主干完全冻结——LoRA 可以看作 adapter 的"重参数化"版本; - Prefix-tuning:不碰权重,只优化输入序列前面的
个可训练 token(soft prompt)的 embedding;注入点在模型最外层,影响面最广但参数最少。
故障注入与预期信号
| 注入 | 预期失败信号 | 修复后证据 |
|---|---|---|
| LoRA 初始 adapter 非零 | base 输出被无意改变 | no-op forward 和 merge 对拍 |
| merge 忘记缩放或矩阵顺序错 | merge 前后输出不一致 | frozen weight 对拍 |
| 损失掩码覆盖了 prompt | 模型学会复读用户输入、对话自说自话 | 只在 assistant 段构造目标 token,逐位置打印 mask 验证 |
| LoRA 忘记冻结 base 参数 | 参数量与显存指标假象、破坏适配语义 | 显式关闭 base 可训练标记,训练一步后 base 逐元素不变 |
| DPO 的 reference 模型未切 eval 且未 no_grad | 显存翻倍、优化目标漂移 | reference forward 包在 eval/no_grad 下 |
| chosen 与 rejected 标注顺序颠倒 | 对齐方向反向、奖励信号相反 | 数据加载层固化标注 schema 并断言,交换符号的故障题可见 |
本章验收
- 自查清单全部能答"是":
- 不看资料,完成这六道闭卷解释题:
- 用同一条 prompt 的
base → SFT/LoRA → DPO对照,解释各阶段改变了哪个参数/目标;assistant-only mask 为什么不能漏到 user token。 - 区分 reward-model/RLHF 流程和 DPO 直接偏好优化:谁产生 reward、谁直接优化 policy?小规模 reward/advantage 结果为什么不能推出工业对齐质量?
- 用第3章的交叉熵解释 SFT mask:为什么 CE 只在 assistant 位置计算就等价于乘
?分母为什么数 的位置,而不是整行长度 ? build_sft_batch在其余位置写入的代表什么? - 用第3章的 KL 散度解释 DPO 的隐式目标;margin 为正时 loss 为什么下降?
- 手算 LoRA 参数量:
、 时,LoRA 训练多少参数,全量微调训练多少?(答案: ,约为全量 的 2%。)现有测试 test_post_training.py::test_lora_starts_as_noop_and_merges_with_expected_parameter_count用 rank=2 的迷你 shape 断言 parameter_count,覆盖了"参数量公式正确"这一性质,但没有覆盖 rank=8 / d=768 的工业典型尺寸——口算题考察的就是这个通用公式。 - 把一次生成写成 MDP:状态、动作、中间奖励和结束奖励各是什么?为什么中间奖励为 0 且
时,整段 REINFORCE 与逐步策略梯度乘同一个 是同一条更新?PPO 的概率比是在给哪个期望做重要性采样,GRPO 的组内均值对应基线还是 ? - 纸笔(以下三题改编自 Ernest Ryu, RL of LLMs (Spring 2025) 课上的纸笔练习):证明折扣回报的伸缩和恒等式
(对定义 做求和指标平移)。KL 惩罚折算成逐 token 奖励时"逐项求和恰好伸缩回序列级 KL",用的就是这一条。 - 纸笔:写出几何级数
与 的闭式并说明收敛条件(答案: 与 ,均要求比值严格小于 1)。折扣回报的有限性与 GAE 的指数衰减加权都落在这两条级数上。 - 纸笔:证明在
时 TD 残差的条件期望是优势函数—— (对 取条件期望,先得 ,再减 )。这是"残差加权构成优势估计"的最小核心。 - 情境手算:PPO 的 clip 在三个 token 位上各取哪个分支?设
,三个位置给出旧策略概率、当前策略概率与 advantage——① 、 、 ;② 、 、 ;③ 、 、 。对每个位置算出概率比 、写出 min 的两个候选值,并判断该位置的梯度是否为零。(答案与一步推理:① ,候选 与 ,min 取 clip 分支——常数项对该位置梯度为零,“把概率推得更大”不再有报酬;② ,候选 与 ,min 取未 clip 分支——梯度仍在,方向是压低该 token 概率、把 拉回区间;③ ,候选 与 ,min 取 clip 分支——梯度为零,“把概率压得更低”同样不再有报酬。三个位置合读:clip 只在“顺着优势方向推过头”的一侧停止付报酬——①的正优势越过上界、③的负优势跌破下界;②这种把越界概率拉回区间的修正性梯度从不被截断。这正是上文“没有禁止,只有不再奖励”在逐位置上的精确含义。)
- 通过条件复核:mask/merge/sign 故障证据齐全。本地小规模更新和固定集结果不冒充工业 RLHF。
论文与延伸
- Training language models to follow instructions with human feedback(Ouyang 等,2022,InstructGPT)
- LoRA: Low-Rank Adaptation of Large Language Models(Hu 等,2021)
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model(Rafailov 等,2023)
- 选读:Proximal Policy Optimization Algorithms(Schulman 等,2017),只取 clipped surrogate 动机,对照第12章 GRPO;本课不实现 value model。
- 选读:High-Dimensional Continuous Control Using Generalized Advantage Estimation(Schulman 等,2016),只取一步 TD 残差与
的指数加权定义。 - 选读:Mathematical Foundations of Reinforcement Learning(Zhao,2025,Springer)。状态价值、Bellman 回报、时序差分与策略梯度的数学顺序以此书为延伸;本课不搬其中的网格世界算例。
- 参考观察:Karpathy 的 nanochat(对话模板与 loss mask 的问题切分);中文复习入口 LLMs-from-scratch-CN。作业仍须独立重写。
- 讲法来源:Reinforcement Learning of Large Language Models 课程页(Ernest Ryu,Spring 2025)——本章策略梯度定理、actor-critic 谱系与 RLVR 批判视角的讲法来源;本课以动机级与批判视角吸收,未 readback。
- 批判视角:Cognitive behaviors that enable self-improving reasoners(four habits of highly effective STaRs)(Gandhi 等,2025;arXiv 编号见讲义)——解释 RLVR 为何在 Qwen/DeepSeek 基座上奏效、在 Llama 上无效;未 readback。本地绑定:RLVR 四个认知行为小节。
- 批判视角:Yue 等(2025.04)的 pass@k 研究(论文名与 arXiv 编号见讲义)——"RLVR 收窄能力范围"一方的证据,未收敛辩论的回合一;未 readback。本地绑定:RLVR 未收敛辩论小节。
- 批判视角:ProRL(2025.05;论文名与 arXiv 编号见讲义)——防 entropy collapse 后长时间 RL 学到新策略的"Yes"方证据;未 readback。本地绑定:RLVR 未收敛辩论小节。
- 批判视角:Wang 等(2025.04)的单样本起效研究(论文名与 arXiv 编号见讲义)——"RLVR 只是强化预训练已知正确模式"的又 No 方证据;未 readback。本地绑定:RLVR 未收敛辩论小节。
- 动机级:STaR(Zelikman 等,NeurIPS 2022;arXiv 编号见讲义)——不用策略梯度学出 CoT 推理的三步循环与 rationalization 技巧;未 readback。本地绑定:STaR 与 expert iteration 小节。
- 索引:必读论文
实验与参考
前端/Agent 迁移
对齐改变的是行为分布,不等于事实性、安全性或产品责任已经解决。Agent 仍需要独立的工具权限、证据和人工决策边界——模型分数不能代替系统政策。
资源 / 成本 / 隐私
本章只运行极小 synthetic preference fixture 和本地 PyTorch,预计 gross cost 为 0;不调用闭源 API。偏好数据不得包含真实人物、客户或私人对话,LoRA/微调权重仅保存在本地。
Evidence
仓库当前机器证据(只读快照)
evidence/module-manifest-v1.json 中 10.evidence 指向当前文件:evidence/10-runtime-v1.json。这是当前 checkout 的脱敏机器运行记录,只覆盖该 JSON 记录的命令、指标、产物和已知失败;它不是学习者提交,也不能推出学习者已完成本章。后训练评估的补充本地报告见 evidence/10-post-training-eval-v1.json,同样不替代学习者独立证据。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。
yaml
schema: learn-llm.evidence.v1
module: 10-post-training
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 8
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_post_training_eval.py python/tests/test_post_training.py python/tests/test_quantization.py -q
metrics:
  - name: assistant_only_mask_accuracy
    expected: 1.0
    actual: <recorded-value>
  - name: adapter_parameter_count
    expected: <versioned-bound>
    actual: <recorded-value>
  - name: chosen_vs_rejected_margin
    expected: '>0'
    actual: <recorded-value>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
下一步
进入 第12章 · DeepSeek 架构专题(MLA、DeepSeekMoE 与 GRPO):深入当代最受关注的开源前沿架构,看后训练强化对齐(GRPO)与推理压缩(MLA)如何在万亿参数下落地。