
Appearance
第5章 · 字符语言模型与概率目标
前置要求:掌握 第4章 · 自动微分与计算图 的标量梯度与 Loss 概念,以及基础数组运算直觉。
第4章你手写了自动微分引擎,但它还空转着——没有真实任务。本章给它接上第一个任务:看前面的字符,猜下一个字符。你会用两条由简到繁的路线做这件事:先是一张纯计数表(Bigram),再是一个可学习的神经网络(MLP)。这两条路线就是全部大语言模型的雏形。
本章目标
学完后你能做到:
- 从计数 Bigram 过渡到神经 Bigram 和上下文 MLP,说清各自的表达能力和短板。
- 从最大似然推导 NLL/交叉熵,区分 logits、概率、目标 token 和采样。
- 在 train/validation 分离的数据上证明参数真的更新了,并解释过拟合、temperature、top-k 的影响。
阶段一:语言模型在做什么
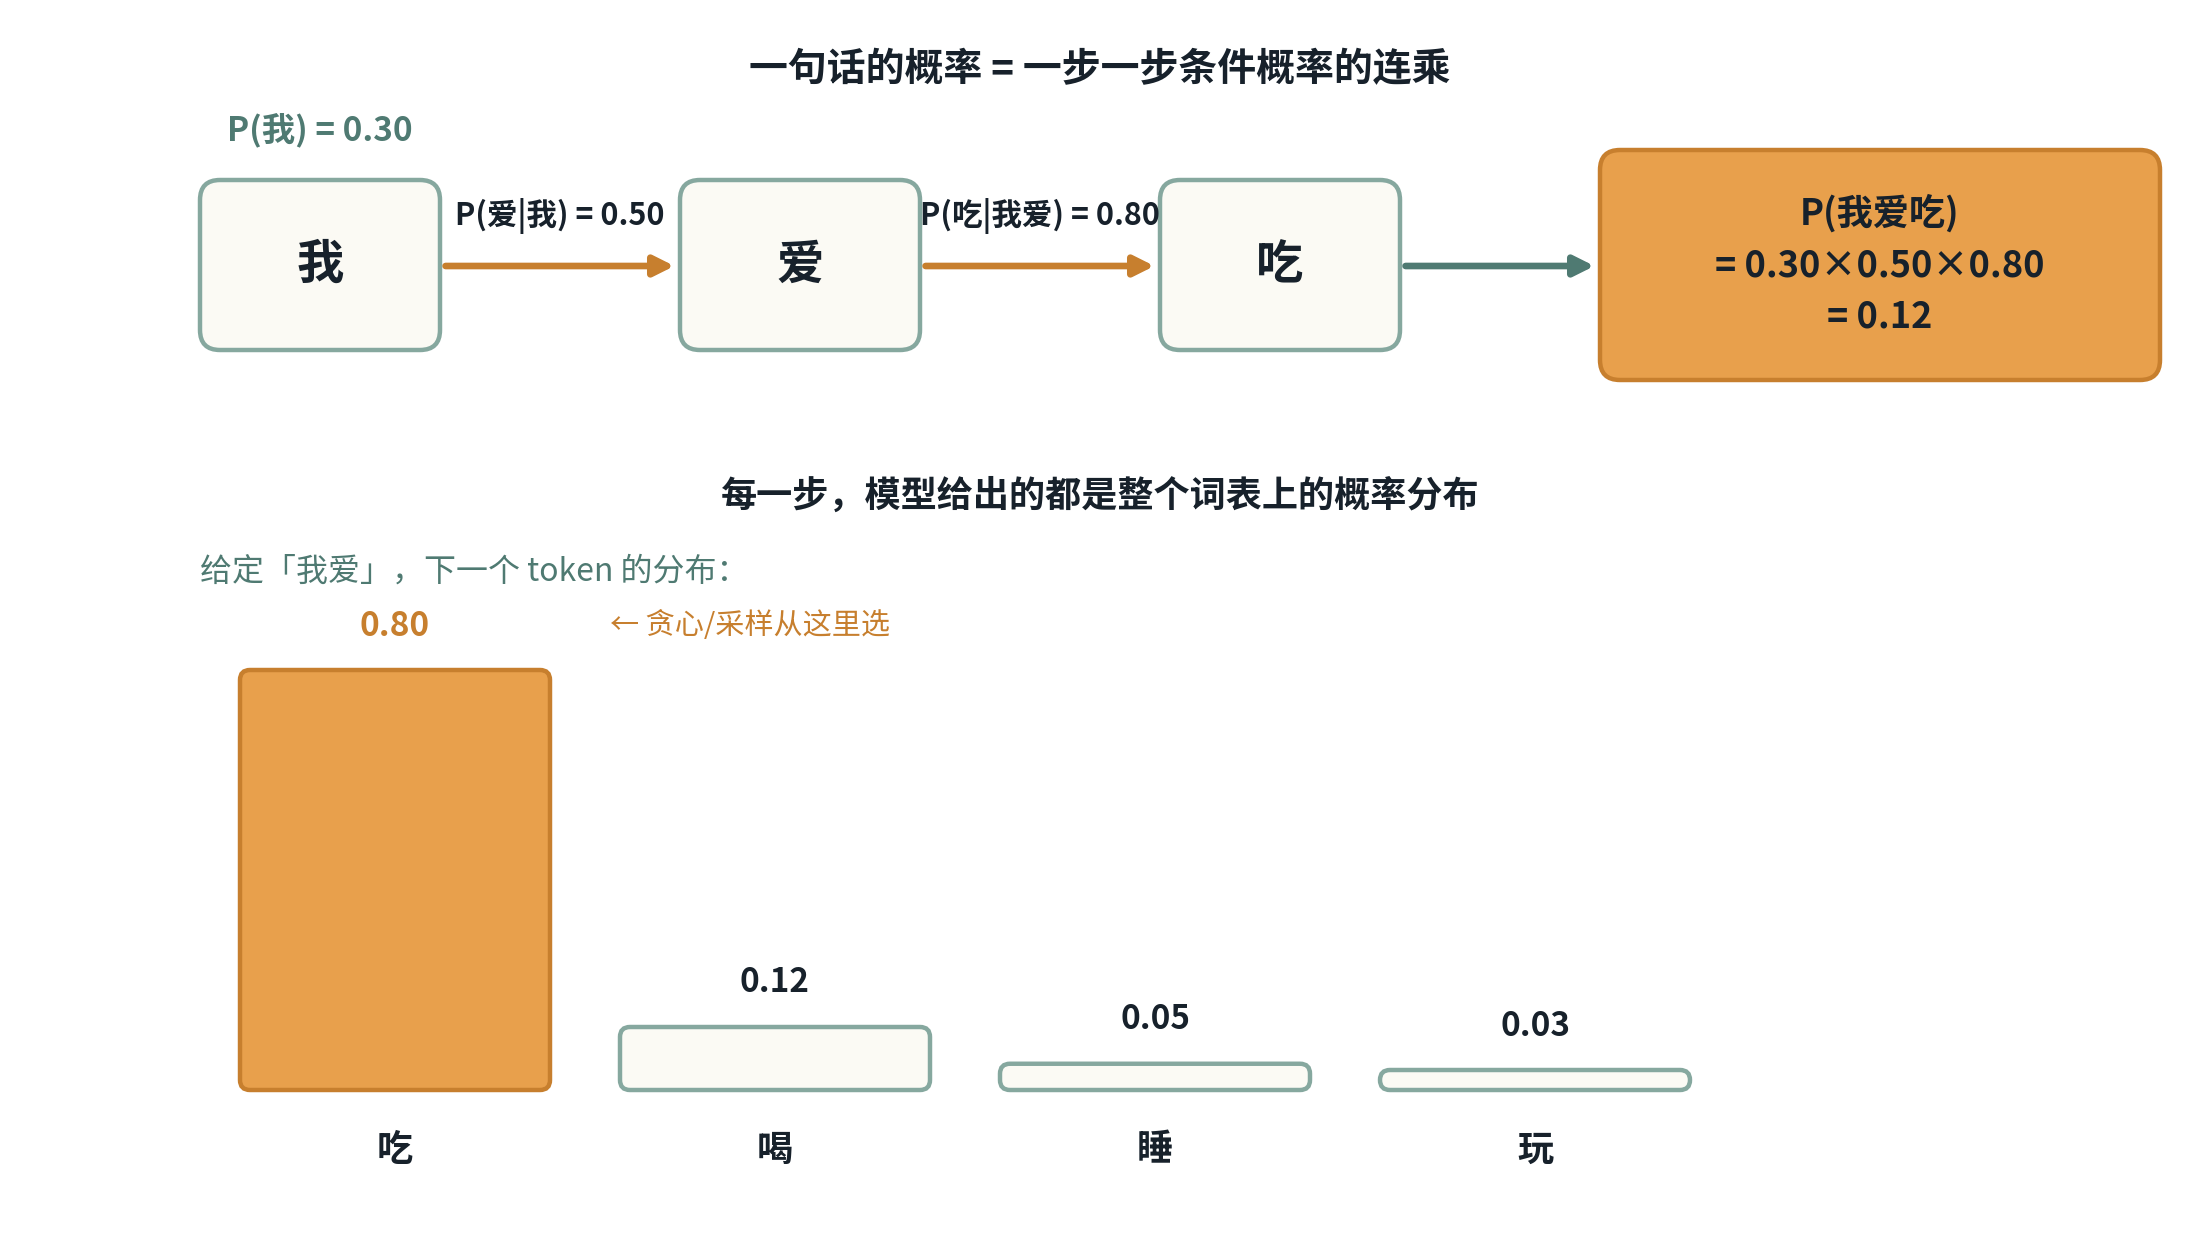
语言模型只做一件事:给定前面的内容,给"下一个 token 是什么"打出概率分布。整段文本的概率被拆解成一步步的条件概率连乘:
读法:一段话出现的概率 = 第一个词的概率 × 知道第一个词后第二个词的概率 × …… 一直乘到最后。这样,"生成一段话"就变成了重复回答同一个问题:下一个是什么?
阶段二:Bigram——一张计数表就是模型
最朴素的语言模型不看公式,只数次数。假设训练语料只有三个词:ab、ab、ac。
统计"每个字符后面跟了什么":
| 当前字符 | 下一个字符 | 次数 |
|---|---|---|
| a | b | 2 |
| a | c | 1 |
于是 mle_bernoulli 的推广:条件概率 = 该搭配出现的次数 ÷ 当前字符出现的总次数,它就是最大似然估计(MLE)。
生成时,从当前字符出发,按这一行的概率随机抽下一个字符,循环往复——这就是"采样",第3章的 categorical_sample(probs, rng) 就是干这个的:先归一化,再按累积分布抽样。
Karpathy 的顿悟时刻:计数表 vs 神经网络的等价性
计数表的表达能力受限于其记录过的精确搭配:未见过的上下文组合要么概率为 0,要么依赖平滑项硬凑,无法泛化到新序列。
看 Karpathy 在 makemore 1 中揭示的深刻洞察:
- 统计路线:开辟一个
的计数矩阵 ,统计每对字符共现次数,按行归一化得到概率表 。 - 神经路线:开辟一个
的可学习权重矩阵 。用字符索引 直接取权重第 行( ,等价于 one-hot 查表)作为 Logits(未归一化的实值分数,softmax 将其映射为概率分布),经过 Softmax 得到预测概率,计算交叉熵损失,用梯度下降更新 。
当你把神经 Bigram 训练收敛后,经过 Softmax 后的权重矩阵 alpha=1.0,见 python/llm_core/bigram.py:28),神经版本没有自带这项正则化,因此两者只有在神经版本也加入匹配的平滑项时才会完全重合。
text
[纯统计] 数据集词频统计 N ─────────> 归一化概率矩阵 P
                                            ▲
                                            │ 完全等价!
                                            ▼
[神经网络] One-Hot @ W ──> Softmax ──> 梯度下降收敛后的 Softmax(W)
在充分收敛、正则化方向一致且数据非稀疏的前提下,神经网络的梯度下降本质上是在逼近真实数据的最优统计规律。
但 Bigram 的短板很明显:它只看一个字符的上下文,a 后面该跟什么,和它出现在词首还是词中毫无关系。如果想看前 3 个字符,计数表的大小会膨胀到
阶段三:交叉熵——给模型的预测打分
训练需要一个分数来衡量"模型猜得多好"。答案来自第3章的自信息:用
手算一遍:正确字符是 b。
- 模型给出
:loss (猜得不错,罚得轻) - 模型给出
:loss (猜得很差,罚得重)
对一批 token 取平均,就是 NLL(负对数似然):
其中
和第3章信息论的关系:交叉熵
底数提醒:手算用
是为了对齐"比特"直觉( ),代码实现用自然对数 np.log。两者只差常数,数字对不上时先查底数再查 bug。
前端类比:cross_entropy([1,0], [0.8,0.2]) ≈ 0.322 就像组件的期望行为是 [1,0](100% 选 A),但实际输出 [0.8, 0.2]——CE 衡量"期望 vs 实际"的信息差距。
初始损失基线定理(Initial Loss Sanity Check)
这是每一个大模型工程师在写完模型架构后的第一道必查本能:
当网络刚刚初始化完毕、参数还是完全随机值时,模型对下一个词的预测应当是毫无偏见的均匀猜测。假设词表大小为
那么,模型在第 0 步的理论交叉熵损失必须精确等于:
- 字符级小实验(
): ; - 第9章 TinyGPT 诊断配置(硬编码
): ,对应该章打印的初始 Loss 4.1742; - GPT-2 工业级 BPE 词表(
): 。
工程实战第一反射: 如果你初始化了一个词表为 65 的模型,运行第 0 步计算出来的 loss 是
16.5或0.2,请立即按 Ctrl+C 中断!
- 若初始 loss 远大于
:说明权重初始化方差过大(某些 logit 初始就高达十几,softmax 极度极化,猜错被重罚); - 若初始 loss 远小于
:说明 target 与 input 没有严格 shift 错位(模型直接抄到了当前输入),发生了数据泄漏!
阶段四:MLP——把计数表升级成可学习的参数
神经语言模型把"查计数表"换成"查参数表 + 小网络":
| 对象 | shape | 说明 |
|---|---|---|
| token ids | (B, T) | 整数,范围 [0, V) |
| embedding table | (V, D) | 只按 token id 查行 |
| hidden/context | (B, T, D) 或 (B, D) | context 长度必须固定或显式 padding |
| logits | (B, T, V) | 最后一维是词表 |
| targets | (B, T) | 与 logits 的时间位置对齐 |
| loss | () | reduction 规则要写入 evidence |
它比计数表强在哪:embedding 让"相似的字符"自动获得相似的向量,于是模型对没见过的上下文也能给出合理猜测——这就是泛化,是神经网络取代计数表的根本原因。
经典论文连线:Bengio 2003 与“连续词嵌入”革命
在 2003 年图灵奖得主 Yoshua Bengio 发表《A Neural Probabilistic Language Model》之前,整个 NLP 界都被**维度灾难(Curse of Dimensionality)**卡得动弹不得:
- 如果词表有
个词,想要看前 3 个词预测第 4 个词(4-gram),离散计数表需要 (一万亿!)个单元格。训练集再大,绝大多数组合的频次也都是 0。 - 更致命的是缺乏语义泛化:计数表认为“猫”和“狗”是两个完全不相干的离散符号。哪怕模型在语料里见过一万次“这只狗在草地上跑”,当下一次遇到“这只猫在草地上跑”时,离散表依然两眼一抹黑。
Bengio 提出了一个改变 AI 历史的想法:给每个词分配一个低维连续实数向量(Embedding 嵌入,比如 64 维)。其核心张量计算流水线如下:
- 查表拼接(Embedding Lookup & Concat):给定前
个上下文词索引 ,通过共享嵌入矩阵 查出对应向量并拼接: - 非线性隐藏层(Hidden Projection):
- 词表 Logits 输出(Output Projection):
- Softmax 概率分布与交叉熵:
参数量级对比:
- 离散
-gram 计数表:参数量为 。当 、 时需要 空间,组合爆炸; - Bengio MLP:参数量为
。参数规模随词表大小 和上下文长度 是线性增长的,彻底打破了维度诅咒。
工程与代码直觉: 在 TypeScript / Python 中,Embedding 矩阵 C[id]。但因为
这个小小的结构,就是今天从 Word2Vec、FastText 到 GPT、LLaMA、DeepSeek 的统一地基。
训练闭环就是第3章的五行循环:前向算 logits → 交叉熵算 loss → 第4章的 backward() 求梯度 → 梯度下降更新参数 → 清零梯度再来一轮。
时间切分的必要性:语言模型的数据是时间序列,随机打乱会把未来 token 泄露到验证集,使 val loss 失去意义——模型在训练时"见过未来",验证损失会虚低。python/llm_core/mlp_lm.py 的 train_mlp_lm_with_validation 按文本顺序截断,保证训练窗口和验证窗口不重叠。
文本生成与采样三剑客:Temperature、Top-K 与 Top-p
大模型生成文本时不是机械地挑最高分,而是从概率分布中随机抽样。业界通用的采样三剑客正是控制“胡言乱语”与“死板复读”的调音旋钮:
Temperature(温度):
是温度。以 logits 为例: 概率分布(约) 效果 0.5 [0.87, 0.12, 0.02]低温:分布尖锐,几乎总选最强候选,适合代码与算术 1.0 [0.67, 0.24, 0.09]常温:模型天然分布 2.0 [0.51, 0.31, 0.19]高温:分布平缓,更富创造力,但过高容易胡言乱语 Top-K 采样: 只保留概率最高的
个候选词,其余所有词的 Logits 强行置为 (概率清零),再在剩余的 个词中重新归一化采样。 - 例如
:彻底防止模型由于极低概率的噪音词(比如长尾罕见错别字)导致语句崩溃。
- 例如
Top-p(Nucleus / 核采样): 按概率从大到小排列,累加概率直到刚好超过阈值
(例如 ),只在这前 概率质量的头部候选集中采样。 - 相比于固定的
,Top-p 是自适应的:当模型很笃定(前两项概率已达 95%)时只在 2 个词里选;当上下文很模糊时候选集自动扩大,比 Top-K 更加自然。
- 相比于固定的
交叉熵的和式只累加标签 token 的
注意 top_k 是另一个旋钮:只在概率最高的 k 个候选里采样。
交互:Softmax + Temperature
把 logits 看成「未归一化分数」。Temperature 越高分布越平,越低越尖。
固定一组 logits,分别观察低温、常温和高温下分布形状的变化。
Greedy ≠ MAP:每步取最大,不等于整句最优
把"每个位置挑条件概率最高的 token"(greedy 解码,温度趋近 0 的极限)和"挑整句联合概率最高的完整序列"(MAP 解码)当成同一件事,是解码环节的常见误解。一个只生成 3 个 token 的续写就能把两者拆开(示例构造化用自 Ernest Ryu, RL of LLMs (Spring 2025) Chapter 2 的 greedy≠MAP 双路树图,数值为本教程自编)。
设前缀是"深夜,她听到楼上传来",模型下一步给出两个头部候选,各自往后走两步:
| 路径 | 第 1 步 | 第 2 步 | 第 3 步 | 整句联合概率 |
|---|---|---|---|---|
| A:"了 一声 叹息" | "了" | "一声" | "叹息" | |
| B:"脚步声 , 很轻" | "脚步声" | "," | "很轻" |
表中每格是"给定前缀,下一个 token 是它"的条件概率;路径 A 的第 2、3 步也都取的是该前缀下概率最高的候选。
greedy 在第 1 步比较
这正是"解码是逐 token 的、而质量是整句的"的结构性错位。回到上面三个旋钮:temperature、top-k、top-p 全都只作用在当前这一步的条件分布上,没有任何一个能回头修改已经生成的 token(三旋钮速查表见参考页)。整句层面的纠偏要么靠保留多条部分路径的搜索,要么等到第 11 章在序列级打分的后训练。
阶段五:动手实验
目标:让两条路线都真实跑通——Bigram 计数矩阵能采样出像样的"人名",MLP 的交叉熵 loss 在受控数据上真实下降。
环境准备
bash
cd <仓库根>
export PYTHONPATH="$PWD/python"
步骤
在小语料上统计 Bigram 计数和条件概率,并明确"没见过的搭配怎么办"的策略。
实现神经 Bigram/MLP:embedding → hidden → logits → CE;先过拟合一个极小 batch,再观察 held-out loss。
比较
T=0.2/1.0/2.0和固定top_k的样本变化;seed 只能约束本地采样,不能把随机输出当事实。跑判分与总览:
bashpython -m pytest python/tests/test_bigram_mlp.py -q python -m labs.run_alltextbigram anna mlp losses 3.2xx -> 2.1xx # 判定条件: # - final loss 明显小于 initial loss(数值示例:3.2xx -> 2.1xx) # - bigram 采样输出在训练词表中存在或形态相近 # - 训练 seed 固定后,两次运行的首末 loss 一致
当前 bigram.py、mlp_lm.py 已提供可复现的 temperature 分布、参数更新、时间切分和 held-out loss fixture;evidence/04-runtime-v1.json 记录本地实测值。
概念图
概念路线 · CONCEPT ROADMAP
第5章核心
forward → backward → 采样- 01
字符序列
(B, T)原始语料的 token ids,整数范围 [0, V)
- 02
切分为输入/输出对
target 右移一位,模型学的是"预测下一个字符"
- 03
Embedding 查找表
(V, D)只按 token id 查行
- 04
隐藏层激活
MLP tanh把 embedding 组合成上下文向量
- 05
输出层
logits (B, T, V)最后一维是词表
←概率论· 词分布第9章 TinyGPT· logits → vocab→ - 06
log_softmax
数值稳定的 log 概率
- 07
交叉熵 loss
NLLper-token 平均,惩罚低概率目标
- 08
反向传播,更新权重
沿计算图回传梯度
- 09
采样生成
temperature先除 T 再 softmax,控制随机性
自上而下即学习顺序:字符 → embedding → MLP 隐藏层 → logits → CE loss → backward → 采样生成。第6章用 BPE 把字符升级为子词,第7章引入 SGD/AdamW 优化器,第8章把 MLP 隐藏层替换为 Transformer FFN + Attention。
故障注入与预期信号
| 故障 | 预期失败信号 | 修复后证据 |
|---|---|---|
| 把 softmax 作用在 batch 维 | 每个 token 的概率和不为 1 | 最后一维逐行和为 1 |
| target 未右移 | 模型学成复制当前 token | shifted target 检查和受控 loss 下降 |
| temperature 乘而非除 logits | 低温反而更随机,概率尖锐度反转 | 固定 logits 的单元测试通过 |
| 训练集和验证集用同一份数据 | val loss 看起来在降,其实只是复读训练集 | 严格切分 train/val,val loss 曲线独立可解释 |
| 采样温度设为 0 | 永远输出同一个字符,看起来像"训练失败" | 温度大于 0,且与训练温度一致时质量更稳 |
| 采样温度非常大 | 输出完全乱码 | 把温度夹在 [0.5, 1.5] 区间,超出则告警 |
| 对 logits 直接 softmax 而没有 log-softmax | loss 数值变成负数或 NaN | 用 log_softmax,或 softmax 后显式 log 并加 nan_to_num |
训练没有固定 seed | 同一脚本两次跑出的 loss 不同 | 入口处同时固定 random.seed 与 numpy.random.seed |
本章验收
- 自查清单全部能答"是":
- 不看资料,完成这五道闭卷解释题:
- 从自回归联合概率分解推到平均 NLL,说明为什么训练中把它写成 cross entropy。
- 用
cross_entropy([1,0], [0.8,0.2]) ≈ 0.322解释为什么 one-hot 标签下 CE 等于。这个和式优化的是标签 token 的 NLL。temperature 缩放 softmax 前的 logits,top-k 截固定个数,top-p 截累计概率质量;三者都不进入训练损失,也不改权重。 - greedy 解码为什么通常拿不到联合概率最高的序列?构造一个两步反例说明"逐步条件概率最大"不等于"联合概率乘积最大",并解释 temperature/top-k/top-p 为什么都改不了这个错位。
- 口算 Bigram 的 MLE:训练集中 "th" 出现 50 次、"t" 出现 200 次,
是多少?这和第3章 mle_bernoulli有什么异同? - 比较 Bigram 与上下文 MLP:各自能表达什么、会在哪种 held-out 现象上失败。
- 通过条件复核:参数确实更新、held-out loss 下降可复现、采样参数已记录。缺少 held-out 指标、seed 或参数更新证据时,本章保持
gate。
论文与延伸
- A Neural Probabilistic Language Model(Bengio 等,2003)
- Language Models are Few-Shot Learners(Brown 等,2020):in-context learning 是规模效应,不是新结构;上下文示例不是训练样本。
- 选读:Karpathy 的 makemore;只抽取概念和实验问题,不把成品复制为答案。
- 索引:必读论文
实验与参考
- 关联概念:术语表 - bigram / softmax / cross-entropy
- 论文依据:必读论文(Bengio 2003 在本章「论文与延伸」;GPT-3 只用来说明 in-context learning 不是新结构)
前端/Agent 迁移
把 logits 看作候选动作的未归一化评分,采样是策略层——模型输出的是条件分布,不是事实数据库。到第15章做 Agent 时,要把"模型建议"与"系统允许的动作"分离,后者仍需 schema、状态和结果校验。
资源 / 成本 / 隐私
本地 CPU/NumPy 即可,固定小语料不需要云资源;预计 gross cost 为 0。语料使用合成或已确认公开许可内容,输出不得包含个人经历原文。
Evidence
仓库当前机器证据(只读快照)
evidence/module-manifest-v1.json 中 04.evidence 指向当前文件:evidence/04-runtime-v1.json。这是当前 checkout 的脱敏机器运行记录,只覆盖该 JSON 记录的命令、指标、产物和已知失败;它不是学习者提交,也不能推出学习者已完成本章。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。
yaml
schema: learn-llm.evidence.v1
module: 04-language-model
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 2
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_bigram_mlp.py -q
  - PYTHONPATH=python python <learner-controlled-language-model-run>
metrics:
  - name: parameter_update_norm
    expected: '>0'
    actual: <recorded-value>
  - name: held_out_loss_delta
    expected: <versioned-threshold>
    actual: <recorded-value>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
下一步
进入 第6章 · UTF-8、byte BPE 与数据管线:把「字符」升级成可逆的子词 token。