
Appearance
第7章 · Tensor 反向传播与训练稳定性
前置要求:掌握 第4章 · 自动微分与计算图 的反向传播机制与 第5章 · 概率语言模型与自回归生成 的交叉熵损失计算。
到第5章为止,所有计算都是标量级的。真实的神经网络里,数据是成批的张量:一个 batch 的句子、每个 token 一个向量、每层一个权重矩阵。本章完成三个跨越:把第3章的标量链式法则推广到张量、学会用 LayerNorm 和初始化让训练不失控、看懂梯度诊断报告——第9章训练 TinyGPT 时不会再"盲开"。
本章目标
学完后你能做到:
- 逐 shape 推导 embedding、linear、激活、cross entropy 和 normalization 的前向与反向。
- 比较初始化、LayerNorm、BatchNorm 的统计轴与训练/推理行为差异。
- 用梯度/激活分布诊断饱和、爆炸或消失,并解释 AdamW 每个符号的含义。
阶段一:从标量到张量——shape 就是类型契约
第4章的 Value 一次只装一个数;本章起,每个变量都是一个带 shape 的数组。shape contract 就是张量世界的 TypeScript 类型契约:每一层进什么 shape、出什么 shape、梯度是什么 shape,都要能默写出来,错误应该在边界处立刻失败,而不是被静默广播掩盖到最后。
| 对象 | shape | 约束 |
|---|---|---|
| embedding table | (V, D) | ids (B, T) → (B, T, D) |
| linear weight | (D_in, D_out) | X @ W + b 输出 (B, T, D_out) |
| LayerNorm 参数 | (D,) | 不跨 batch/time 混算统计 |
| attention 前 hidden | (B, T, D) | 后续 head reshape 保持元素顺序 |
| gradient | 与 parameter 相同 | finite、无静默广播 |
线性层的核心形式:
鱼书核心推导:Affine(线性)层张量反向传播
在第 3 章中我们对标量进行了求导,而神经网络的绝大部分参数都在**线性层(Affine Layer)**中。斋藤康毅在《深度学习入门》(鱼书)第 5 章中给出了极其经典的推导:
给定输入矩阵
若上游传回关于
张量求导的黄金心法:形状决定转置 在张量推导中,无需机械死记矩阵相乘顺序,梯度的形状必须与原参数的形状完全一致:
- 原权重
的形状是 ,已知 是 、 是 :要拼出 ,矩阵乘法唯二的两维必须满足中间对齐消去 ,因此唯一合法的写法只能是 ; - 原输入
的形状是 :要拼出 ,唯一合法的矩阵乘法只能是 ; - 偏置
的形状是 :前向传播时 被广播到了所有 个样本上,根据计算图“共享分支梯度累加”铁律,反向时必须把 个样本上的梯度全部加起来( dY.sum(axis=0))!
text
       X: (B, D_in)                 dY: (B, D_out)
       ┌───────────┐                ┌────────────┐
     B │           │              B │            │
       │           │                │            │
       └───────────┘                └────────────┘
            D_in                         D_out

 目标: 求 dW,其 shape 必须与 W 相同 -> (D_in, D_out)
 规则: 只能用 X 和 dY 相乘,消掉共同维度 B

    X^T: (D_in, B)         dY: (B, D_out)           dW: (D_in, D_out)
    ┌──────────────┐       ┌────────────┐          ┌────────────┐
D_in│              │  @  B │            │  ==> D_in│            │
    └──────────────┘       └────────────┘          └────────────┘
           B                    D_out                   D_out
                       ▲   ▲
                       └───┴── 共同维度 B 严丝合缝消去!
为什么必须有非线性:万能逼近定理与深层网络哲学(结合 500 问核心考点)
如果神经网络只有线性层
100 层的深层网络也会瞬间坍塌为单层线性回归,无法拟合任何复杂的非线性决策边界。激活函数的作用就是注入非线性表达能力。
万能逼近定理(Universal Approximation Theorem, Cybenko 1989 / Hornik 1991): 只要包含至少一个具备非线性激活函数的隐藏层,且给予足够数量的神经元,前馈神经网络就能在紧致空间上以任意精度逼近任意连续函数。
既然单层网络就能逼近一切,为什么大模型一定要堆叠数十层甚至上百层(Deep Stack)?
- 参数利用效率的指数级跃迁:单层宽网络要逼近高度复杂的自然语言语法和多跳逻辑,所需的隐藏神经元数量会随着维度发生指数级爆炸;而深层网络通过层层级联,每一层都能复用上一层提取的抽象特征(从底层的字符、词根,到中层的句法短语,再到高层的因果逻辑),实现多项式级参数量下的超高表达能力;
- 偏差-方差权衡(Bias-Variance Tradeoff)与现代过参数化: 经典机器学习指出预测均方误差可解构为:
。 - 高偏差(欠拟合,Underfitting):模型结构过简(如层数过浅、特征受限),连训练集规律都无法拟合;
- 高方差(过拟合,Overfitting):模型对训练集采样噪声过度敏感,测试集泛化性能骤降。 在传统统计学认知中,模型参数量接近或超过样本量时就会出现灾难性过拟合;但在现代深度学习中,当参数量跨过临界插值门槛后,进入了**过参数化(Over-parameterization)的极宽解空间,优化算法(如带权重衰减的 AdamW)会自发找到最平滑的极小值解,呈现出双重下降(Double Descent)**与良性过拟合(Benign Overfitting)的奇妙工程特性。
手写大模型核心激活函数三代演进:ReLU
主流大模型经历了三代核心激活函数的演化:
| 激活函数 | 核心数学公式 | 代表模型 | 优势与机制 | 局限性与工程代价 |
|---|---|---|---|---|
| ReLU | 早期 Transformer (Vaswani 2017) | 计算极快(仅需比较大小),正半轴无饱和梯度 | Dying ReLU:负半轴梯度为 0,一旦参数落入负区神经元永久死亡 | |
| GELU | GPT-2, GPT-3, BERT | 随机门控:全域平滑,允许极小负值通过,梯度永不彻底断流 | 包含 tanh 与三次幂计算,算力开销略高于 ReLU | |
| SwiGLU | LLaMA, DeepSeek, Qwen | 双线性门控:通过逐元素乘积动态过滤特征,表达能力远超单路网络 | 参数量变为 3 个投影矩阵,通常将隐层维度缩减至约 |
1. 深入剖析 GELU 的概率门控直觉
GELU(Gaussian Error Linear Unit)并不是凭空拟合出来的,它的直觉是自适应随机丢弃(Dropout)的平滑期望版: 假设神经元对输入
在正数区域它逼近
2. 深入剖析 SwiGLU 的双线性乘法器
Noam Shazeer 在 2020 年的经典论文 GLU Variants Improve Transformer 中证明,GLU 系列在各基准测试上全面碾压 ReLU/GELU。 现代 LLM 的标准 Feed-Forward 网络(FFN)在引入 SwiGLU 后演进为:
其中
产生门控控制流(决定每个特征通道的导通程度); 产生候选特征数据流; - 两者做逐元素哈达玛积
,就像由输入动态决定的“软开关”,只放行高价值语义信息; - 最后通过
投影回原模型维度。
3. 手写 NumPy 与 PyTorch 实现
看懂如何在底层干净利落地手写这三代激活函数:
python
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import math

# 1. NumPy 纯手工实现 GELU(Tanh 近似版,零依赖)
def gelu_numpy(x):
    return 0.5 * x * (1.0 + np.tanh(math.sqrt(2.0 / math.pi) * (x + 0.044715 * np.power(x, 3))))

# 2. PyTorch 手写 SwiGLU 模块(LLaMA / DeepSeek 标准构件)
class SwiGLU(nn.Module):
    def __init__(self, in_features: int, hidden_features: int):
        super().__init__()
        # 门控投影与数据投影并行计算
        self.w_gate = nn.Linear(in_features, hidden_features, bias=False)
        self.w_up = nn.Linear(in_features, hidden_features, bias=False)
        self.w_down = nn.Linear(hidden_features, in_features, bias=False)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # (B, T, D) -> SiLU(x @ W_gate) * (x @ W_up) -> @ W_down
        gate = F.silu(self.w_gate(x))
        up = self.w_up(x)
        return self.w_down(gate * up)
阶段二:LayerNorm——先把数据归一到同一把尺子
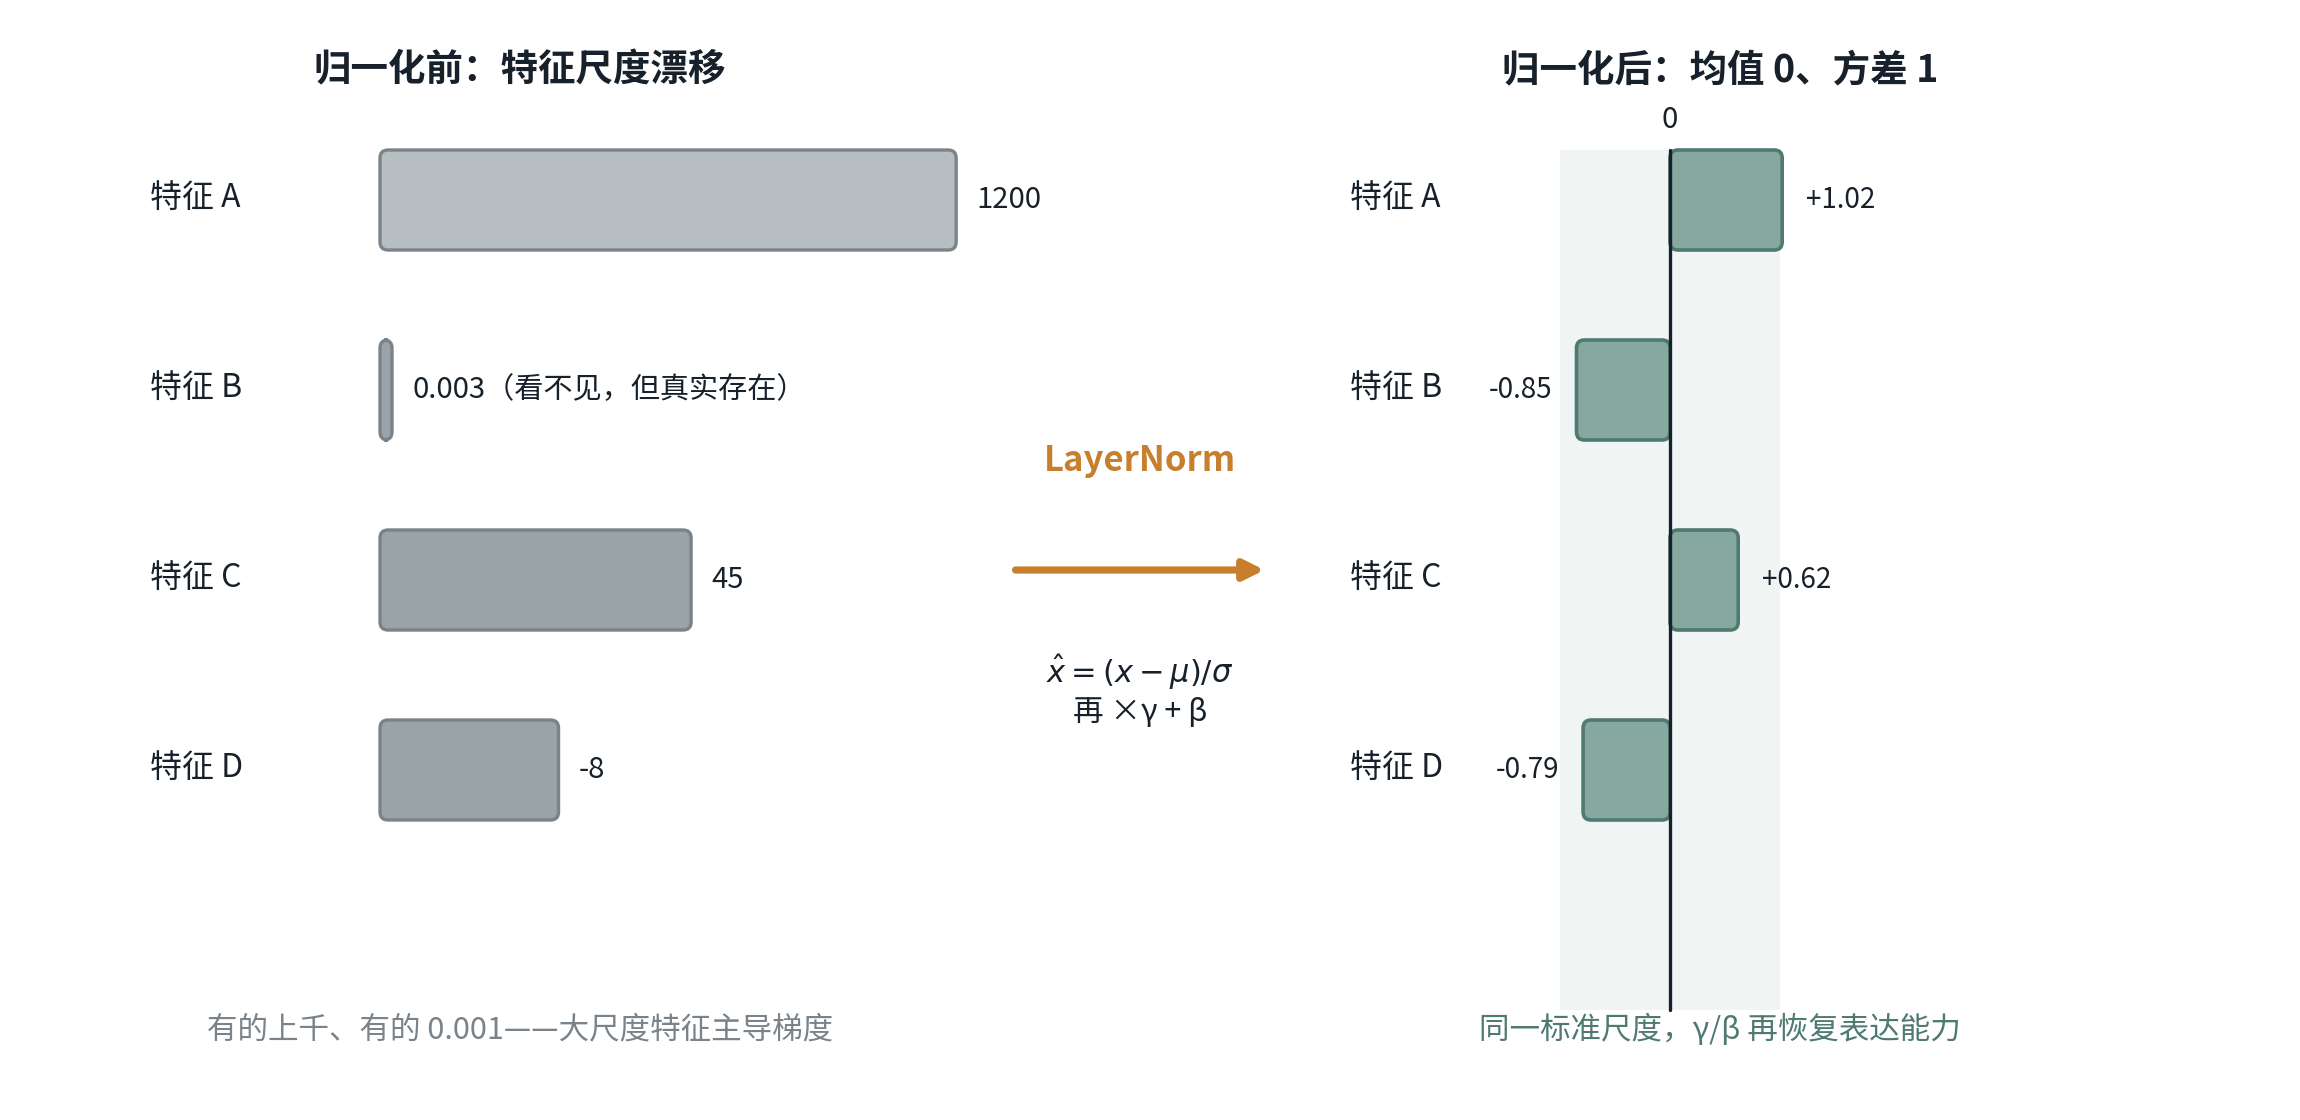
为什么需要归一化? 网络深了之后,各层输出的数值范围会漂移:有的特征取值动不动上千,有的只有 0.001。尺度过大的特征会主导梯度,训练开始震荡甚至发散。LayerNorm 的做法:对每个样本的特征维,减去均值、除以标准差,强行拉回"均值 0、方差 1"的标准尺度,再学一个缩放
逐个符号读:
为什么大模型必须用 LayerNorm 而不是 BatchNorm?(结合 500 问核心考点)
在计算机视觉(CV)中 BatchNorm(BN)是标配,但在 NLP 与大语言模型里,BatchNorm 几乎绝迹,LayerNorm(LN)是绝对统治者。看懂这个差异,你对张量维度的理解就彻底通透了:
| 归一化方式 | 沿哪个轴算均值和方差? | 依赖 Batch 里的其他样本吗? | 为什么适合/不适合 LLM? |
|---|---|---|---|
| BatchNorm (BN) | 沿 Batch 轴跨样本统计:同一个特征维度,把整个 batch 的所有样本加起来求均值 | 是(样本之间互相绑定) | ❌ 大模型死穴:文本序列长度不固定(Padding 干扰统计);推理时单条请求 Batch=1,BN 根本无法计算稳定的实时均值! |
| LayerNorm (LN) | 沿最后一个 Feature 轴统计:只针对当前这一个 token 的所有隐层维度求均值 | 否(完全自给自足) | ✅ LLM 标配:每个 token 独立归一化,与前后词无关、与 Batch 大小无关,单 token 生成(Decode)时完全自洽。 |
权重初始化的生死线:从对称性破缺到 GPT 残差缩放(结合 500 问核心考点)
在参数初始化阶段,若随机分布选择不当,深层网络的训练将从第 0 步开始陷入困境:
- 权重过大:经过线性层累加,输入到激活函数的值极大,Tanh/Sigmoid 的导数在
较大时迅速趋于 0(导数在 时已低于 ),出现大面积神经元饱和,反向传播梯度断崖消失; - 权重过小:网络每深入一层,特征方差就缩小一个量级,传播数十层后激活值缩小到接近浮点下溢极限,深层网络无法获得有效驱动。
1. 对称性破缺(Symmetry Breaking):为什么不能全零初始化?
若将所有权重初始化为全零矩阵
- 前向传播时,同一层的所有神经元计算出的激活值完全相同;
- 反向传播时,由于对称性,所有神经元接收到的梯度也完全一致;
- 无论网络有多宽,同一隐藏层的全部神经元都会沿完全相同的方向做完全相同的参数更新,无法学到互补的特征表示。这种隐藏层退化现象称为对称性困境。因此,权重初始化必须引入打破对称性的随机扰动。
2. Xavier(Glorot)初始化的方差守恒推导
为使信号在深层网络中前向与反向均保持平稳,Glorot 与 Bengio(2010)提出了方差守恒假定: 设单层线性变换为
根据独立随机变量方差性质:
- 前向传播方差守恒:若要求输出方差与输入方差一致(
),则必须满足: - 反向传播梯度方差守恒:类似地,上游梯度反传时满足
,要保持梯度在反向流动时不爆炸、不衰减,需满足: - Xavier 权衡折中:综合输入输出维度的调和平均,Xavier 初始化采用:
3. He(Kaiming)初始化:非线性激活函数的能量补偿
当网络引入单边抑制的激活函数(如 ReLU)时,负半轴输入全部被截断为 0,前向传播的输出方差被腰斩为原来的
4. 大语言模型 GPT 残差缩放初始化与临界态(PDLT 信号传播视角)
在深层 Transformer 中,残差流采用自底向上的叠加模式:
Roberts 等人在《深度学习理论原理》(The Principles of Deep Learning Theory, Cambridge 2022)中从统计物理与有效场论(Effective Field Theory)出发,深入论证了深层网络的信号传播临界态(Criticality):
- 前向方差的线性爆炸:若每个子层(Attention 或 FFN)在初始化阶段的输出方差约为
,经过包含 个 Block(每个 Block 包含 Attention 与 FFN 两个残差子层,共计 个子层)的累加后,残差总线在顶层的方差将线性发散: 若网络深度高达 96 层( ),顶层残差总线的特征方差将膨胀近 200 倍,导致输入最终 LayerNorm 前数值尺度剧烈失衡; - 反向梯度的跨层扰动:根据反向链式法则,主干残差梯度的传递包含恒等直通项与雅可比扰动项:
。若分支权重未经衰减,雅可比项的累积会破坏梯度直通的等距性(Isometry),引发浅层梯度方差的不规则剧烈震荡; 临界态缩放解法: GPT-2 与 nanoGPT 确立了工业界通用准则:对所有投影层(Attention 的输出投影矩阵 与 FFN 的下投影矩阵 )按 缩放标准差: 此时,每个残差分支对总线的方差增量被精确压制到 量级,使得整网顶层的总方差依然严格守恒在常数阶: 这一缩放将深层 Transformer 牢牢锚定在临界相变点上,是 100 层以上超深网络能够平稳启动训练的核心物理保障。
5. 全局梯度裁剪(Gradient Clipping by Global Norm)
即使具备合理的权重初始化与归一化,训练过程中偶发的数据离群值仍可能引起局部梯度尖峰(Gradient Spike)。全局梯度裁剪通过监控所有参数梯度的
当全局范数超过预设阈值
- 几何优势:全局裁剪仅约束更新步长的上限,严格保持多维空间中各梯度的相对几何方向不变;
- 实现位置:在调用
loss.backward()计算出梯度之后、执行optimizer.step()更新权重之前调用(如 PyTorch 的torch.nn.utils.clip_grad_norm_)。
LayerNorm 反向传播(逐步推导)
前向(对单行、特征维大小为
- 分子直达:
的分子含 ,贡献 。 - 均值路径:
依赖整行, ,合计 。 - 方差路径:
,再乘 ,合计 。
三路相加并用
直觉:第一项是上游梯度直通;第二项扣掉"整行一起平移"方向的分量;第三项扣掉沿 dx/dγ 相对误差约 4e-10/2e-10):
python
import numpy as np

def layer_norm_backward(dy, x, gamma, eps=1e-5):
    """LN 反向:dy (B, D), x (B, D), gamma (D,) -> dx, dgamma, dbeta。"""
    mu = x.mean(axis=-1, keepdims=True)
    s = np.sqrt(x.var(axis=-1, keepdims=True) + eps)
    xhat = (x - mu) / s
    h = dy * gamma
    dx = (h - h.mean(axis=-1, keepdims=True)
          - xhat * (h * xhat).mean(axis=-1, keepdims=True)) / s
    return dx, (dy * xhat).sum(axis=0), dy.sum(axis=0)
这是本页的教学参考片段;仓库里最接近的可运行对照是 python/llm_core/rmsnorm.py 的 rmsnorm_backward——少了均值路径,其余同构。
Cross-Entropy 从 logits 到标量:逐步推导
第5章已经用过交叉熵,这里把 shape 和等价形式写死,因为后续训练循环和测试都会直接调用它。
给定 logits(未归一化的分数)F.cross_entropy 默认执行:
python
loss = F.cross_entropy(logits.reshape(-1, V), targets.reshape(-1))等价于:
其中 log_softmax 写开就是:
仓库里 python/llm_train/model.py 第 94 行正是这样写的:
python
loss = F.cross_entropy(logits.reshape(-1, self.vocab_size), targets.reshape(-1))train_sample.py 里的 cross_entropy 函数是对单个位置的简化版本(先 softmax 再 -log(prob[target])),和批量版数学等价。
log-softmax 的数值稳定形式
直接算 inf,进而产生 nan。标准稳定写法是先减最大值:
仓库里 python/llm_core/tied_embedding.py 第 102–104 行就是这么实现的:
python
shifted = logits - np.max(logits, axis=-1, keepdims=True)
log_probs = shifted - np.log(np.sum(np.exp(shifted), axis=-1, keepdims=True))
减 max 不改 softmax 结果(分子分母同减一个常数,比值不变),但把指数拉回
阶段三:优化器——从 SGD 到 AdamW
第3章的 gradient_descent_step(param, grad, lr) 是最简更新 momentum_update 给它加了惯性。AdamW 再进一步——给每个参数维度单独调节步长。完整的一步迭代如下:
逐个符号读:
:一阶矩,梯度的滑动平均——回答"最近梯度总体朝哪指"(就是动量)。 :二阶矩,梯度平方的滑动平均——回答"这个维度的梯度通常多大"。 :梯度大的维度步长自动缩小,梯度小的维度步长相对放大——峡谷地形里不再来回震荡。 :weight decay 直接作用在参数上,和梯度更新解耦——这是 AdamW 相对 Adam+L2 的关键区别:L2 是把衰减混进梯度里,会被自适应步长缩放扭曲;解耦后衰减力度与梯度尺度无关。
为什么需要偏差校正(bias correction)?
为什么要把 weight decay 从自适应分母里解耦? 如果直接把
交互:AdamW vs SGD
损失面是个「峡谷」(y 方向比 x 方向陡 12 倍)。看两个优化器怎么下山。
SGD — 终点 loss 0.00054(60 步)
AdamW — 终点 loss 0.01160(60 步)
最优点 (0, 0)
$$m_t=\beta_1 m_{t-1}+(1-\beta_1)g_t,\quad v_t=\beta_2 v_{t-1}+(1-\beta_2)g_t^2$$ $$\theta_t=\theta_{t-1}-\eta\left(\frac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon}+\lambda\theta_{t-1}\right)$$
教学要点(红旗实验):把 lr 拉到 0.15 以上,SGD 会在陡峭方向剧烈震荡甚至发散, 而 AdamW 因为除以 √v̂ 自动缩小了陡峭方向的步长,依然稳定。 再把 β₂ 调到 0.5 —— AdamW 也开始抖了,这说明二阶动量的「记忆长度」才是它稳的原因。
在同一条病态二次损失"峡谷"上对比两条轨迹:SGD 在陡峭方向来回震荡,AdamW 按维度自适应缩放步长、更快对准谷底;把 weight decay 调大,观察 AdamW 的解耦衰减与 SGD 的 L2 等价写法何时分岔。
优化器谱系:SGD → AdamW 每一步补了什么
上文直接展示了 AdamW 的完整迭代。把整条演进链铺开看,每一步都在修上一步暴露的短板——这正是本课"演进链"的读法:先记住终点公式,再回看每一站为什么必须出现(谱系框架源自 Stanford CS229/230 VIP cheatsheets,Amidi & Amidi,2018–2019;数值惯例按现代实践校准,下节正则化谱系表同此归属与校准口径):
| 优化器 | 一步在做什么 | 上一步哪里不够 | 典型超参 |
|---|---|---|---|
| SGD | —(第3章的基准形态) | 学习率 | |
| SGD + Momentum | 速度累积: | 纯 SGD 在病态峡谷的两壁间反复震荡,同一有用方向上的梯度噪声不会相互抵消 | |
| RMSprop | 用梯度平方的滑动平均逐维缩放步长 | 动量修了方向、没修尺度:各维梯度量级悬殊时,统一 | |
| Adam | 一阶矩(动量,管方向)+ 二阶矩(RMSprop,管尺度)+ 偏差校正 | 单用哪一个都缺另一半;组合之后又引入新问题—— | |
| AdamW | weight decay 从梯度项解耦,直接按比例作用于参数本身 | Adam + L2 把衰减混进梯度,被自适应分母 | 同 Adam, |
现代默认:Transformer 系训练直接用 AdamW(第9章的 TinyGPT 训练循环即 torch.optim.AdamW,取
正则化谱系:四种手段与正常值
优化器管"怎么走",正则化管"别把训练集背下来"。本章已在 AdamW 处推导过 weight decay 的解耦形式,这里把整族手段排成一张表。正常值是工程约定的起点而非定律,换数据规模与任务时要在验证集上重调:
| 手段 | 机制一句话 | 正常值 / 工程约定 |
|---|---|---|
| L2 / weight decay | 惩罚参数平方和,把权重往小压(既有推导见上文 AdamW) | |
| L1 | 惩罚参数绝对值,诱导稀疏解 | LLM 训练基本不用(稀疏化诉求在推理侧另有专门手段);经典小模型场景量级 |
| Dropout | 训练时以概率 | 经典小网络 |
| Early stopping | 验证集指标不再改善就停止,保留泛化最好的检查点 | 与学习率调度是一对:调度管"每一步走多大",早停管"总共走多远";大模型预训练按 token 预算定死步数,早停主要用于微调与小规模训练 |
| 数据增强 | 人为扩充训练分布,抬高死记硬背的门槛 | NLP 的典型形态是回译(back-translation)与 EDA(同义替换/随机插入/交换/删除);本课不展开 |
混合精度训练深度解构:FP32 → FP16 → BF16 → FP8(大厂训练岗位必考点)
在个人电脑 CPU 上运行教学代码时,默认通常是单精度浮点数(float32,32 位,4 字节)。但在真实的千卡/万卡 GPU 集群训练大模型时,若全量使用 FP32,显存和显存带宽会瞬间爆满。**混合精度训练(Mixed Precision Training)**已成为当代大模型工业训练的标准基石。
| 浮点格式 | 总位数 | 符号位 (Sign) | 指数位 (Exponent) | 尾数位 (Mantissa) | 动态数值范围 | 相对精度 | 工业应用场景 |
|---|---|---|---|---|---|---|---|
| FP32 | 32-bit | 1 | 8 | 23 | 极高(基准) | 优化器状态主权重(Master Weights)、精确累加 | |
| FP16 | 16-bit | 1 | 5 | 10 | 中等(10-bit) | 早期训练(需配合 Loss Scaling 防下溢) | |
| BF16 | 16-bit | 1 | 8 | 7 | 适中(7-bit) | 现代大模型预训练绝对事实标准(与 FP32 动态范围一致,免去调参痛苦) | |
| FP8 (E4M3) | 8-bit | 1 | 4 | 3 | 3-bit 尾数 | 前向传播激活值(Activation)、模型权重矩阵(算力翻倍) | |
| FP8 (E5M2) | 8-bit | 1 | 5 | 2 | 2-bit 尾数 | 反向传播梯度(Gradients),更宽的动态范围防溢出 |
1. 为什么早期 FP16 必须使用动态 Loss Scaling?
FP16 的指数位只有 5 位,能够表达的最小正正规数约为
- Loss Scaling 解决方案:在反向传播前,将损失函数整体乘以一个缩放因子
(例如 ),由链式法则可知所有反向梯度都会同步放大 倍,安全挪入 FP16 的可表达安全区间; - 算完梯度后,在优化器更新前再除以
还原; - 如果某一步检测到出现
Inf或NaN(说明上溢),则跳过本步更新,并将减半(动态调节)。
2. 为什么 BF16 彻底改变了游戏规则?
Google Brain 提出的 Bfloat16(Brain Floating Point) 做出了极其精妙的权衡:将 8 位指数位完整保留(与 FP32 完全相同),仅仅牺牲了尾数精度(从 23 位降至 7 位)。这意味着:
- 动态范围与 FP32 100% 对齐:任何在 FP32 下不会溢出的梯度或激活值,在 BF16 下绝对不会发生指数级溢出或下溢;
- 无需动态 Loss Scaling 调度器:大幅简化了分布式训练链路的代码复杂度与工程不稳定因素,因此成为 LLaMA、DeepSeek、Qwen 等现代大模型预训练的统一标配。
阶段四:训练诊断——看懂梯度的体检报告
训练出问题不要只看 loss,要看梯度和激活的分布:
| 症状 | 体检信号 | 常见病因 | 修复层面 |
|---|---|---|---|
| 饱和/消失 | 激活大比例落在 tanh 平坦区(saturation fraction ≈ 1.0),梯度 RMS 小到 1e-8 | 初始化方差太大(→ 激活饱和)或太小(→ 梯度消失) | 按 fan-in 缩放初始化(Xavier/Kaiming);换激活 |
| 爆炸/非有限 | 梯度 RMS 飙到 1e3 量级,出现 NaN/Inf | 学习率过大、无归一化、无裁剪 | LayerNorm;梯度裁剪;降学习率 |
关键认知:初始化、normalization、学习率、梯度裁剪是四个不同层面的修复手段,对应不同病因,不能混用乱试。第9章会给训练循环接上这套遥测。
阶段五:动手实验
目标:从标量自动微分跨到张量反向——验证张量算子满足 shape 契约、LayerNorm 把每行特征归一到均值≈0/方差≈1、梯度范数在阈值内、optimizer 的 step 让参数真的移动。
环境准备
bash
cd <仓库根>
export PYTHONPATH="$PWD/python"
步骤
对一个小矩阵手算
XW+b、tanh/ReLU 和最后一轴 normalization,写出每个中间 shape。用有限差分对拍关键张量反向,记录最大绝对误差和相对误差。
对比不同初始化与学习率下的 activation/gradient 统计,不用一次 loss 下结论。
跑判分:
bashpython -m pytest python/tests/test_blocks_opt.py -q python -m pytest python/tests/test_transformer_contract.py -q python -m pytest python/tests/test_tensor_grad.py python/tests/test_diagnostics.py -qtextshape contract: 前向 shape 与反向梯度 shape 一致 grad norm: 1.0xx 处于阈值 [1e-3, 1e2] layernorm: 每行 mean≈0 var≈1,容差 1e-5 # 判定条件: # - 所有 shape 断言通过 # - 梯度范数不接近 0 也不溢出 # - LayerNorm 后行均值绝对值 < 1e-5、方差与 1 的偏差 < 1e-5
diagnostics.py 与 test_diagnostics.py 覆盖两类可观测训练失败:饱和/消失(saturation fraction 1.0、grad RMS 1e-8)与爆炸/非有限(grad RMS 1290.99…、non-finite count 1),证明诊断分类器可复现。
概念图:前向 → 反向 → 优化完整链路
故障注入与预期信号
| 注入 | 预期失败信号 | 修复后证据 |
|---|---|---|
| ReLU 负区导数写成 1 | gradcheck 在负输入处失败 | 分段有限差分通过 |
| AdamW 把 weight decay 混入梯度 | 参数范数和 loss 轨迹偏离 fixture | 固定 seed 的更新轨迹对拍 |
| LayerNorm 在 batch 维而不是特征维归一化 | 不同 batch size 下行为不一致,相当于把 batch 信息泄漏进单个样本 | 明确归一化轴为特征维,用 (B, F) 形状断言守住 |
LayerNorm 的 eps 取 0 | 输入某行方差恰好为 0 时出现 NaN | eps 设为 1e-5 量级,对 NaN/Inf 单独断言 |
| 权重初始化方差过大 | 前向激活饱和,反向梯度爆炸,grad norm 超阈值 | 初始化按 fan-in 缩放,diagnostics 加告警 |
| 广播导致 shape 静默错位 | 表面测试通过,但梯度与参数 shape 不匹配,下一次 step 立即报错 | 关键算子显式 assert shape == expected,禁用隐式广播 |
| 优化器 step 后没有同步到参数对象 | loss 不下降,看起来"卡在某个值" | step 之后显式回写,受控数据上验证 loss 单调下降 |
本章验收
- 自查清单全部能答"是":
- 不看资料,完成这四道闭卷解释题:
- 指出 linear、cross entropy 与 LayerNorm 的输入/输出/梯度 shape;任选一处广播,解释错误轴为何会让数值"看似能运行却语义错误"。
- 对比饱和/消失与爆炸/非有限梯度的信号,并说明初始化、normalization、学习率、裁剪分别修的是哪一层。
- 手算一步 SGD:
gradient_descent_step(5.0, 2.0, lr=0.1) = 4.8;解释 η=0.5 时为什么可能发散。 - 手算动量第一次更新(v₀=0, grad=2, β=0.9, η=0.01):为什么第一步等于 SGD,后续更新为什么带惯性?
- 写出 AdamW 的一阶矩
、二阶矩 、偏差校正 的完整迭代式;解释为什么 时 和 会偏向 0,以及除以 如何消除该偏差。
- 通过条件复核:统计轴、反向对拍、两类故障诊断和 clean-room shape contract 都有独立证据时,本章才能离开
gate。
论文与延伸
- Layer Normalization(Ba、Kiros、Hinton,2016)
- Root Mean Square Layer Normalization(Zhang、Sennrich,2019):去均值、只用 RMS 缩放的对照实现,第10章会把它当默认 Norm。
- Decoupled Weight Decay Regularization(Loshchilov、Hutter,2019)
- 选读:Batch Normalization,只读 §1–§3:训练态用 batch 统计、推理态用移动平均统计的分裂,是它不适合小 batch/变长序列的核心原因。
- 索引:必读论文
实验与参考
前端/Agent 迁移
shape contract 类似 TypeScript 类型契约:应在边界处失败,而不是让错误广播到最后。训练遥测类似状态机的 transition metrics——Agent 也要记录每次状态更新的输入、输出和不变量,避免只看最终文本。
资源 / 成本 / 隐私
小矩阵和 CPU/NumPy 足够完成本章对拍,预计 gross cost 为 0;不需要 API 或外部数据。日志只保留 shape、误差和计数,不保留用户输入。
Evidence
仓库当前机器证据(只读快照)
evidence/module-manifest-v1.json 中 06.evidence 指向当前文件:evidence/06-runtime-v1.json。这是当前 checkout 的脱敏机器运行记录,只覆盖该 JSON 记录的命令、指标、产物和已知失败;它不是学习者提交,也不能推出学习者已完成本章。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。
yaml
schema: learn-llm.evidence.v1
module: 06-tensor-stability
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 4
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_blocks_opt.py python/tests/test_tensor_grad.py -q
  - PYTHONPATH=python python -m pytest python/tests/test_transformer_contract.py -q
  - PYTHONPATH=python python -m pytest python/tests/test_diagnostics.py -q
metrics:
  - name: gradient_relative_error
    expected: <versioned-threshold>
    actual: <recorded-value>
  - name: non_finite_activation_count
    expected: 0
    actual: <recorded-value>
  - name: activation_saturation_fraction
    expected: 1.0 on saturation fixture
    actual: <recorded-value>
  - name: exploding_gradient_rms
    expected: '>=100 on exploding fixture'
    actual: <recorded-value>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
下一步
进入 第8章 · Attention 与 Transformer Block:用本章的 shape 与 Norm 手写 scaled dot-product attention 和完整 block。