
Appearance
第8章 · Attention 与 Transformer Block
前置要求:掌握 第7章 · 张量反传与训练稳定性 的张量形状对齐、RMSNorm 归一化与梯度校验规范。
第5章的 MLP 只能看固定长度的上下文,字符 token 之间还没有"互相看"的能力。本章补上现代 LLM 的心脏:注意力机制——让每个 token 动态决定"应该关注前面哪些 token、各看多少"。学完你将手写出一个完整的 decoder-only Transformer Block,这是 GPT 的基本单元。
本章目标
学完后你能做到:
- 从 Q/K/V 推导 scaled dot-product attention、causal mask 和多头拆分,并手算出每一步的 shape。
- 手写 pre-norm 残差、FFN 和最小 decoder-only Transformer Block;解释 sinusoidal / 学习式位置表示的区别。
- 用因果性、head reshape、消融和参考实现对拍证明每个边界,而不是只看输出形状。
阶段一:注意力在解决什么问题
读"那只动物没有过马路,因为它太累了"时,"它"指谁?你要回头看前面的名词,并且对不同名词给不同的关注权重。Bigram/MLP 做不到这一点——它们的上下文是死的。注意力机制的回答是:让每个位置自己算出来"该看谁"。
它把工作拆成三个角色,和查资料的过程一一对应:
| 角色 | 工程映射 | 物理职责 |
|---|---|---|
| Query(查询) | 检索查询向量 | 当前 token 发出的特征匹配探针 |
| Key(索引) | 索引特征向量 | 各候选 token 暴露的特征匹配键 |
| Value(内容) | 信息载荷向量 | 各候选 token 实际携带的表示向量 |
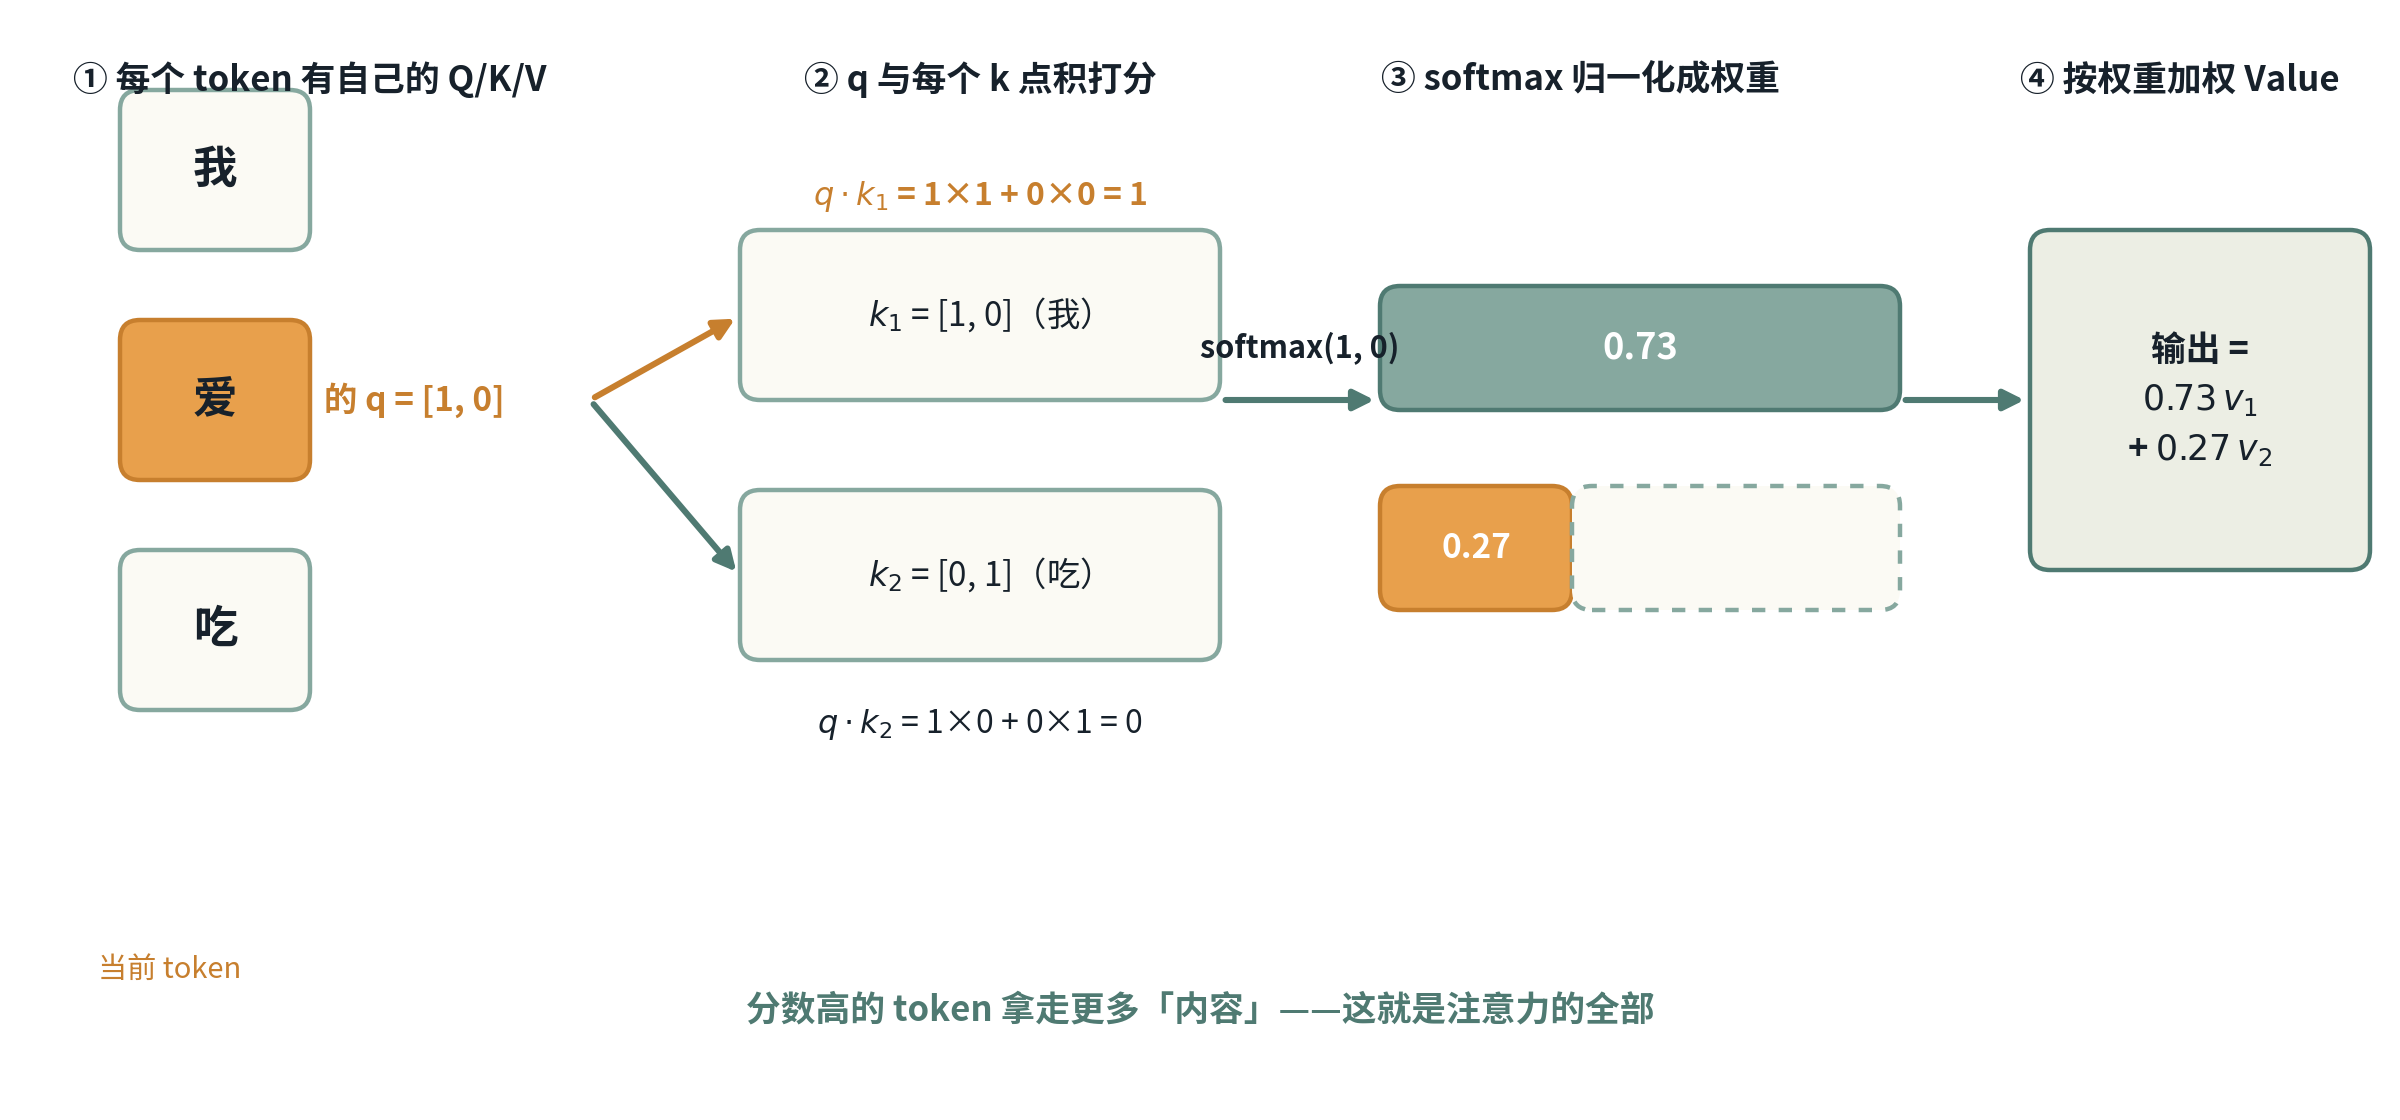
过程就三步:拿 Query 和每个 Key 比相似度 → 把相似度归一化成权重 → 按权重对所有 Value 加权求和。每个 token 的 Q、K、V 都由它自己的 embedding 乘三个不同的投影矩阵
阶段二:scaled dot-product attention 逐步算
TIP
注意力经典公式显微镜(高中数学逐字符解剖)
面对注意力公式
与 (行乘列点积): 的每一行是当前词的查询向量, 转置后每一列是候选词的特征向量。两个向量做点积(高中平面几何 ),得到 的方阵,第 行第 列的数字记录“第 个词对第 个词的初始匹配分”; (方差缩放,消解梯度饱和):高中的方差性质告诉我们,若两个独立随机变量均值为 0、方差为 1,它们在 个维度相乘累加后,方差会线性放大到 ,标准差膨胀为 。当 时打分会达到 ,让 Softmax 陷入极度极端的平坦饱和区(导数趋向于 0,网络停止学习)。除以 把方差强行拉回 1; (因果掩码 Causal Mask):在对角线上方(未来词)加上负无穷 (代码中用 -1e9)。初中数学:任何实数加上负无穷都等于负无穷;(按行归一化):对每一行独立做 Softmax。因为 ,右上角的未来位置被精确抹平为 0,左下角的历史位置变成概率和为 1 的权重分布; - 最后乘
(按权重提取内容):矩阵乘法本质是加权平均,每个 Query 按照刚才算出来的概率比例,从所有 Value 向量中把有用的信息加权抽取出来!
Raschka 五步阶梯教学法:从零演化注意力机制
Sebastian Raschka 在《从零构建大模型》(Build a Large Language Model from Scratch)第 3 章中提出,将注意力机制拆解为 5 步渐进阶梯,能最清晰地展现其从基础点积相似度到多头表征的演化全貌:
拆开逐个部分看。先算原始分数,再加 mask,最后 softmax:
mask 把未来位置设为
第一步:点积算相似度。 第3章的 dot_product 就是核心:
方向越一致点积越大——
第二步:除以
- 设 Query 向量
与 Key 向量 的各分量在初始化阶段近似为独立同分布(i.i.d.)的随机变量,满足零均值与单位方差: , ; - 考察点积标量
: - 均值:
; - 方差(由独立随机变量方差的可加性):
- 均值:
- 未缩放时的后果:点积的标准差为
。当隐层维度由 64 增加至 4096 时, 的标准差高达 64!若直接送入 Softmax,极大值分数的指数放大项 将迅速吞噬绝大部分概率质量,输出退化为极端的 one-hot 尖峰。Softmax 的导数公式为 ,当 或 时,导数乘积迅速趋向于 0,引发严重的梯度消失(Vanishing Gradient); - 除以
实现方差守恒: 无论注意力头维度 扩展多大,打分向量的标准差恒定锚定为 1,确保输入 Softmax 始终处于导数最灵敏的平滑线性区!在上述最小例子中, ,得分缩放为 。
第三步:加 mask。 语言模型预测下一个 token 时不许偷看未来。做法:把"未来位置"的得分加上
text
           Key:   "The"     "cat"     "sat"
Query:          ┌─────────┬─────────┬─────────┐
"The"           │  0.85   │  -inf   │  -inf   │  <-- 只能看自己
                ├─────────┼─────────┼─────────┤
"cat"           │  0.40   │  0.60   │  -inf   │  <-- 可以看 "The" 和 "cat"
                ├─────────┼─────────┼─────────┤
"sat"           │  0.10   │  0.75   │  0.15   │  <-- 重点关注主语 "cat" (0.75)
                └─────────┴─────────┴─────────┘
                      ▲
               下三角合法区,右上角因果遮罩 (-inf)
第四步:softmax 归一化。 对每一行(每个 query 对所有 key 的那一行)做 softmax,得到和为 1 的权重。上例:
第五步:加权求和 Value。 输出
前端类比:keys.map(k => dot(query, k) / sqrt(d_k)) 再 softmax 再加权求和 V——就是一次嵌套 map + reduce 的事。
shape 契约(必须能默写):
| 对象 | shape | 说明 |
|---|---|---|
hidden X | (B, T, D) | D = H × d_head |
| Q/K/V | (B, H, T, d_head) | head 拆分后保持 token 顺序 |
| score | (B, H, T, T) | 第三个轴是 query,第四个轴是 key |
| mask | (T, T) 或可广播形状 | 位置 i 只能看到 j ≤ i |
| attention output | (B, H, T, d_head) → (B, T, D) | concat 后过 output projection |
| block output | (B, T, D) | residual 不改变 shape |
阶段三:多头注意力——同时看好几种关系
一个 Query/Key 空间只能学一种"相似度"。但语言里要同时跟踪多种关系:主谓一致、指代、位置远近……多头注意力把
4D 张量变形全流程(彻底消灭维度盲区)
很多初级工程师在手写多头注意力时,往往卡在 view 和 transpose 上。我们用 TypeScript 类型契约的思维,把张量变形拆成像流水线一样清晰的步骤:
text
输入序列 X: [B, T, D]
    │
    ├─ 线性投影 Q = X @ W_q, K = X @ W_k, V = X @ W_v  ──> 形状仍是 [B, T, D]
    │
    ├─ 拆分多头 view(B, T, H, d_k)                     ──> 将特征维 D 拆为 H 个头,每头 d_k 维
    │
    ├─ 关键转置 transpose(1, 2)                         ──> 变为 [B, H, T, d_k]
    │   └─【为什么必须转置?】
    │      矩阵乘法 @ 默认只对最后两维生效!把 H 移到前面后,
    │      PyTorch 会将 [B, H] 视为批次前缀,并行计算每个头的 [T, d_k] @ [d_k, T] -> [T, T]
    │
    ├─ 点积打分 Q @ K.transpose(-2, -1) / sqrt(d_k)     ──> 形状 [B, H, T, T](每个头一张注意力图)
    │
    ├─ 叠加因果遮罩 Mask (未来位置填 -inf)             ──> 形状广播保持 [B, H, T, T]
    │
    ├─ Softmax(dim=-1)                                 ──> 得到归一化权重,每行和为 1
    │
    ├─ 权重加权 Value: Score @ V                        ──> [B, H, T, T] @ [B, H, T, d_k] -> [B, H, T, d_k]
    │
    ├─ 恢复序列顺序 transpose(1, 2)                     ──> [B, T, H, d_k]
    │
    ├─ 拼回大向量 contiguous().view(B, T, D)            ──> [B, T, D]
    │
    └─ 输出线性投影 out @ W_o                          ──> [B, T, D]
阶段四:组装 Transformer Block
注意力只是信息"横向流动"的一半;一个完整 block 还有纵向加工:
两个设计决策要知道"为什么":
- 残差连接(Residual Connection)的数学证明与直通车道: 何恺明在 ResNet(CVPR 2016 最佳论文)中奠定了恒等跳连的数学根基。设第
层输入为 ,经过非线性变换 后的输出为 。 展开到第 层,有 。 反向传播时根据链式法则对浅层 求导: 看懂这个惊艳的单位矩阵 :即使深层非线性变换的梯度 衰减为 0,因为括号内有恒等的单位阵 ,上游损失梯度 仍然能够无衰减地直通最浅层的 !没有残差连接,百层深度大模型在训练初期就会彻底梯度断流。 - Pre-LN vs Post-LN 稳定性权衡(大模型演进必考点):
- Post-LN(Vaswani 2017 原版 Transformer):
。归一化在残差相加之后。深层网络的期望梯度会随着层数增加而按指数级衰减,训练初期极度脆弱,必须配合极其漫长且小心翼翼的 Warmup 调度才能勉强收敛; - Pre-LN(GPT-2, LLaMA, DeepSeek 等现代 LLM 统一标配):
。归一化放在分支内部。主干残差流始终保持纯粹的加法直通,梯度方差严格有界,训练初期极其稳定,无需复杂的 Warmup 技巧即可直接稳定启动训练。
- Post-LN(Vaswani 2017 原版 Transformer):
- FFN(两层 MLP,
):注意力负责"token 之间交换信息",FFN 负责"每个 token 独立地深度加工"。第7章的 ReLU 就是最小激活选择。
Anthropic Transformer Circuits:解密黑盒内部的物理电路
Anthropic 团队(Chris Olah, Neel Nanda 等)在《A Mathematical Framework for Transformer Circuits》中提出了极具解释力的现代机制观,让我们无需把大模型当作玄学黑盒:
残差流作为通信总线(Residual Stream as Communication Bus):
- Transformer 骨架实质上是一条全局线性累加通信总线(类似于前端的 EventBus 或 Redux 全局 Store)。输入层初始化的 Embedding 向量沿着这条总线向前传递;
- 随后的每一个 Attention Block 和 FFN Block 并不覆盖总线内容,而是通过加法向总线“读取并写入增量信息”:
- 这种纯加法结构在数学上保障了梯度反向传播时有一条
的直通高速公路,使上百层的深度大模型永不出现梯度断崖消失。
QK 电路(去哪看) vs OV 电路(搬运什么):
- QK 电路(Query-Key Circuit):
和 决定 Token 之间在哪里寻址匹配,计算出两两之间的注意力图谱(Attention Pattern),解决“当前关注谁”的问题; - OV 电路(Output-Value Circuit):
和 决定当关注了目标 Token 后,提取其何种语义特征增量写回残差流通信总线,解决“把什么信息搬运过来”的问题。
- QK 电路(Query-Key Circuit):
归纳头(Induction Heads)与 In-Context Learning 的物理机制:
- 大模型在不更新权重的前提下,仅凭 Prompt 中的上下文示例(Few-shot / In-Context Learning)即可完成新任务,其核心物理机制可由归纳头(Induction Head)电路解释:
- Anthropic 证实这是由两层注意力构成的归纳头电路驱动的:
- 当输入出现
[A][B] ... [A]模式时; - 第 1 层的注意力头关注前一个 Token,将
[A]后面紧跟[B]的时序关系打标写进残差流; - 第 2 层的归纳头检索到前文曾出现过
[A],立即从残差流精准抓取后继的[B]并预测之。
- 当输入出现
- 这表明大模型的上下文学习并非黑盒现象,而是底层归纳电路对序列模式的精确物理表达。
几何表示拉扯视角:
- 每个词的静态 Embedding 只是高维语义空间中的一个基础坐标点(例如单独的
"model"既有机器学习模型的含义,也有时装模特的含义); - 自注意力机制在几何本质上是“根据上下文语义在概念子空间中动态拉扯向量方向”。若前文出现
"learning",注意力加权使得"model"向量向人工智能子空间偏转;若前文是"fashion",则向服装领域子空间偏转。
- 每个词的静态 Embedding 只是高维语义空间中的一个基础坐标点(例如单独的
本课只实现"从左往右预测下一个 token"的因果(decoder-only)Transformer;BERT 式双向编码留到读论文时对照即可。
论文精读破译器:《Attention Is All You Need》
当你阅读 Vaswani et al. (2017) 原文 Attention Is All You Need 时,你会遇到以下公式。看我们如何将其逐行映射为代码:
1. Section 3.2.1: Scaled Dot-Product Attention
论文原文公式 (1):
- 符号破译:
:所有 Query 和所有 Key 的两两点积匹配矩阵(代码: q @ k.transpose(-2, -1))。:缩放因子(代码: math.sqrt(d_k)),抵消高维点积方差膨胀,防止 Softmax 梯度消失。:将每一行的匹配分转换为非负且和为 1 的概率分布(代码: torch.softmax(scores, dim=-1))。:以注意力权重对内容矩阵 进行加权求和(代码: weights @ v)。
2. Section 3.2.2: Multi-Head Attention
论文原文公式 (2):
- 符号破译:
:每个头的独立投影矩阵。在高效实现中,我们不需要循环建 个小矩阵,而是用一个大矩阵 一次性投影,再用 view和transpose切割为多头!:将各头的输出在特征维拼接(代码: out.transpose(1, 2).contiguous().view(B, T, D))。:输出融合投影(代码: nn.Linear(D, D))。
3. Section 3.3: Position-wise Feed-Forward Networks
论文原文公式 (2):
符号破译:
:就是你在第7章学过的 ReLU 激活函数! :将特征维度放大 4 倍(扩展思考容量)。 :将扩展后的特征降维回 。这就是一个最标准的单隐层 MLP。
现代大模型的演进(从 GPT-2 到 LLaMA / DeepSeek):
- GPT-2 / GPT-3:将
换成了平滑门控的 GELU: - LLaMA / DeepSeek:全面舍弃偏置项(No Bias),换用第 7 章讲过的 SwiGLU 双线性门控:
由于多了一组权重投影矩阵,隐层维度通常设定为约 (例如 时隐层取 ),从而在参数量与标准 FFN 完全持平的前提下,获得更高的非线性模式拟合能力!
- GPT-2 / GPT-3:将
阶段五:位置从哪里来
到目前为止的注意力只看 token 内容:把输入序列打乱,
1. Sinusoidal(正弦位置编码,Attention Is All You Need):零新增参数,把位置
低频通道随位置缓慢变化、高频通道快速振荡,合起来像位置的"多进制计数"。它有一条可直接验证的代数性质:同一间距的内积与绝对位置无关,
仓库已有实现并被 python/tests/test_blocks_opt.py 覆盖,可直接对拍:
python
from llm_core.blocks import sinusoidal_positional_encoding

pe = sinusoidal_positional_encoding(seq_len=16, d_model=32)   # (16, 32)
d1 = [pe[p] @ pe[p + 1] for p in (0, 5, 10)]   # 间距 Δ=1,三个不同起点
d5 = [pe[p] @ pe[p + 5] for p in (0, 5, 10)]   # 间距 Δ=5
# 实测:d1 三个值均为 15.313649(spread < 2e-15),d5 均为 11.777383(spread 0)
# → 同距内积与起点无关;不同 Δ 给出不同值
2. 学习式位置编码(GPT-2 路线):直接学一个位置表
为什么本章的 block 验收暂时不含位置编码:本章要把 QKV、causal mask、residual 的契约隔离出来单独对拍,fixture 用互异 token——加入位置向量只会稀释"mask 写反、head 轴混淆"这类故障的信号。代价你要知道:没有位置编码的模型对顺序不敏感(mask 除外),这是刻意留白,不是遗漏。
衔接第9章与第10章:sinusoidal 的"内积只依赖间距"暗示了更彻底的现代做法——不把位置加进 embedding,而是直接旋转 Q/K,让相对位置成为注意力的内建几何性质。那就是现代 LLaMA / Qwen 标配的 RoPE(旋转位置编码):
TIP
几何直觉:为什么二维复数旋转能天然表达相对距离?
在二维平面上,若向量
交互观察
交互:因果 Attention 权重
用玩具向量演示「当前 token 该看谁」。真实模型里 Q/K/V 是学出来的。
完整权重矩阵(行=query,列=key)
the
cat
sat
the
1.0
cat
0.5
0.5
sat
0.3
0.3
0.3
把 query 位置移到句子中间,观察未来列始终为零权重。
交互:Softmax + Temperature
把 logits 看成「未归一化分数」。Temperature 越高分布越平,越低越尖。
用它解释缩放和温度如何改变权重尖锐度。
阶段六:动手实验
目标:用测试把注意力的三个核心性质钉死——每行 softmax 权重之和为 1;改动未来位置 token 不影响当前位置输出;多头拆分再拼回 shape 与语义不变。
环境准备
bash
cd <仓库根>
export PYTHONPATH="$PWD/python"
步骤
先实现单头 attention,输出 score、mask 后 score、softmax 权重和加权和,保存中间张量。
将
D拆成H × d_head,用小随机矩阵对拍 head reshape 前后的元素顺序。组装 pre-norm
x + Attention(Norm(x))和x + FFN(Norm(x)),明确每步 shape。运行:
bashpython -m pytest python/tests/test_attention_gpt.py -q python -m pytest python/tests/test_transformer_contract.py -q python -m pytest python/tests/test_attention_ablation.py -qtextattention 行权重之和 ≈ 1.0(atol=1e-6) 替换未来位置 token,当前位 logits 差值 < 1e-6 多头 reshape/permute 后拼回 shape == (B, T, n_embd)
固定合成 fixture 的实测消融值:causal prefix future perturbation 0.0、去 mask 后 10.799…、去 scale 最大权重差 0.281…、去 residual 最大输出差 1.732…——每个零件都被证明在起作用。
L3 clean-room 要求
本章的目标不是在现有模块上补几行代码。关闭参考实现后,从 clean_room/transformer_block.py 的冻结接口重写 QKV projection、causal attention、head 合并、pre-norm residual 和 FFN;不得导入课程参考实现。需要保留:shape 草图、一次 future-leak 或 head-axis 故障的"失败前/修复后"记录、与逐头参考的对拍。接口合同可先检查:
bash
pnpm clean-room:contract概念图:注意力全链路
阶段五:现代长上下文变体深探——滑动窗口注意力(SWA)与推理 Infra 的颠覆
在全量因果注意力中,每个 Token 必须与历史上的所有 Token 做点积打分。当序列长度从 4K 暴增到 32K、128K 乃至 1M 时,注意力矩阵的显存和计算复杂度呈平方级爆炸(
为了打破长文本的算力与显存桎梏,现代工业模型(如 Mistral、自研 MiMo 系列)广泛采用滑动窗口注意力(Sliding Window Attention, SWA)。它不单是一种算法层面的稀疏近似,更是底层推理系统(Inference Infra)的显存切除器与跨卡传输吞吐解放器。
1. 结构形式化:带状因果局部遮罩(Banded Causal Mask)
在 SWA 中,给定窗口大小
其因果掩码在几何上呈现为一条紧贴主对角线、宽度固定为
2. 感受野线性累加定理:局部注意力如何看到长文本?
你可能会产生直觉疑虑:如果每个 Token 只能看眼前
多层感受野堆叠效应给出了精妙的数学解答:
- 在第 1 层,Token
可以直接看到 范围的信息; - 在第 2 层,位于
的那个 Token 又看过了它前面 个 Token;通过残差流与第二层注意力的间接传递,Token 间接吸收了 的信息; - 推广到第
层,信息跨层传递使得顶层 Token 的**理论有效感受野(Effective Receptive Field)**达到:
以一个
text
Layer 3:  [Token i]
             ▲
             ├── 感受野扩展至 3W ──────┐
             ▼                          ▼
Layer 2:  [i-W] ──────────────────── [Token i]
             ▲                          ▲
             ├── 感受野扩展至 2W ──┐    ├── 局部窗口 W ──┐
             ▼                     ▼    ▼                ▼
Layer 1:  [i-2W] ─────────────── [i-W] ─────────────── [Token i]
3. 一线推理 Infra 视角:为什么 SWA 是大模型服务团队的王牌?
来自大厂大模型基础架构(AI Infra)团队的实战经验表明,SWA 在工程底层的价值远超其算法本身:
- 单请求 KV Cache 显存占用彻底封顶(
): - 在标准 Transformer 中,随着生成持续推进,单会话的 KV Cache 显存是无底洞式线性增长的(
); - 在 SWA 下,超出滑动窗口
的历史 Token 对应的 Key/Value 直接物理丢弃或覆写。单请求无论生成到 1 万字还是 10 万字,其单层 KV 显存开销被严格锁死在常数 !这使得单卡可并发的 Batch Size 大幅提升数倍。
- 在标准 Transformer 中,随着生成持续推进,单会话的 KV Cache 显存是无底洞式线性增长的(
- PD 分离跨机 RDMA 传输量断崖式下降:
- 在现代 PD 分离(Prefill-Decode Disaggregation)集群中,Prefill Worker 在计算完输入后,需要通过高速 RDMA 网络将生成的全量 KV Cache 传输给 Decode Worker;
- 对于普通全注意力模型,超长 Prompt 会导致网络上传输数 GB 的 KV 数据,RDMA 网卡瞬间被冲垮,传输延迟成为瓶颈;
- 而启用 SWA 的模型,Prefill Worker 仅需向 Decode Worker 传输最近
个 Token 的 KV Cache!跨机传输数据量被硬性封顶在数十兆字节以内,传输耗时稳定在微秒级,从根本上释放了集群跨节点互连带宽。
故障注入与预期信号
| 注入 | 预期失败信号 | 修复后证据 |
|---|---|---|
| residual 分支 shape 或顺序错误 | block 输出维度错或训练信号断裂 | residual/Norm contract 和消融报告 |
| 忘记除以 | softmax 输出趋近 one-hot、梯度消失 | 点积后立刻缩放,scale 消融对拍通过 |
| mask 加 0 而不是负无穷 | 未来位置概率非零、未来信息泄漏 | 遮罩位置填极小负值再相加,future-token 扰动差回到 0 |
| mask 上下三角写反 | 当前 token 被未来位置主导 | 因果遮罩取上三角为不可见区域,因果性测试通过 |
| 多头 reshape 时 head 与序列维混淆 | 拼回 shape 报错或注意力加权错位 | head 维先移到 batch 维再做 matmul,reshape 对拍通过 |
本章验收
- 自查清单全部能答"是":
- 不看资料,完成这五道闭卷解释题:
- 以
(B, T, D)为起点,逐步闭卷解释 Q/K/V、score、mask、softmax、head concat 和 output projection 的 shape;重点写出view(B, T, H, d_head) → transpose(1,2) → (B, H, T, d_head)这条多头拆分链,并解释为什么 transpose 必须在 matmul 之前(matmul 只作用于最后两维,把 H 移到 batch 前缀才能让每个头独立做[T,d_k] @ [d_k,T]);说明的作用。 - 解释 causal mask、residual、normalization 和 FFN 分别解决什么问题;为什么"未来扰动不改变 prefix"是必要但不充分的实现证据。
- 用
dot_product([1,2,3], [4,5,6]) = 32解释 attention score 的几何含义。 时两个随机向量的点积典型量级约为多少?不缩放时 softmax 的梯度会怎样? - 滑动窗口注意力(SWA)的核心推导:单层窗口大小为
,经过 层 Transformer 堆叠后,为什么顶层有效理论感受野能达到 ?在千卡/万卡 PD 分离集群推理中,为什么 SWA 能将跨节点 RDMA 网络传输量从 锁死在 ?
- 通过条件复核:中间张量、因果扰动、scale/mask/residual 消融和独立 clean-room 对拍都可追溯时,本章才能离开
gate。
论文与延伸
- Attention Is All You Need(Vaswani 等,2017)
- 选读:RMSNorm 的 Root Mean Square Layer Normalization。
实验与参考
- 关联概念:术语表 - attention / QKV / causal mask
- 论文依据:必读论文(Attention Is All You Need,arXiv:1706.03762)
前端/Agent 迁移
注意力是受上下文窗口约束的动态路由:每个 query 选择读哪些 key/value,类似组件依赖图中的加权读取,但它本身不保证可解释。Agent 的上下文组装应明确"可见消息集合"和"被禁止读取的未来/未授权状态"——这和 causal mask 是同一类边界。
资源 / 成本 / 隐私
小 batch 的 NumPy attention/Transformer 在本地 CPU 即可,预计 gross cost 为 0;浏览器交互不发第三方请求。只使用随机或合成 token,禁止把真实对话放入 fixture。
Evidence
仓库当前机器证据(只读快照)
evidence/module-manifest-v1.json 中 07.evidence 指向当前文件:evidence/07-runtime-v1.json。这是当前 checkout 的脱敏机器运行记录,只覆盖该 JSON 记录的命令、指标、产物和已知失败;它不是学习者提交,也不能推出学习者已完成本章。
补充的本地消融实现也记录在 python/llm_core/attention_ablation.py 和对应测试中;这些补充文件不改变 manifest 的 canonical evidence 指向。
学习者提交模板(待填写,不是当前机器证据)
复制下面模板并填写自己的真实运行结果。所有 <...> 都是未填写状态;actual 和 artifacts 尤其不能被当作已运行或已通过。artifacts 必须替换为本次提交中真实存在的仓库相对路径。
yaml
schema: learn-llm.evidence.v1
module: 07-attention-transformer
commit: <learner-commit-sha>
verified_at: <iso-date>
environment: <sanitized-python-device>
seed: 5
commands:
  - PYTHONPATH=python python -m pytest python/tests/test_attention_gpt.py -q
  - PYTHONPATH=python python -m pytest python/tests/test_transformer_contract.py -q
  - PYTHONPATH=python python -m pytest python/tests/test_attention_ablation.py -q
metrics:
  - name: future_token_invariance
    expected: <versioned-tolerance>
    actual: <recorded-value>
  - name: reference_output_max_error
    expected: <versioned-tolerance>
    actual: <recorded-value>
  - name: no_mask_future_prefix_influence
    expected: '>1e-5'
    actual: <recorded-value>
  - name: scale_ablation_max_weight_delta
    expected: '>0.01'
    actual: <recorded-value>
  - name: residual_ablation_max_output_delta
    expected: '>1e-5'
    actual: <recorded-value>
artifacts:
  - <learner-repo-relative-artifact-path>
cost:
  gross_usd: 0
  credit_usd: 0
licenses:
  - source: <source>
    version: <version>
    license: <license>
    attribution: <attribution>
    redistribution: <redistribution>
known_failures:
  - <sanitized-failure-or-none>
下一步
进入 第9章 · TinyGPT 预训练、恢复与生成:把本章的 block 装进训练循环,证明参数更新、loss 下降和 checkpoint 恢复。